


Le vibe coding est fiable pour accélérer un prototype, pas pour livrer les yeux fermés. Je vais montrer où il fait gagner du temps, où il trompe, et comment garder la main sur les tests, la robustesse et les choix techniques.
Pourquoi le prototype va plus vite ?
Le prototype va plus vite parce que le vibe coding réduit le délai entre l’idée et une première version testable. C’est sa vraie force. Sortir quelque chose de concret avant d’investir dans une architecture complète, une équipe, une stack définitive ou une grosse infra.
Je m’en sers comme un accélérateur de validation, pas comme une garantie de qualité. Chez des clients, je vois souvent le même blocage. Ce n’est pas toujours le code. C’est le temps perdu à transformer une idée floue en écran, en script, en workflow testable, bref en truc qu’on peut montrer à quelqu’un et critiquer.
Quelles commandes Git faut-il vraiment connaître ?
Le vibe coding est très utile pour valider vite des choses simples et visibles :
- Une interface pour voir si l’écran parle aux utilisateurs.
- Un parcours utilisateur pour repérer les étapes inutiles.
- Une logique métier simple, par exemple un calcul de prix ou un score.
- Un connecteur API, c’est-à-dire un point d’échange entre deux outils.
- Un formulaire, une automatisation interne ou un mini dashboard.
Ce que je ne valide pas trop tôt avec ça, c’est la sécurité, la montée en charge, la maintenabilité, les permissions complexes ou la dette technique. Là, il faut reprendre proprement. Sinon on confond maquette qui marche et logiciel solide.
Un exemple simple côté développeur. Je peux demander à l’IA de générer une petite API Node.js qui simule une fonctionnalité de devis. Le but, c’est d’apprendre, tester l’idée, brancher vite un écran dessus. Pas de partir en production tel quel.
const express = require("express");

const app = express();
app.use(express.json());

// Route de prototype pour simuler un devis simple
app.post("/api/quote", function (req, res) {
  const email = req.body.email;
  const users = Number(req.body.users);

  // Validation minimale pour éviter les données vides ou incohérentes
  if (!email || !email.includes("@")) {
    return res.status(400).json({
      success: false,
      error: "Email invalide"
    });
  }

  if (!users || users <= 0) {
    return res.status(400).json({
      success: false,
      error: "Nombre d'utilisateurs invalide"
    });
  }

  const monthlyPrice = users * 19;

  // Réponse JSON simple pour tester l'idée côté interface
  return res.json({
    success: true,
    email: email,
    users: users,
    monthlyPrice: monthlyPrice
  });
});

app.listen(3000, function () {
  console.log("Prototype API disponible sur http://localhost:3000");
});| Usage | Bon réflexe | Piège à éviter |
| Prototype d’interface | Tester la compréhension utilisateur. | Croire que l’UI est prête pour la prod. |
| API ou script rapide | Valider la logique métier. | Garder le code généré sans revue. |
| Automatisation interne | Mesurer le gain réel avant d’industrialiser. | Oublier les droits, logs et erreurs. |
Que change le langage naturel ?
Comment mieux coder avec Claude Code sans perdre de temps ?
Le langage naturel change la façon de coder parce qu’on part davantage de l’intention que de la syntaxe. Au lieu de tout écrire ligne par ligne dès le départ, je décris ce que je veux obtenir, je regarde ce que l’IA propose, puis j’affine par échange. C’est très utile pour aller vite sur un prototype, surtout quand le besoin est clair.
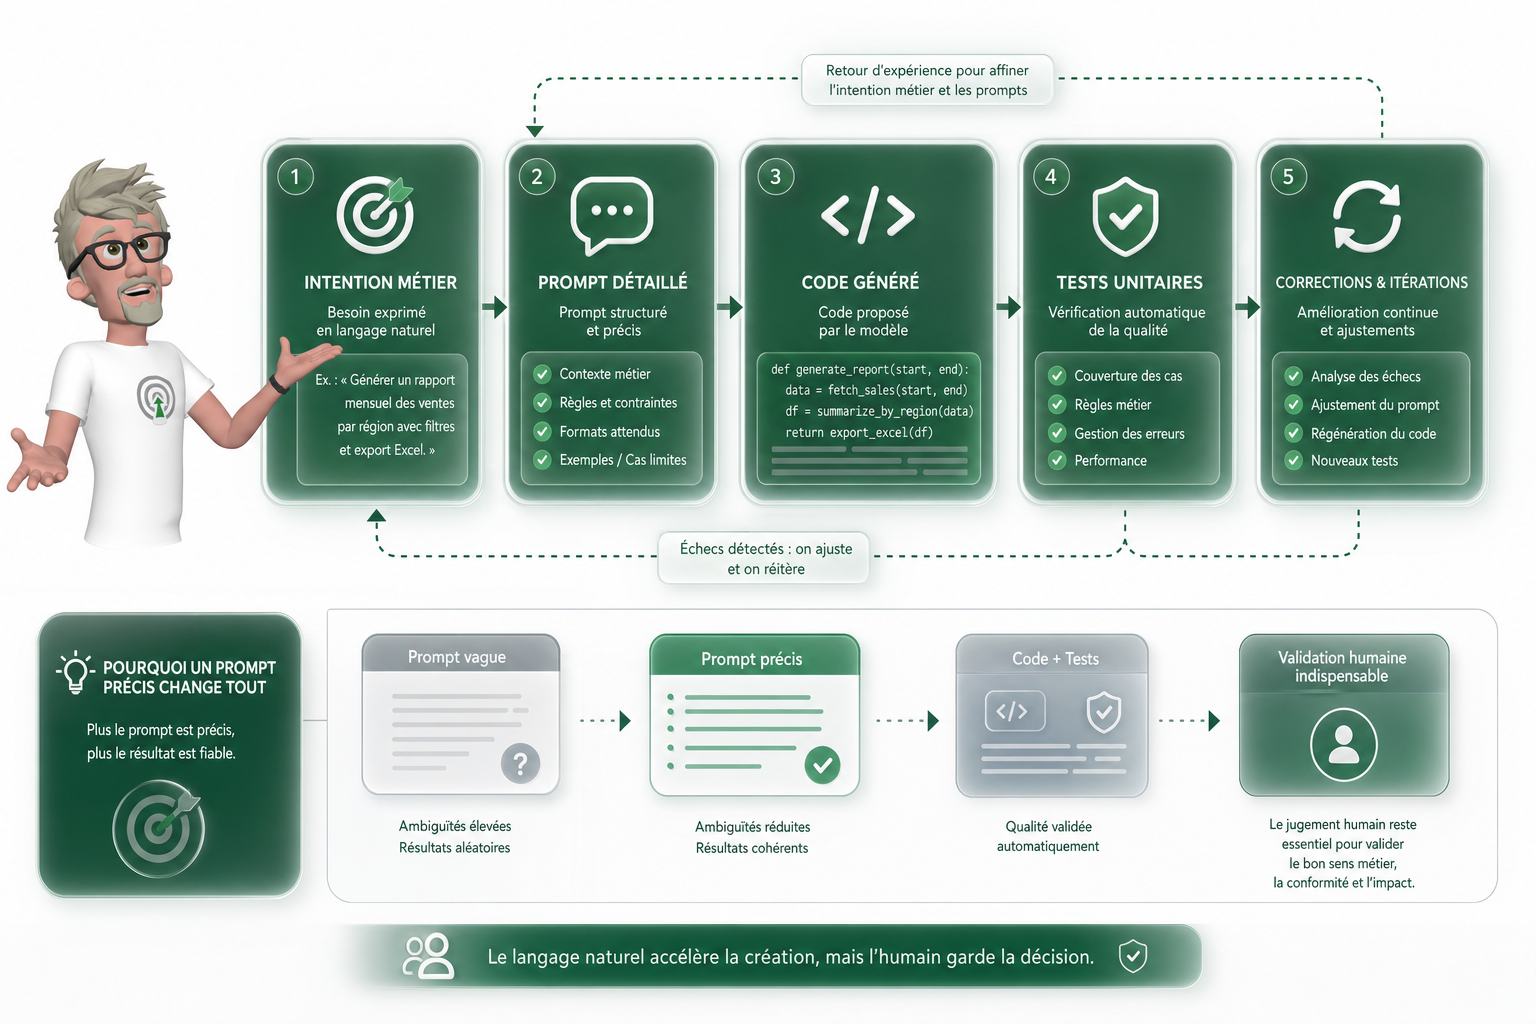
Mais ce n’est pas magique. Un prompt vague donne souvent un résultat vague. L’IA comble les trous comme elle peut, et parfois elle les comble mal. Un bon prompt ressemble presque à une mini spécification. Il donne le contexte, l’objectif, les contraintes, les entrées, les sorties, les erreurs attendues, le format de réponse et les tests à prévoir.
- Mauvais prompt : Crée-moi un script de validation.
- Bon prompt : Crée une fonction JavaScript validateForm qui valide un formulaire avec email, nom et consentement. L’email est obligatoire et doit avoir un format valide. Le nom est obligatoire et doit faire au moins 2 caractères. Le consentement doit être true. La fonction retourne un objet avec valid et errors. Les messages d’erreur doivent être lisibles par un utilisateur. Ajoute des commentaires et quelques tests unitaires simples sans dépendance externe.
Voilà le genre de résultat que j’attends quand l’intention est bien posée. Le code reste simple, lisible, et testable sans installer une librairie juste pour vérifier l’idée.
function validateForm(data) {
  // On prépare un objet d'erreurs lisible côté interface.
  const errors = {};

  // On vérifie que l'email existe et ressemble à un email.
  const emailRegex = /^S+@S+.S+$/;
  if (!data.email || !emailRegex.test(data.email)) {
    errors.email = "Veuillez saisir une adresse email valide.";
  }

  // On vérifie que le nom est présent et assez long.
  if (!data.name || data.name.trim().length < 2) {
    errors.name = "Veuillez saisir un nom d'au moins 2 caractères.";
  }

  // On vérifie que l'utilisateur a donné son consentement.
  if (data.consent !== true) {
    errors.consent = "Vous devez accepter les conditions pour continuer.";
  }

  return {
    valid: Object.keys(errors).length === 0,
    errors
  };
}

// Tests unitaires simples et lisibles.
function assertEqual(label, actual, expected) {
  const ok = JSON.stringify(actual) === JSON.stringify(expected);
  console.log(ok ? "OK - " + label : "Erreur - " + label);
}

assertEqual(
  "Formulaire valide",
  validateForm({ email: "test@mail.com", name: "Franck", consent: true }).valid,
  true
);

assertEqual(
  "Email invalide",
  validateForm({ email: "test", name: "Franck", consent: true }).errors.email,
  "Veuillez saisir une adresse email valide."
);

assertEqual(
  "Nom trop court",
  validateForm({ email: "test@mail.com", name: "F", consent: true }).errors.name,
  "Veuillez saisir un nom d'au moins 2 caractères."
);

assertEqual(
  "Consentement manquant",
  validateForm({ email: "test@mail.com", name: "Franck", consent: false }).errors.consent,
  "Vous devez accepter les conditions pour continuer."
);
Comment installer Python sur Windows facilement ?
Après génération, je ne valide jamais ça les yeux fermés. Je relis les cas limites, par exemple un email vide, un nom avec des espaces, un consentement absent. Je regarde aussi les messages d’erreur, les dépendances inutiles, la lisibilité, et surtout la cohérence métier. Chez un client, j’ai déjà vu une IA rendre un champ “optionnel” alors qu’il était obligatoire légalement. Le code était propre, mais faux.
Donc oui, comme dans le chapitre précédent, une meilleure intention donne un prototype plus utile, plus vite. Mais elle ne remplace pas la compréhension technique. Elle la rend juste plus productive.
Quelles tâches confier à l’IA ?
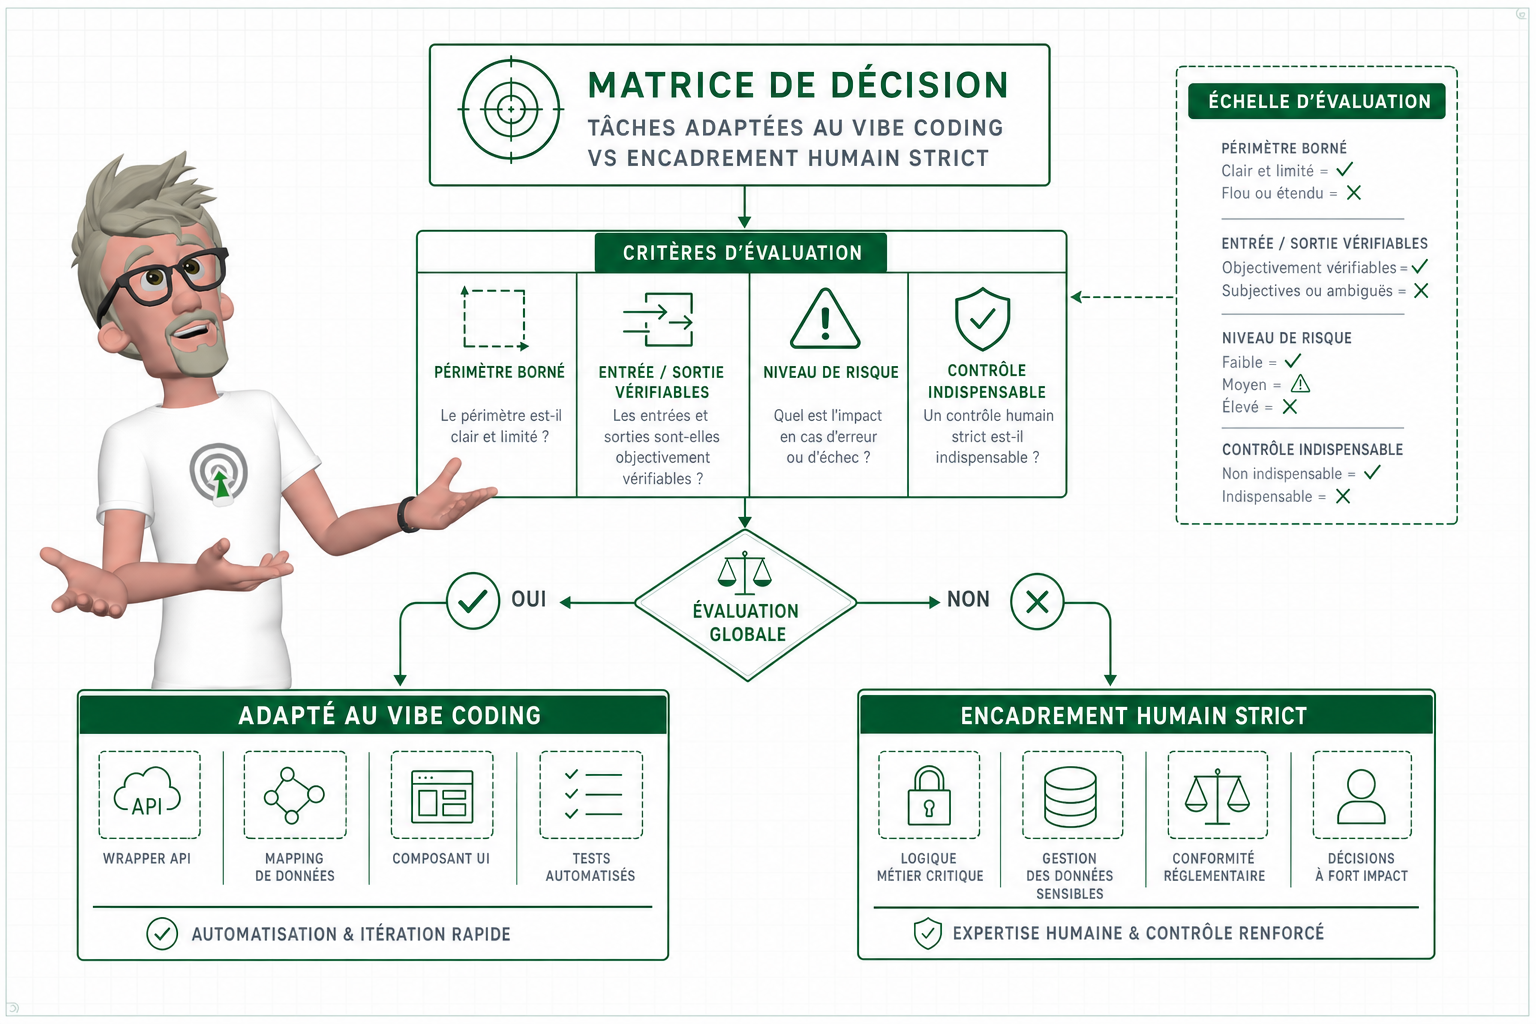
Les meilleures tâches à confier à l’IA sont les tâches bornées, répétitives et faciles à vérifier. Le vibe coding marche très bien pour du boilerplate, des wrappers, des validations, des scripts utilitaires, des composants simples, des transformations de données et des tests de base.
Comment faire l’orchestration de ressources Python ?
Là où je gagne vraiment du temps, c’est quand je peux décrire une entrée, une sortie, et quelques règles. Générer une structure de projet. Créer un connecteur API. Écrire des fonctions de mapping. Préparer des validations de champs. Créer un composant UI simple. Nettoyer un CSV. Transformer une réponse JSON. Générer des tests à partir d’un comportement attendu. C’est concret, relisible, et je peux vérifier vite.
Un bon exemple, c’est le wrapper API. Je l’utilise souvent avec des clients pour isoler les appels externes, éviter d’éparpiller du fetch partout, et garder une sortie propre côté application.
async function fetchCustomer(customerId) {
  // On valide l'entrée avant d'appeler l'API
  if (!customerId) {
    return { ok: false, error: "CUSTOMER_ID_REQUIRED", data: null };
  }

  try {
    const response = await fetch(`https://api.example.com/customers/${customerId}`, {
      headers: {
        "Accept": "application/json"
      }
    });

    // On gère les erreurs HTTP dans un format stable
    if (!response.ok) {
      return {
        ok: false,
        error: `HTTP_${response.status}`,
        data: null
      };
    }

    const customer = await response.json();

    // On renvoie seulement ce dont l'application a besoin
    return {
      ok: true,
      error: null,
      data: {
        id: customer.id,
        name: customer.name,
        email: customer.email
      }
    };
  } catch (error) {
    // On évite de casser l'application sur une erreur réseau
    return { ok: false, error: "NETWORK_ERROR", data: null };
  }
}
C’est un bon cas d’usage parce que le périmètre est clair. L’entrée est simple. La sortie attendue est stable. Les erreurs sont faciles à tester. Et si l’IA se trompe, je le vois vite.
À l’inverse, je l’encadre fortement sur tout ce qui touche à l’architecture critique, l’authentification sensible, les paiements, les droits utilisateurs complexes, la logique réglementaire, l’optimisation performance sans mesure, ou une migration de données sans contrôle humain. L’IA peut écrire du code très convaincant qui n’est pas correct. C’est même le piège principal.
| Tâche | Niveau d’adaptation au vibe coding | Contrôle indispensable |
| Wrapper API simple | Très bon | Tester les erreurs HTTP et le format de sortie |
| Mapping de données | Très bon | Comparer avec des exemples réels |
| Composant UI simple | Bon | Vérifier accessibilité et états limites |
| Tests de base | Bon | Relire les assertions |
| Authentification ou paiements | Faible | Revue humaine stricte et tests sécurité |
| Migration de données | Risqué | Sauvegarde, dry-run, validation métier |
Comment tester sans se mentir ?
On teste sans se mentir en traitant chaque sortie de l’IA comme une hypothèse, jamais comme une vérité. Le cycle utile du vibe coding, pour moi, c’est simple : prompt, exécution, correction, test, retour, puis nouveau prompt. La boucle marche bien quand elle reste ancrée dans le réel, pas quand on admire du code qui a juste l’air propre.
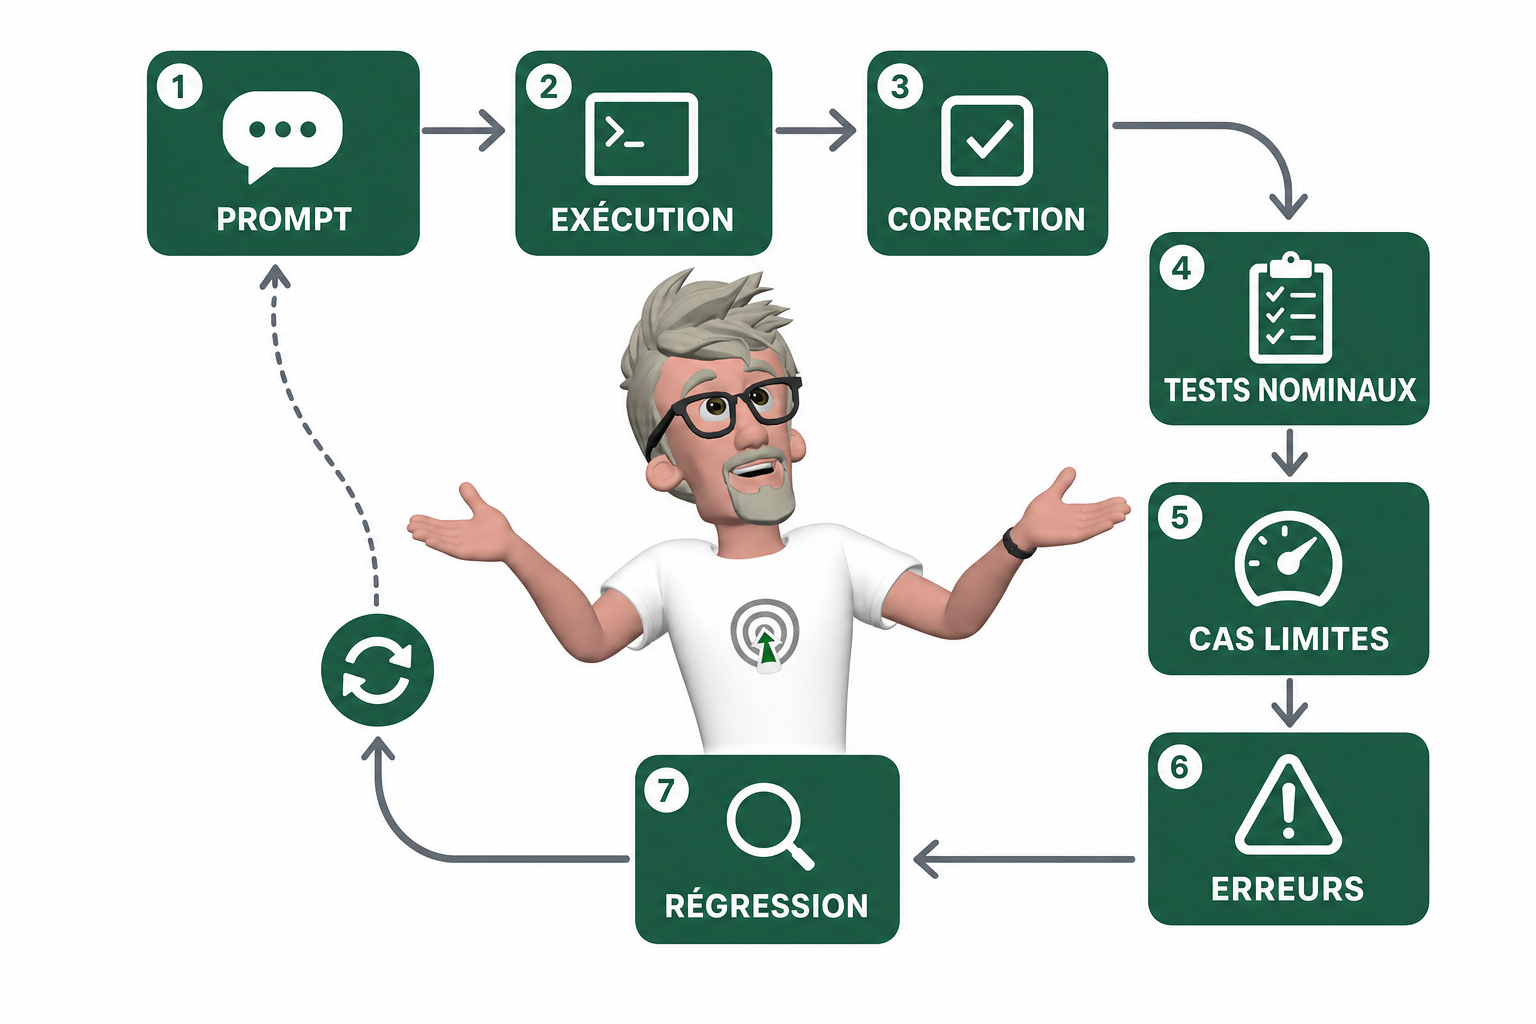
Le piège, c’est de confondre “ça marche une fois” avec “c’est fiable”. Un script peut passer avec un fichier CSV nickel et casser sur une ligne vide. Une API peut répondre avec un cas standard et exploser sur une erreur 500. Un formulaire peut accepter une valeur bizarre. Un composant peut être parfait en local et se vautrer avec les vraies données client. J’ai vu ça souvent, surtout sur des automatisations générées vite. La démo passe. La prod rappelle tout le monde à l’ordre.
Mon garde-fou minimal, ce n’est pas une usine à gaz. Je demande juste quatre choses :
- Des cas nominaux, quand tout se passe comme prévu.
- Des cas limites, avec des champs vides, trop longs, ou des valeurs étranges.
- Des cas d’erreur, pour vérifier que le système échoue proprement.
- Des tests de régression, pour éviter qu’une correction casse un comportement déjà validé.
Voilà le genre de petit bloc que je demande à l’IA de produire avec les tests. Après, je challenge les tests, parce que l’IA teste souvent ce qu’elle vient d’écrire, pas ce qui peut vraiment arriver.
// Fonction simple à tester
function createUser(input) {
  // On vérifie le champ obligatoire
  if (!input.email) {
    throw new Error("Email manquant");
  }

  // On vérifie un format minimum
  if (!input.email.includes("@")) {
    throw new Error("Email invalide");
  }

  return {
    email: input.email.toLowerCase(),
    role: input.role || "user"
  };
}

// Tests unitaires simples avec assert
const assert = require("assert");

// Cas normal
const user = createUser({ email: "TEST@demo.com", role: "admin" });
assert.strictEqual(user.email, "test@demo.com");
assert.strictEqual(user.role, "admin");

// Champ manquant
assert.throws(() => {
  createUser({ role: "admin" });
}, /Email manquant/);

// Valeur invalide
assert.throws(() => {
  createUser({ email: "pas-un-email" });
}, /Email invalide/);

// Erreur attendue avec rôle par défaut
const defaultUser = createUser({ email: "a@b.com" });
assert.strictEqual(defaultUser.role, "user");
Je compare toujours le comportement réel au comportement attendu. Pas à ce que l’IA raconte. Pas à ce que j’espère. À ce qui se passe vraiment.
Ça rejoint le point du chapitre précédent : plus une tâche est bornée, plus elle est testable, donc plus elle se prête bien au vibe coding. Si je ne peux pas tester facilement, je ralentis.
Où commence le vrai risque ?
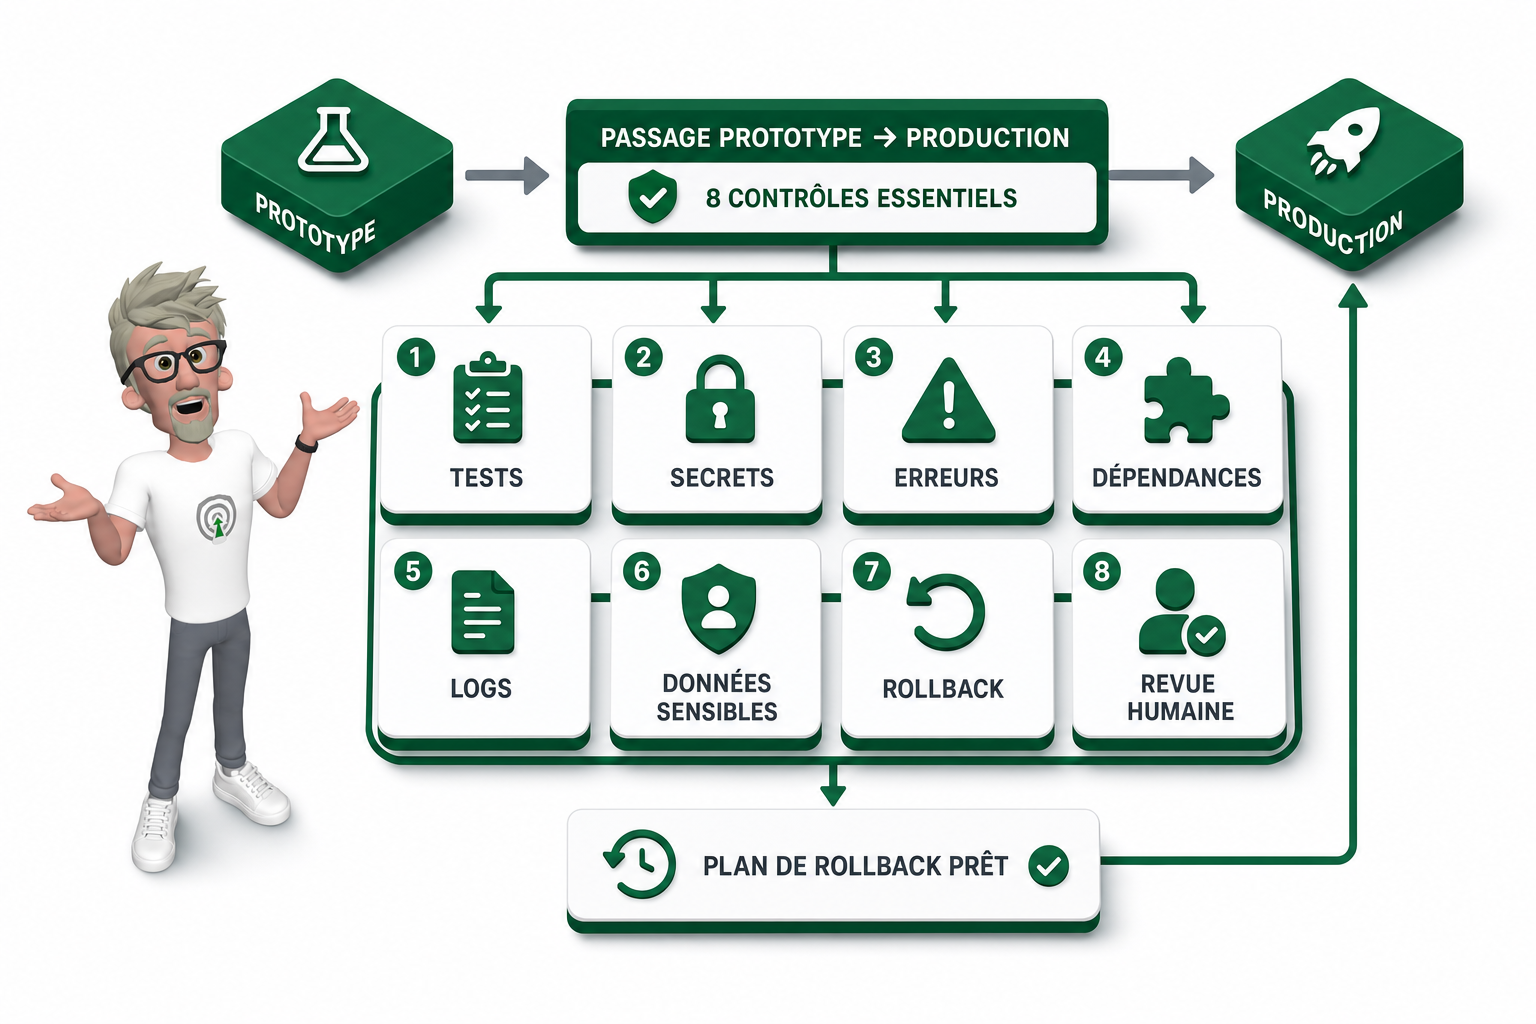
Le vrai risque commence quand on confond un code qui tourne avec un système prêt pour la production. C’est là que le vibe coding peut piéger, parce qu’il donne une portée technique énorme à des gens qui n’avaient pas forcément accès au code avant, mais il ne transmet pas automatiquement les réflexes de robustesse.
Je trouve ça très positif, vraiment. Un chef de projet peut créer un petit outil interne. Une personne en growth peut automatiser une analyse ou générer une landing page. Un data analyst peut produire un script utile sans attendre trois semaines de backlog. Une équipe ops peut maquettter un workflow. Un responsable métier peut tester une idée avant de mobiliser une équipe dev complète. Ça réduit les frictions internes, ça accélère l’innovation, et parfois ça débloque des sujets qui dormaient juste parce que personne n’avait le temps de les prendre.
Mais production, ça veut dire autre chose. Ça veut dire des logs, donc des traces utiles pour comprendre ce qui se passe. Ça veut dire du monitoring, donc savoir si le système tombe ou ralentit. Ça veut dire sécurité, gestion des erreurs, versioning, tests, documentation, droits d’accès, conformité, reprise après incident, maintenance. Le vibe coding peut aider à produire tout ça. Il peut écrire des tests, proposer une gestion d’erreur, générer une doc. Mais il ne décide pas à votre place ce qui est acceptable pour votre business.
Avant de pousser en production, j’applique au minimum cette checklist. Simple, mais elle évite beaucoup de mauvaises surprises.
- Tests passés : Les cas principaux et les cas limites ont été vérifiés.
- Secrets protégés : Aucune clé API, aucun mot de passe, aucun token n’est visible dans le code.
- Erreurs gérées : Le système sait quoi faire quand une API échoue ou qu’une donnée est absente.
- Dépendances identifiées : Les librairies, services externes et versions sont connus.
- Logs utiles : Les événements importants sont traçables sans exposer de données sensibles.
- Données sensibles contrôlées : Les données personnelles, clients ou financières sont protégées.
- Rollback possible : On peut revenir rapidement à une version stable.
- Revue humaine faite : Une personne compétente a relu le code et les choix techniques.
Sur les zones critiques, paiement, données clients, authentification, sécurité, conformité, une revue développeur reste indispensable. Pas pour ralentir tout le monde. Pour éviter qu’un prototype sympa devienne une dette technique ou un incident.
Le vibe coding est un excellent levier pour aller vite, apprendre et prototyper. Je l’utilise comme ça, et c’est très puissant. Il devient dangereux au moment où on lui délègue le jugement technique.
Alors, on l’utilise comment sans se brûler ?
J’utilise le vibe coding comme un accélérateur, pas comme un pilote automatique. Il est très fort pour passer vite d’une idée à un prototype, écrire du boilerplate, créer des scripts, générer des validations ou enrichir une boucle de test. Là où je reste prudent, c’est dès qu’on parle production, sécurité, architecture ou données sensibles. Le bon réflexe, c’est simple : je garde l’intention, je teste, je relis, je challenge. Si vous faites ça, vous gagnez du temps sans lâcher la qualité. Le bénéfice pour vous, c’est d’aller plus vite sans construire un château de cartes.
FAQ
- Qu’est-ce que le vibe coding exactement ?
Le vibe coding consiste à créer du code en dialoguant avec une IA, souvent à partir d’une intention exprimée en langage naturel. On décrit ce qu’on veut, l’IA propose du code, puis on teste, corrige et affine. Le point important, c’est que l’humain reste responsable du résultat. - Le vibe coding remplace-t-il un développeur ?
Non. Il peut accélérer certaines tâches, surtout les tâches cadrées et répétitives, mais il ne remplace pas le jugement technique. Un développeur sait évaluer la robustesse, la sécurité, l’architecture, les cas limites et la maintenabilité. C’est précisément là que le vibe coding peut être trompeur. - Peut-on utiliser le vibe coding en production ?
Oui, mais pas sans contrôle. Le code doit être relu, testé, documenté et surveillé comme n’importe quel autre code. Pour de la production, je vérifie au minimum les tests, les erreurs, les logs, les droits d’accès, les secrets, les dépendances et la possibilité de revenir en arrière. - Quelles tâches sont les plus adaptées au vibe coding ?
Les meilleurs cas sont les prototypes, le boilerplate, les wrappers API, les scripts simples, les validations, les composants basiques, les transformations de données et les tests unitaires. Plus le périmètre est clair et facile à vérifier, plus le vibe coding est utile. - Quel est le principal danger du vibe coding ?
Le principal danger, c’est de croire qu’un code qui fonctionne une fois est un code fiable. Il peut passer sur un cas simple et échouer sur les vrais cas métier, les erreurs, les volumes, les permissions ou les données sensibles. Le bon réflexe, c’est de tester et de relire avant de faire confiance.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent utiliser l’IA pour produire plus vite sans perdre le contrôle technique. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer vos usages IA, data ou automatisation proprement, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.