


Je réduis les tokens en structurant les consignes, en limitant les exemples et en ne transmettant que le contexte utile. Je détaille aussi comment réutiliser les préfixes, mesurer l’effet de chaque optimisation et séparer le brouillon de la réponse finale.
Comment condenser les consignes sans rien perdre ?
Je remplace les consignes verbeuses par des contraintes structurées, sans retirer celles qui déterminent le résultat. Une compression utile garde explicites le format, les règles et la sortie attendue.
Avant. « Analyse ce ticket de support. Détermine s’il concerne la facturation, un problème technique ou un compte. Évalue son urgence comme faible, moyenne ou élevée. Réponds uniquement au format JSON avec les champs category, urgency et rationale. Justifie brièvement la catégorie et l’urgence à partir du ticket. »
Quels dépôts GitHub pour les AI agent skills ?
Après. « Tâche : classer un ticket de support | Catégorie : facturation, technique ou compte | Urgence : faible, moyenne ou élevée | Sortie : JSON uniquement, champs category, urgency, rationale | Justification : brève, fondée sur le ticket »
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
La seconde version se parcourt plus vite : chaque contrainte est repérable séparément, sous forme de paire clé-valeur ou d’élément délimité par des barres verticales. Elle conserve la tâche, les choix autorisés, le format de sortie et la règle de justification. Le prompt est plus court, sans que je puisse en déduire un gain chiffré universel : le volume dépend notamment du modèle et de la formulation.
J’assemble les contraintes dans une liste, puis je vérifie que les éléments obligatoires figurent dans le prompt final. Ce contrôle détecte une omission de texte ; il ne garantit pas que le modèle respectera la consigne.
Comment réussir le harness engineering d’un agent ?
Ce code sert quand un prompt est généré dans une application ou un pipeline. La vérification échoue dès qu’une contrainte obligatoire manque.
contraintes = [
    "Tâche : classer un ticket de support",
    "Catégorie : facturation, technique ou compte",
    "Urgence : faible, moyenne ou élevée",
    "Sortie : JSON uniquement, champs category, urgency, rationale",
    "Justification : brève, fondée sur le ticket",
]

obligatoires = ["Tâche :", "Catégorie :", "Urgence :", "Sortie :"]

# Assemble le prompt avec des séparateurs lisibles.
prompt = " | ".join(contraintes)

# Vérifie que les sections essentielles n'ont pas été omises.
manquants = [element for element in obligatoires if element not in prompt]
if manquants:
    raise ValueError(f"Contraintes manquantes : {manquants}")
Je condense les répétitions et les formulations de politesse, pas les critères qui changent la réponse. Si le format, les règles ou le résultat attendu deviennent implicites, la compression dégrade la qualité au lieu d’économiser utilement des tokens.
| À conserver | La tâche, le format de sortie, les champs requis, les choix autorisés et les critères de décision. |
| À condenser | Les répétitions, les introductions inutiles et les explications qui reformulent une contrainte déjà explicite. |
| À vérifier | Que chaque contrainte essentielle reste présente et que le résultat attendu ne repose pas sur une interprétation implicite. |
Combien d’exemples few-shot faut-il garder ?
Le nombre nécessaire dépend de la tâche. Quelques exemples bien choisis suffisent souvent à fixer un format de sortie ou un comportement attendu, surtout si les consignes sont déjà structurées. J’ajoute des exemples seulement quand ils clarifient une ambiguïté réelle.
Comment classer des textes en few-shot avec Scikit-LLM ?
Au-delà de ce point, le gain devient souvent faible. Les exemples consomment des tokens et peuvent introduire des contradictions : formats différents, cas limites incompatibles, ou réponses qui ne suivent pas la consigne générale. J’ai déjà vu un modèle reproduire un détail accidentel d’un exemple plutôt que la règle commune aux cinq.
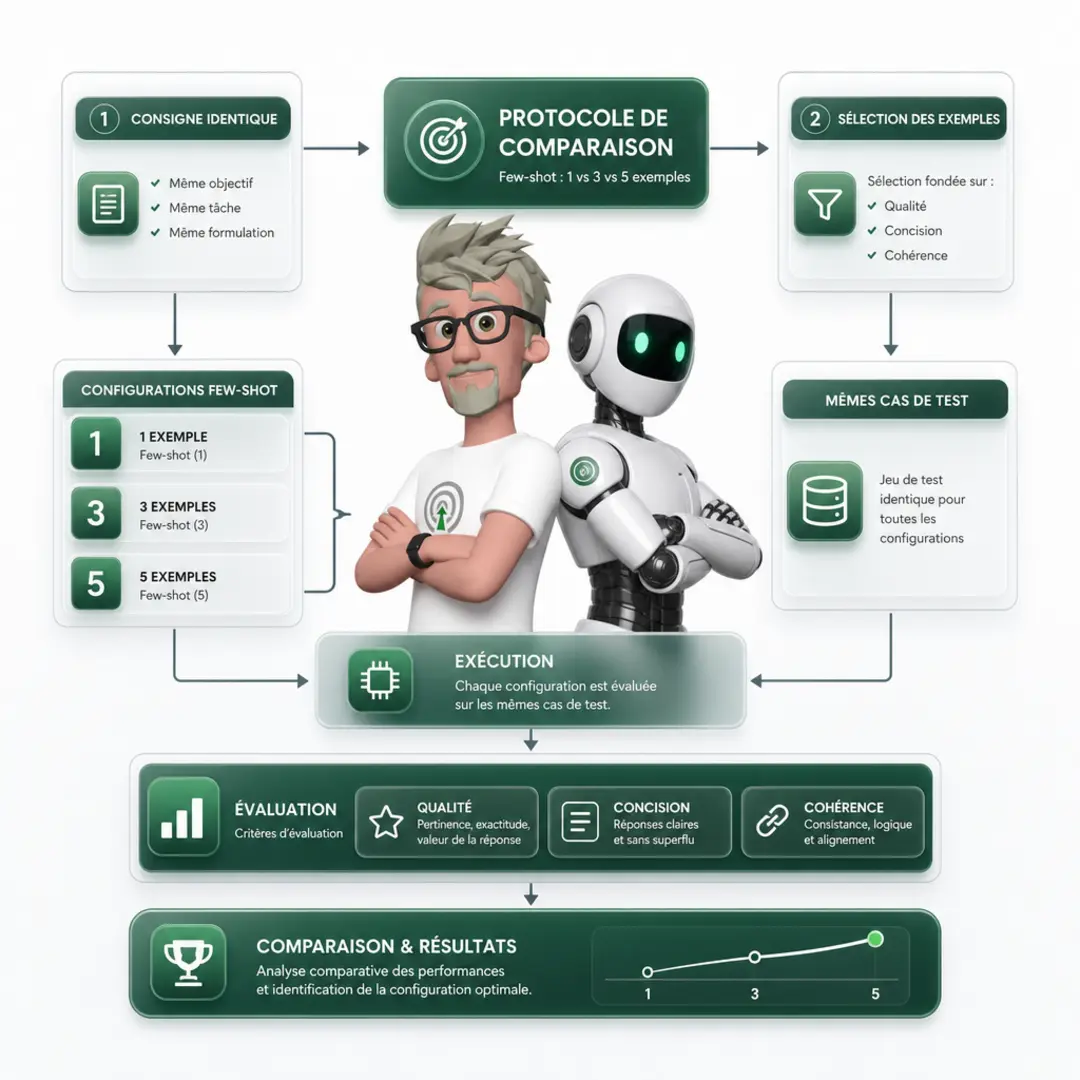
Je compare donc un, trois et cinq exemples en gardant la même consigne, les mêmes cas d’évaluation et les mêmes critères de sortie. Je retiens le jeu le plus court qui atteint le niveau attendu. Le nombre optimal dépend du problème : ce protocole sert à le mesurer, pas à imposer une valeur universelle.
Après avoir structuré les consignes, je peux générer les trois variantes de prompt avec le code suivant. Il prépare aussi le même lot de cas de test pour chaque variante ; l’évaluation du modèle peut ensuite comparer la conformité, l’exactitude et la stabilité.
# La consigne et les cas de test restent identiques pour chaque variante.
instruction = (
    "Classez le commentaire comme POSITIF ou NEGATIF. "
    "Répondez uniquement avec l'une de ces deux étiquettes."
)

examples = [
    ("Le produit fonctionne parfaitement.", "POSITIF"),
    ("La livraison a été rapide.", "POSITIF"),
    ("Le service client a résolu mon problème.", "POSITIF"),
    ("L'appareil est tombé en panne dès le premier jour.", "NEGATIF"),
    ("Je ne recommande pas ce service.", "NEGATIF"),
]

evaluation_cases = [
    "La qualité est excellente.",
    "Le colis est arrivé endommagé.",
    "Je suis satisfait du résultat.",
]

def build_prompt(example_count):
    # Construit un prompt avec le même préfixe et le nombre demandé d'exemples.
    selected = examples[:example_count]
    formatted = "n".join(
        f"Commentaire : {text}nÉtiquette : {label}"
        for text, label in selected
    )
    return f"{instruction}nn{formatted}nnCommentaire : {{input}}nÉtiquette :"

variants = {
    count: {
        "prompt": build_prompt(count),
        "evaluation_cases": evaluation_cases,
        "criteria": ["exactitude", "format", "stabilité"],
    }
    for count in (1, 3, 5)
}
Comment utiliser Gemini 4 Argon dans n8n ?
Je sélectionne la variante selon des résultats observables, pas selon la longueur qui paraît la plus complète.
| Critère | À vérifier |
| Qualité | Les réponses respectent les critères sur les mêmes cas de test. |
| Concision | Le jeu retenu est le plus court parmi ceux qui passent le seuil attendu. |
| Cohérence | Les exemples illustrent la même règle, sans formats ni comportements contradictoires. |
Comment extraire le contexte utile d’un long document ?
Je transmets au modèle les passages utiles à la question, pas le document complet. Ça réduit les tokens de contexte sans supprimer les informations pertinentes.
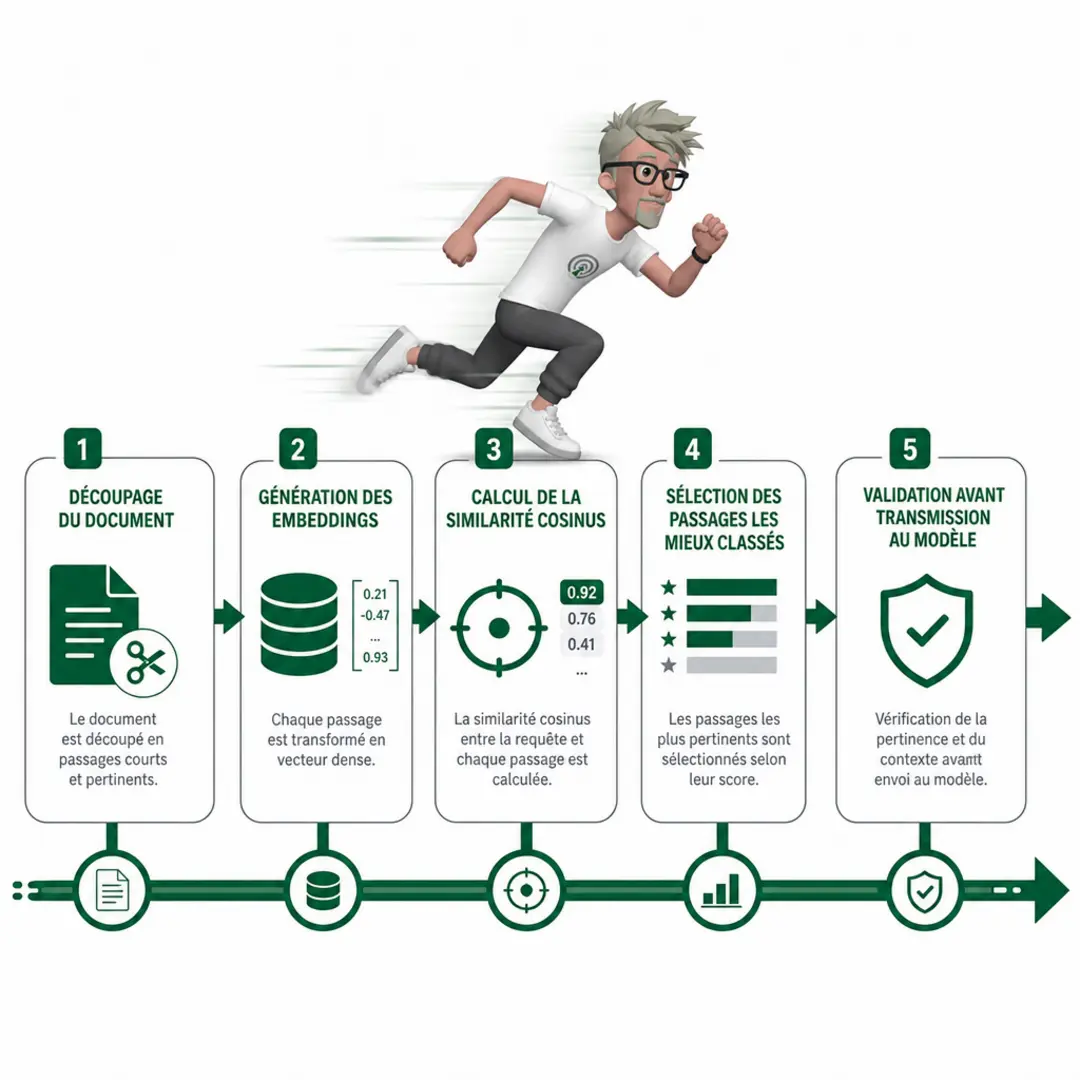
Je découpe d’abord le document en passages de taille maîtrisée. Un modèle Sentence Transformers transforme chaque passage et la question en embeddings : des vecteurs qui représentent leur sens. Je calcule ensuite la similarité cosinus entre la question et chaque passage, puis je sélectionne les mieux classés. Le classement aide à retrouver du contenu, mais ne garantit pas sa pertinence. Je vérifie les résultats sur des questions représentatives ; il n’existe pas de seuil universel.
Voici un exemple complet. Remplacez le contenu de document et de question par vos entrées. Ajustez max_words et top_k à votre budget de contexte et à vos tests.
import re
from sentence_transformers import SentenceTransformer
from sklearn.metrics.pairwise import cosine_similarity

# Collez ici le document à rechercher.
document = """Collez le texte long ici."""

# Saisissez ici la question à laquelle le modèle doit répondre.
question = "Quelle information précise recherchez-vous ?"

def split_into_passages(text, max_words=120):
    # Découpe approximativement en phrases, puis limite leur taille.
    sentences = re.split(r"(?<=[.!?])s+", text.strip())
    chunks = []

    for sentence in sentences:
        words = sentence.split()
        if len(words) > max_words:
            chunks.extend(
                " ".join(words[i:i + max_words])
                for i in range(0, len(words), max_words)
            )
        elif words:
            chunks.append(sentence)

    # Regroupe les phrases jusqu'à la taille maximale visée.
    passages, current = [], []
    for chunk in chunks:
        if current and len(" ".join(current + [chunk]).split()) > max_words:
            passages.append(" ".join(current))
            current = []
        current.append(chunk)

    if current:
        passages.append(" ".join(current))
    return passages

passages = split_into_passages(document)
if not passages:
    raise ValueError("Le document ne contient aucun passage exploitable.")

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
passage_vectors = model.encode(passages, normalize_embeddings=True)
question_vector = model.encode([question], normalize_embeddings=True)

# Le cosinus compare la direction des vecteurs, ici normalisés.
scores = cosine_similarity(question_vector, passage_vectors)[0]
top_k = min(4, len(passages))
ranked_indices = scores.argsort()[::-1][:top_k]

# La sélection suit le classement ; l'assemblage conserve l'ordre du document.
selected_indices = sorted(ranked_indices)
context = "nn".join(passages[i] for i in selected_indices)

print(context)
print([(i, float(scores[i])) for i in ranked_indices])
Après avoir réduit les consignes et les exemples, je réduis donc le contexte transmis. Je contrôle aussi les passages retenus : un score élevé ne remplace pas une validation métier, surtout si les formulations sont ambiguës ou le document mal structuré.
| Étape | Rôle |
| Découper | Créer des unités de recherche exploitables. |
| Encoder et classer | Repérer les passages proches de la question. |
| Sélectionner et vérifier | Réduire le contexte, puis confirmer sa pertinence. |
Comment réutiliser un préfixe de prompt ?
Je place les instructions réutilisées au début du prompt, puis le contexte et la question à la fin. Cette organisation conserve un préfixe identique d’un appel à l’autre, tout en isolant les données qui changent.
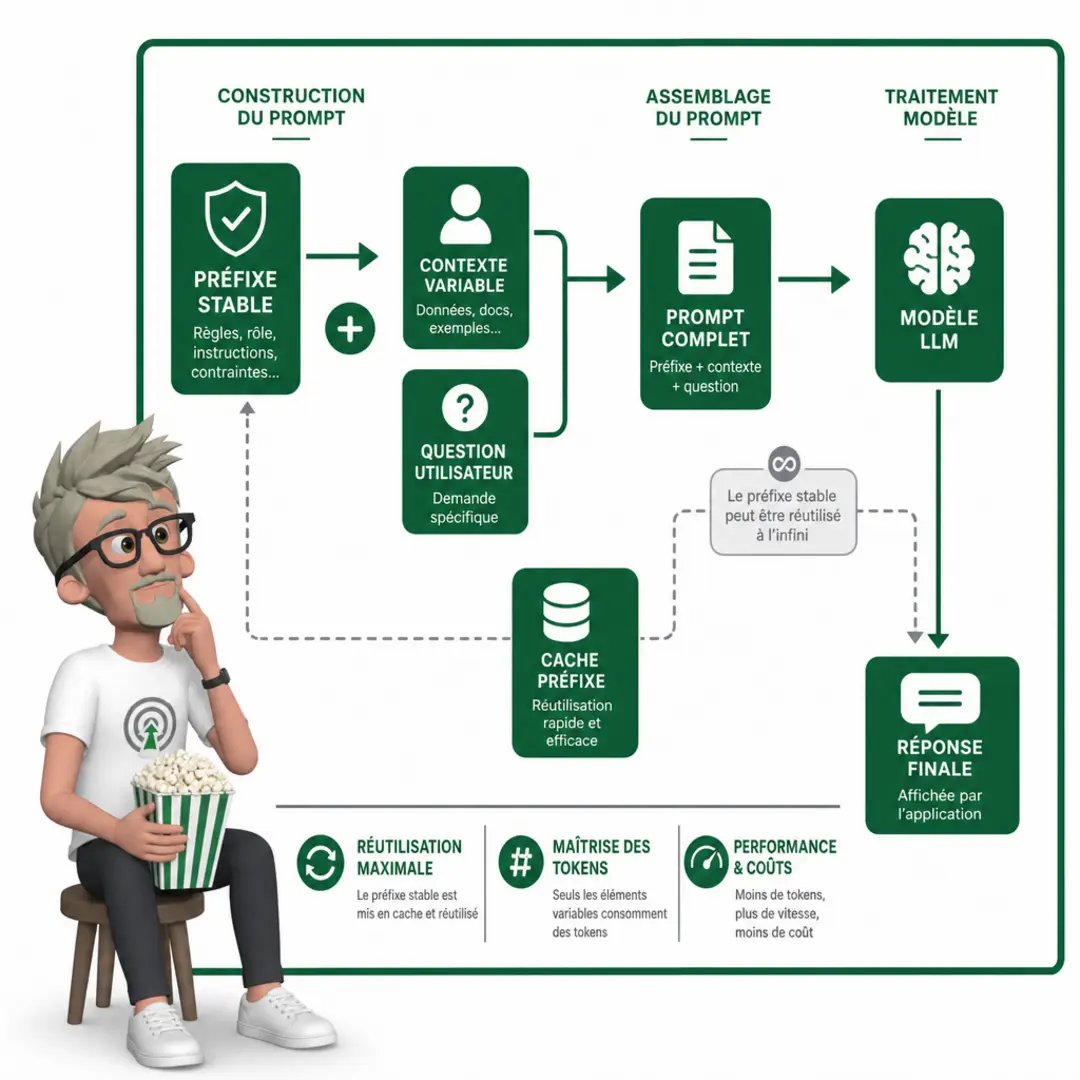
Je sépare donc les consignes système stables — rôle, règles de réponse, format attendu — du contenu dynamique : données du dossier, historique utile et demande de l’utilisateur. C’est cohérent avec la structure des prompts présentée précédemment : les règles générales restent distinctes des informations propres à chaque requête.
Des fournisseurs comme Anthropic proposent des mécanismes de cache de prompt. OpenAI dispose d’un cache automatique de préfixe. Le principe et les conditions d’éligibilité ne sont pas nécessairement identiques : ils dépendent du fournisseur, du modèle et de ses règles de mise en cache. Je vérifie toujours la documentation du service utilisé avant d’adapter la structure ou d’estimer un bénéfice.
Dans cet exemple, le préfixe réutilisable contient les instructions et le format de réponse. Le contexte et la question sont variables.
def construire_prompt(contexte, question):
    # Partie réutilisable : conserver ce texte identique entre les appels.
    prefixe_stable = (
        "Vous êtes un assistant spécialisé en analyse de données.n"
        "Répondez avec précision et signalez toute incertitude.n"
        "Format : réponse concise, puis éléments justificatifs."
    )

    # Parties variables : elles changent selon la requête.
    contexte_variable = f"Contexte :n{contexte}"
    question_variable = f"Question :n{question}"

    # Le contenu stable précède les éléments propres à la requête.
    prompt = (
        f"{prefixe_stable}nn"
        f"{contexte_variable}nn"
        f"{question_variable}"
    )

    return prompt
Je ne modifie pas les consignes stables pour y injecter des détails propres à une requête : cela rendrait le préfixe moins réutilisable. Je garde aussi à l’esprit qu’un cache ne remplace pas une réduction du contenu inutile. Un contexte trop long reste un contexte trop long.
Je récapitule la stabilité des composants :
| Composant | Stabilité |
| Instructions système et format attendu | Stable, placé au début |
| Contexte métier de la requête | Variable, placé après le préfixe |
| Question de l’utilisateur | Variable, placée à la fin |
Comment séparer le brouillon de la réponse finale ?
Je sépare le brouillon de travail de la réponse destinée à l’utilisateur avec deux champs structurés. Les traces détaillées étape par étape peuvent augmenter le nombre de tokens générés ; elles ne sont pas nécessaires dans la sortie affichée. Le format ci-dessous est un choix d’application, pas une syntaxe universelle.
Dans cet exemple, brouillon et reponse_finale sont les marqueurs retenus. Je demande une structure JSON, puis l’application extrait et affiche uniquement la réponse finale.
// Le format JSON et les noms de champs sont définis par l’application.
const prompt = `
Réponds avec un objet JSON contenant exactement ces deux champs :
- "brouillon" : notes de travail très courtes, sans raisonnement détaillé.
- "reponse_finale" : réponse concise, directement destinée à l’utilisateur.

Question : ${question}
`;

// callModel représente l’appel à votre fournisseur de modèle.
const raw = await callModel(prompt);
const result = JSON.parse(raw);

// Seul le champ final est transmis à l’interface utilisateur.
const answerForUser = result.reponse_finale;
document.querySelector("#answer").textContent = answerForUser;
La structure reste exploitable côté application, mais le brouillon n’est pas exposé. Si votre fournisseur accepte une sortie contrainte par schéma, utilisez-la pour fiabiliser le JSON ; les champs restent propres à votre intégration.
Les leviers précédents réduisent les tokens d’entrée. Celui-ci agit sur les tokens de sortie, en limitant ce que le modèle génère et ce que l’application affiche. Je vérifie la qualité après chaque optimisation : une réduction de tokens n’est utile que si la réponse reste exacte et complète.
Les cinq leviers se résument ainsi :
| 1. Réduire le contexte aux informations utiles. |
| 2. Raccourcir les instructions sans supprimer les contraintes. |
| 3. Retirer les répétitions et les éléments redondants. |
| 4. Limiter les exemples aux cas réellement nécessaires. |
| 5. Structurer la sortie et n’exposer que la réponse finale. |
Que gagne-t-on à optimiser ses prompts ?
Je réduis le volume d’un prompt en condensant les consignes, en gardant seulement les exemples utiles et en récupérant les passages pertinents plutôt qu’un document entier. Je place aussi les éléments réutilisés au début pour profiter, lorsque les conditions du fournisseur le permettent, du cache de préfixe. Enfin, je sépare le brouillon de la réponse finale pour maîtriser la sortie générée. Ces optimisations se valident sur la tâche réelle : comparez les résultats avec des critères constants et conservez la version la plus courte qui respecte vos exigences. Vous réduisez ainsi les tokens sans sacrifier la qualité attendue.
FAQ
-
Comment réduire les tokens d’un prompt sans dégrader la réponse ?
Je structure les consignes, limite les exemples au nombre utile et ne transmets que les passages pertinents. Je vérifie ensuite que la réponse respecte toujours les mêmes critères. -
Combien d’exemples few-shot faut-il utiliser ?
Il n’existe pas de nombre universel. Comparez les résultats avec un, trois et cinq exemples, puis gardez le jeu le plus court qui établit correctement le format ou le comportement attendu. -
Comment sélectionner les passages utiles dans un document ?
Découpez le document en passages, encodez-les avec des embeddings, puis classez-les selon leur similarité cosinus avec la question. Transmettez les passages les mieux classés au modèle. -
Le cache de prompt fonctionne-t-il de la même façon chez tous les fournisseurs ?
Non. Les mécanismes et leurs conditions dépendent du fournisseur. Placez les éléments stables au début du prompt et vérifiez les règles applicables au service utilisé. -
Pourquoi séparer le brouillon de la réponse finale ?
Les traces de raisonnement détaillées peuvent augmenter le nombre de tokens générés. Des marqueurs de sortie structurés permettent de distinguer le brouillon du contenu final destiné à l’utilisateur.
A propos de l’auteur
Franck Scandolera est expert en data engineering et en automatisation IA. Il conçoit des workflows agentiques et des applications métier intelligentes, avec une attention particulière à la maîtrise des prompts, du contexte et des coûts d’exécution.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.