


Le bon modèle local dépend de vos tâches, de votre matériel et de vos exigences de confidentialité. Voici comment départager cinq options pour le dialogue, le code, le multimodal ou les appareils contraints, puis les lancer avec Ollama sans confondre exécution locale et confidentialité garantie.
Comment choisir un modèle d’IA local ?
Le choix dépend d’abord des tâches à couvrir, des ressources matérielles disponibles et du niveau de confidentialité attendu. Le modèle le plus adapté n’est pas forcément le plus polyvalent : un modèle spécialisé peut être plus rapide, plus fiable et moins coûteux à faire tourner localement.
Je compare les modèles selon des critères liés à votre usage réel :
- Dialogue et rédaction : qualité des réponses, respect des consignes, capacité à traiter un contexte long et à rédiger dans le ton attendu.
- Génération de code : langages maîtrisés, qualité du débogage, compréhension d’un dépôt de code et respect des contraintes techniques.
- Traitement de documents : capacité à résumer, extraire des informations et répondre à partir de fichiers. Pour les documents longs, la taille du contexte compte autant que la taille du modèle.
- Multimodalité : traitement d’images, d’audio ou de vidéo. Ces capacités varient selon les modèles et peuvent demander davantage de mémoire et de puissance de calcul.
- Taille et latence : un modèle plus grand peut produire de meilleures réponses, mais il est souvent plus lent et plus exigeant en mémoire. La latence, c’est le délai avant l’obtention d’une réponse.
Combien coûte DeepSeek Harness à l’usage ?
La confidentialité doit aussi être évaluée concrètement. Une exécution locale limite l’envoi des données à un service externe, mais elle ne garantit pas à elle seule la sécurité : les fichiers, les journaux et les accès à la machine restent à maîtriser.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Les capacités annoncées doivent être vérifiées sur vos tâches réelles, avec vos documents, vos prompts et vos critères de qualité. Les noms des modèles ne suffisent pas à estimer les besoins matériels : la quantification, c’est-à-dire la réduction de précision des poids du modèle, le moteur d’inférence et le contexte demandé modifient aussi la consommation de mémoire et les performances.
Je compare ensuite cinq modèles sur ces critères, pour distinguer ceux qui conviennent à un usage général, au code, aux documents ou aux configurations matérielles plus limitées.
Quel modèle convient à vos usages ?
Comment réduire les tokens d’un prompt sans perdre en qualité ?
Chaque modèle de cette sélection se distingue par ses usages. Comparez-les sur vos propres tâches : un résultat utile en dialogue ne garantit rien sur l’extraction ou le code.
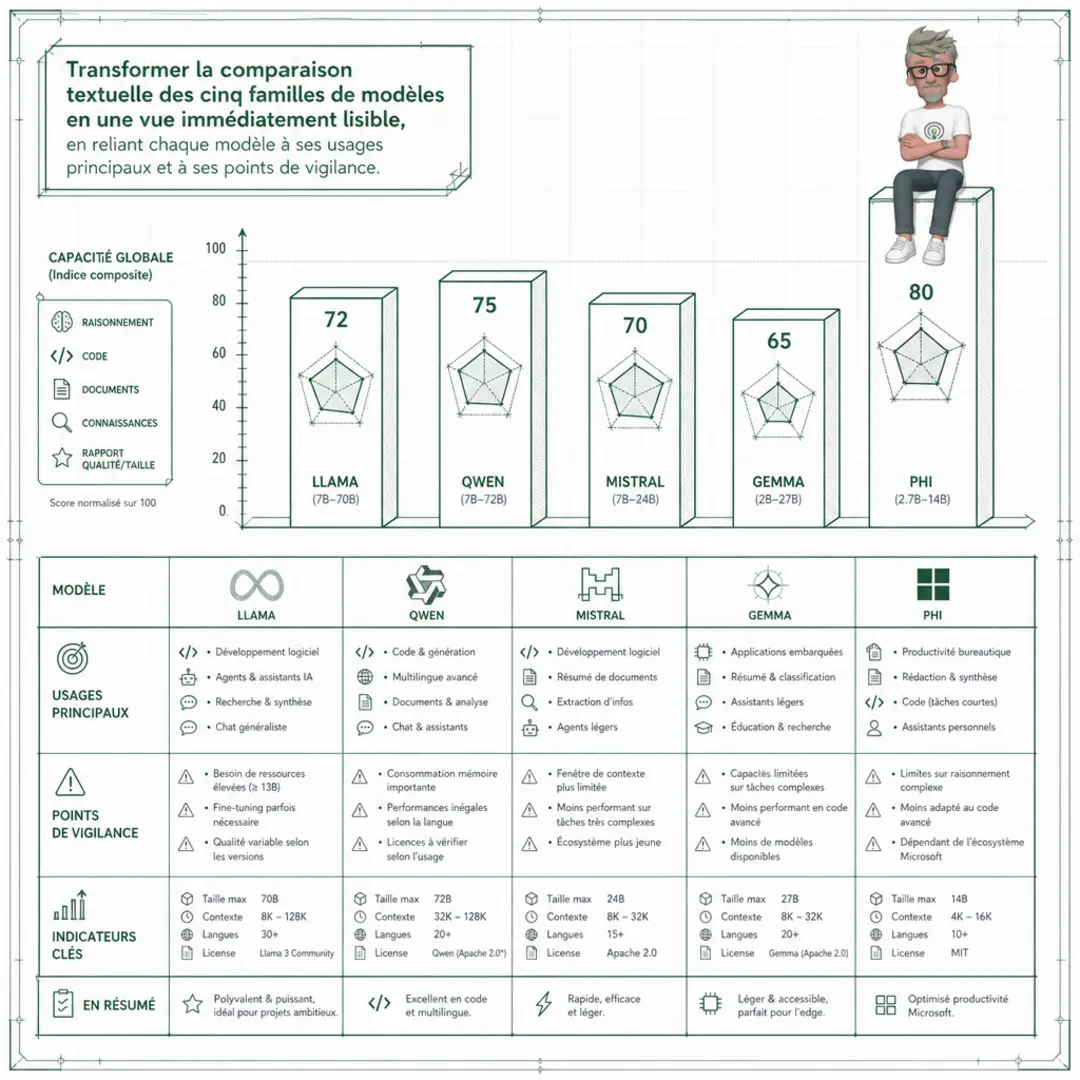
- Llama 3.1 8B Instruct est polyvalent pour le dialogue, le résumé, la classification et les projets de fine-tuning, c’est-à-dire l’adaptation d’un modèle à des données ou tâches spécifiques. Il est textuel et bénéficie d’un vaste écosystème. Sa licence communautaire de Meta impose des conditions à vérifier avant toute redistribution ou tout déploiement.
- Qwen2.5 7B Instruct convient aux conversations multilingues, au traitement de documents et aux sorties structurées. Qwen2.5 Coder sert à générer, expliquer et corriger du code. Les deux sont textuels.
- Mistral 7B Instruct v0.3 vise la rédaction, la reformulation, les résumés, la documentation et le dialogue. Il prend en charge l’appel de fonctions, qui permet au modèle de déclencher des outils via une interface définie. Sa licence est Apache 2.0. Je le comparerais à des modèles plus récents sur vos tâches réelles : son nom ne suffit pas à prédire le meilleur choix.
- Gemma 4 E2B et E4B sont multimodaux : ils traitent du texte, des images et de l’audio, puis génèrent du texte. E2B compte environ 5,1 milliards de paramètres et E4B environ 8 milliards, embeddings compris.
- Phi-4-mini-instruct est un modèle textuel de 3,8 milliards de paramètres, adapté aux appareils limités en mémoire et aux applications sensibles à la latence. Testez-le pour des assistants compacts, l’extraction, les mathématiques, la logique et les appels de fonctions. Les autres modèles Phi-4 aux noms proches sont distincts.
| Modèle | Spécialité | Point de vigilance |
| Llama 3.1 8B Instruct | Dialogue, résumé, classification, fine-tuning | Vérifier les conditions de la licence communautaire de Meta |
| Qwen2.5 7B Instruct | Conversations multilingues, documents, sorties structurées | Modèle textuel |
| Qwen2.5 Coder | Génération, explication et correction de code | Modèle textuel |
| Mistral 7B Instruct v0.3 | Rédaction, résumés, documentation, dialogue et appel de fonctions | À comparer à des modèles plus récents sur des tâches réelles |
| Gemma 4 E2B / E4B | Traitement du texte, des images et de l’audio ; génération de texte | Environ 5,1 / 8 milliards de paramètres, embeddings compris |
| Phi-4-mini-instruct | Assistant compact, extraction, mathématiques, logique, appels de fonctions | Les autres modèles Phi-4 sont distincts |
Quel matériel faut-il pour les exécuter ?
Les besoins matériels ne se déduisent pas du seul nom d’une variante. Avant de télécharger un modèle, je vérifie la taille du fichier réellement proposé et les capacités de la machine qui l’exécutera. La taille du fichier ne correspond pas directement à la mémoire nécessaire en cours d’utilisation.
Pour Gemma 4 E2B et E4B, les tailles indiquées incluent les embeddings, c’est-à-dire les représentations numériques utilisées par le modèle pour traiter les mots et les éléments d’entrée. Elles donnent un repère pour comparer les variantes, mais ne suffisent pas à garantir qu’un modèle fonctionnera correctement sur une configuration donnée. Le format et la quantification — la réduction de précision des poids pour diminuer la taille du modèle — peuvent aussi modifier les besoins.
Quels dépôts GitHub pour les AI agent skills ?
Je prends en compte plusieurs éléments avant de choisir :
- La mémoire disponible sur la machine, notamment la mémoire graphique si le modèle doit être exécuté sur le GPU.
- La taille de l’artefact proposé au téléchargement, en vérifiant qu’il correspond bien à la variante et au format visés.
- Le type de tâches et le temps de réponse attendu. Une machine peut charger un modèle sans offrir une expérience suffisamment réactive.
Phi-4-mini-instruct est conçu pour les appareils limités en mémoire et les usages sensibles à la latence. C’est une piste pertinente quand les ressources sont contraintes, pas une garantie de compatibilité avec toute machine. Les besoins réels dépendent aussi des entrées, de la longueur des réponses et du contexte utilisé.
Je teste donc le modèle sur le matériel et les tâches ciblés avant de le retenir. Un essai court permet de vérifier le chargement, la qualité des réponses et la réactivité dans des conditions proches de l’usage réel. Une fois la variante validée, je peux la lancer avec Ollama et mesurer son comportement sur votre environnement.
Comment lancer un modèle avec Ollama ?
Comment réussir le harness engineering d’un agent ?
Ollama permet d’installer et d’exécuter des modèles depuis un terminal. Son API locale peut aussi servir à les intégrer à une application ou à un agent de programmation. Le choix du modèle dépend de votre matériel, de la qualité attendue et du type de tâches à traiter ; la commande de lancement, elle, suit le même principe.
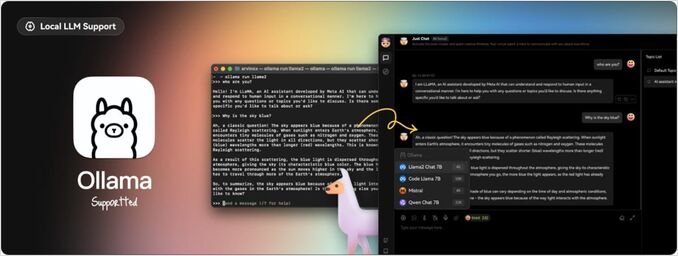
Pour lancer un modèle, utilisez la forme générique suivante dans votre terminal : ollama run <identifiant-du-modèle>. Cette commande lance le modèle dans le terminal, où vous pouvez lui soumettre des requêtes. Remplacez le texte entre chevrons par l’identifiant exact du modèle, après l’avoir vérifié dans Ollama.
L’exemple ci-dessous illustre la syntaxe de la commande. Il ne correspond pas à l’un des cinq modèles comparés dans la sélection :
ollama run gpt-oss:20b
Je ne déduis pas l’identifiant d’un modèle à partir de son nom commercial : les identifiants et les tags doivent être vérifiés dans Ollama avant l’exécution. N’utilisez donc pas un tag supposé ou reconstitué. C’est une précaution utile, notamment quand plusieurs variantes d’un même modèle sont disponibles.
Pour intégrer un modèle à une application, vous pouvez passer par l’API locale d’Ollama plutôt que par le terminal. Cette voie permet de connecter le modèle à un outil ou à un agent de programmation. Les détails d’appel dépendent de votre environnement ; vérifiez la documentation d’Ollama avant de configurer l’intégration, plutôt que de reprendre une URL ou des paramètres non validés.
En pratique, vérifiez d’abord l’identifiant exact, lancez le modèle avec la commande générique, puis évaluez ses réponses sur vos propres cas d’usage. La disponibilité d’un modèle ne garantit pas qu’il conviendra à vos contraintes de latence, de mémoire ou de qualité.
L’exécution locale garantit-elle la confidentialité ?
Non, télécharger un modèle sur votre machine ne garantit pas à lui seul la confidentialité. Les données peuvent encore quitter votre environnement via l’application qui appelle le modèle, ses outils connectés ou sa configuration réseau. La confidentialité dépend de toute la chaîne, pas seulement du lieu où le modèle s’exécute.
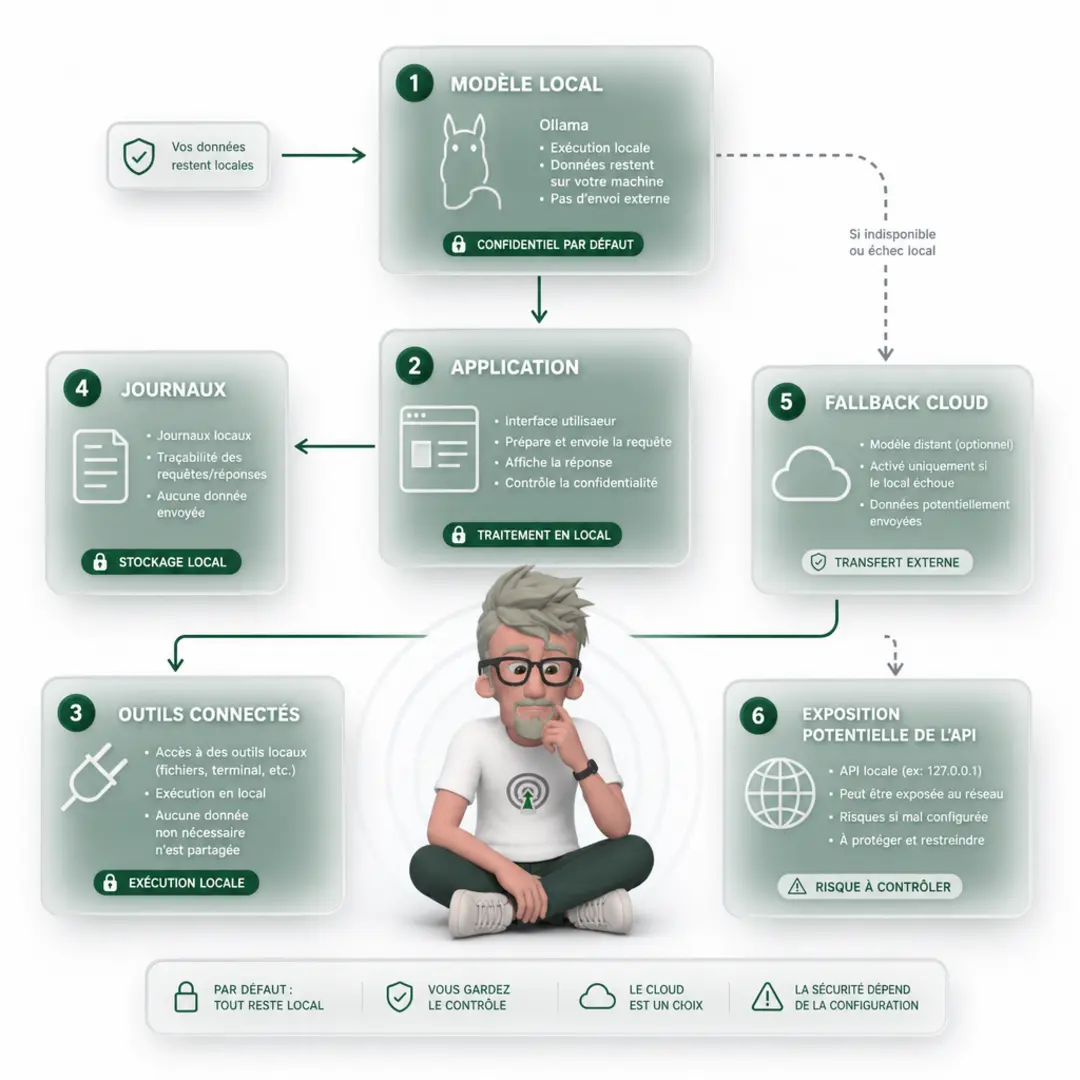
Je vérifie notamment les points suivants avant un déploiement :
- Les outils connectés. Un agent peut transmettre des prompts ou des documents à un moteur de recherche, une API métier, un service de transcription ou un outil tiers. Chaque intégration crée un flux de données à auditer.
- Les mécanismes de secours. Certaines applications basculent vers un fournisseur cloud si le modèle local est indisponible, trop lent ou incapable de traiter une requête. Je vérifie que ce fallback est désactivé ou explicitement contrôlé, et que les erreurs ne déclenchent pas d’envoi silencieux.
- La télémétrie et les journaux. Les statistiques d’usage, traces de débogage, prompts sauvegardés et rapports d’erreur peuvent contenir des données sensibles. Je contrôle les réglages, les journaux produits et leur durée de conservation.
- L’exposition de l’API locale. Une application ou un agent peut appeler l’API locale d’Ollama, souvent via http://localhost:11434. Si le service est exposé sur le réseau, ou si l’application relaie les requêtes vers l’extérieur, l’exécution locale ne suffit plus à maîtriser les accès. Je limite l’exposition réseau et j’inspecte les appels émis par l’application.
J’ai déjà vu des prototypes annoncés comme « locaux » envoyer des données à un service externe dès qu’un outil de recherche était activé. Le modèle tournait bien sur la machine ; le reste de la chaîne, non.
Ma décision tient en quatre contrôles : choisir le modèle selon les tâches, vérifier les contraintes matérielles, tester la qualité et la stabilité des sorties, puis auditer les flux de données de bout en bout. Un déploiement local réduit certains risques. Il ne constitue pas une garantie absolue de confidentialité.
Quel modèle allez-vous tester en premier ?
Il n’existe pas de meilleur modèle local pour tous les usages. Llama 3.1 8B Instruct couvre un large éventail de tâches textuelles, Qwen2.5 se distingue selon que vous travaillez sur des documents ou du code, Mistral 7B Instruct v0.3 reste à comparer sur vos propres cas, Gemma 4 apporte des capacités multimodales et Phi-4-mini-instruct vise les environnements contraints. Avec Ollama, vous pouvez lancer un modèle depuis le terminal et l’intégrer à une application via son API locale. Vérifiez les identifiants, les licences, le matériel et les flux de données avant déploiement. Vous gagnez ainsi une sélection adaptée à vos besoins, sans supposer que local signifie automatiquement privé.
FAQ
-
Quel modèle local choisir pour coder ?
Qwen2.5 Coder 7B est conçu pour générer, expliquer et corriger du code. Testez systématiquement le code produit avant de l’utiliser. -
Un modèle téléchargé localement garantit-il la confidentialité ?
Non. Vérifiez aussi les outils connectés, les éventuels basculements vers le cloud et la télémétrie, qui peuvent transmettre des données. -
Quel modèle choisir pour traiter des images ou de l’audio ?
Gemma 4 E2B et E4B sont des variantes multimodales capables de traiter du texte, des images et de l’audio, puis de générer du texte. Les possibilités dépendent aussi du logiciel utilisé. -
Comment lancer un modèle avec Ollama ?
Depuis le terminal, utilisez la commande ollama run suivie de l’identifiant exact du modèle disponible dans Ollama. Vérifiez cet identifiant avant de lancer la commande. -
Cette sélection comprend-elle les modèles les plus récents ?
Elle ne doit pas être considérée comme une liste exhaustive ou comme un classement des modèles les plus récents. Comparez les versions disponibles et testez-les sur vos propres tâches.
A propos de l’auteur
Je suis Franck Scandolera, expert en Data engineering et en automatisation IA. J’aide les équipes à intégrer des modèles et des workflows intelligents dans des applications métier, en tenant compte des usages, des contraintes techniques et de la maîtrise des données.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.