


Je peux interroger des données réparties entre plusieurs clouds avec BigQuery sans les déplacer vers un entrepôt central. Le catalogue fédéré et Apache Iceberg REST relient les métadonnées ; les fichiers Parquet restent dans leur stockage d’origine. Voici l’architecture et les accès à configurer.
Comment fonctionne le lakehouse sans frontières ?
BigQuery interroge des données multi-cloud en fédérant les métadonnées des catalogues externes, puis en lisant directement les fichiers Parquet dans leur stockage distant. Les ressources de calcul Google Cloud exécutent le traitement : les clusters et entrepôts virtuels des plateformes sources ne sont pas sollicités.
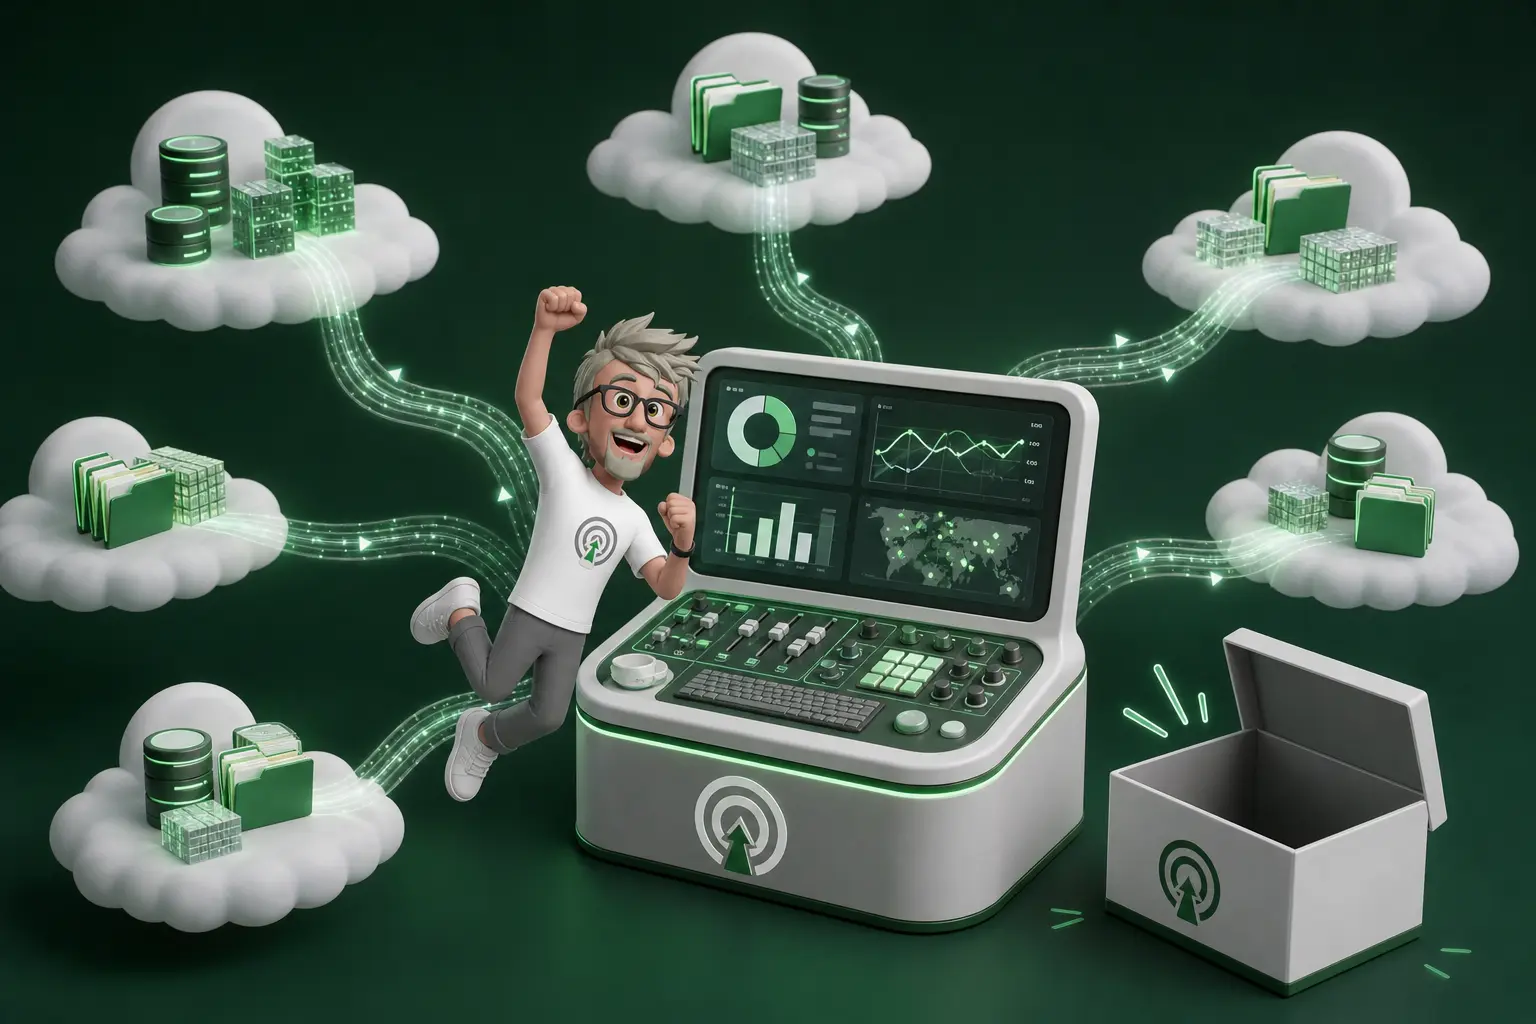
L’architecture s’appuie sur le catalogue d’exécution Lakehouse et sur la spécification ouverte Apache Iceberg REST. Cette interface permet de fédérer les métadonnées provenant de Databricks Unity Catalog, Snowflake Horizon Catalog et AWS Glue Data Catalog.
Que mesure l’analytics de ChatGPT Sites ?
Les métadonnées sont synchronisées périodiquement. Cette synchronisation porte sur les éléments nécessaires à la lecture des tables :
Comme on dit à Brive, un bon plan de marquage vaut mieux qu’un bon reporting ! Si besoin, consultez moi - faites appel à un super consultant en tracking client et server side.
- Les schémas, qui décrivent la structure des données.
- Les pointeurs d’instantané, qui désignent les versions des données à lire.
- Les définitions de tables, qui exposent les tables aux requêtes.
Au moment de la requête, BigQuery utilise ces informations pour lire les fichiers Parquet dans le stockage distant, par exemple sur Amazon S3. Le calcul reste exécuté sur les ressources Google Cloud, sans déclencher le calcul des plateformes qui gèrent les catalogues ou hébergent les données.
Cette séparation entre métadonnées et traitement vise à réduire les délais de synchronisation, les coûts de stockage et les frais de transfert. Elle évite aussi de mobiliser les ressources de calcul des environnements distants pour exécuter les requêtes BigQuery.
Comment réussir un audit GA4 fiable ?
Flux : Catalogues externes → synchronisation périodique des métadonnées → BigQuery lit les fichiers Parquet distants → traitement sur Google Cloud.
Quels accès faut-il configurer pour la fédération ?
La fédération nécessite deux accès distincts : l’un pour synchroniser les métadonnées, l’autre pour lire les fichiers au moment de la requête. J’accorde au compte de service généré par Google Cloud les autorisations nécessaires sur la plateforme distante, sans confondre ces deux usages.
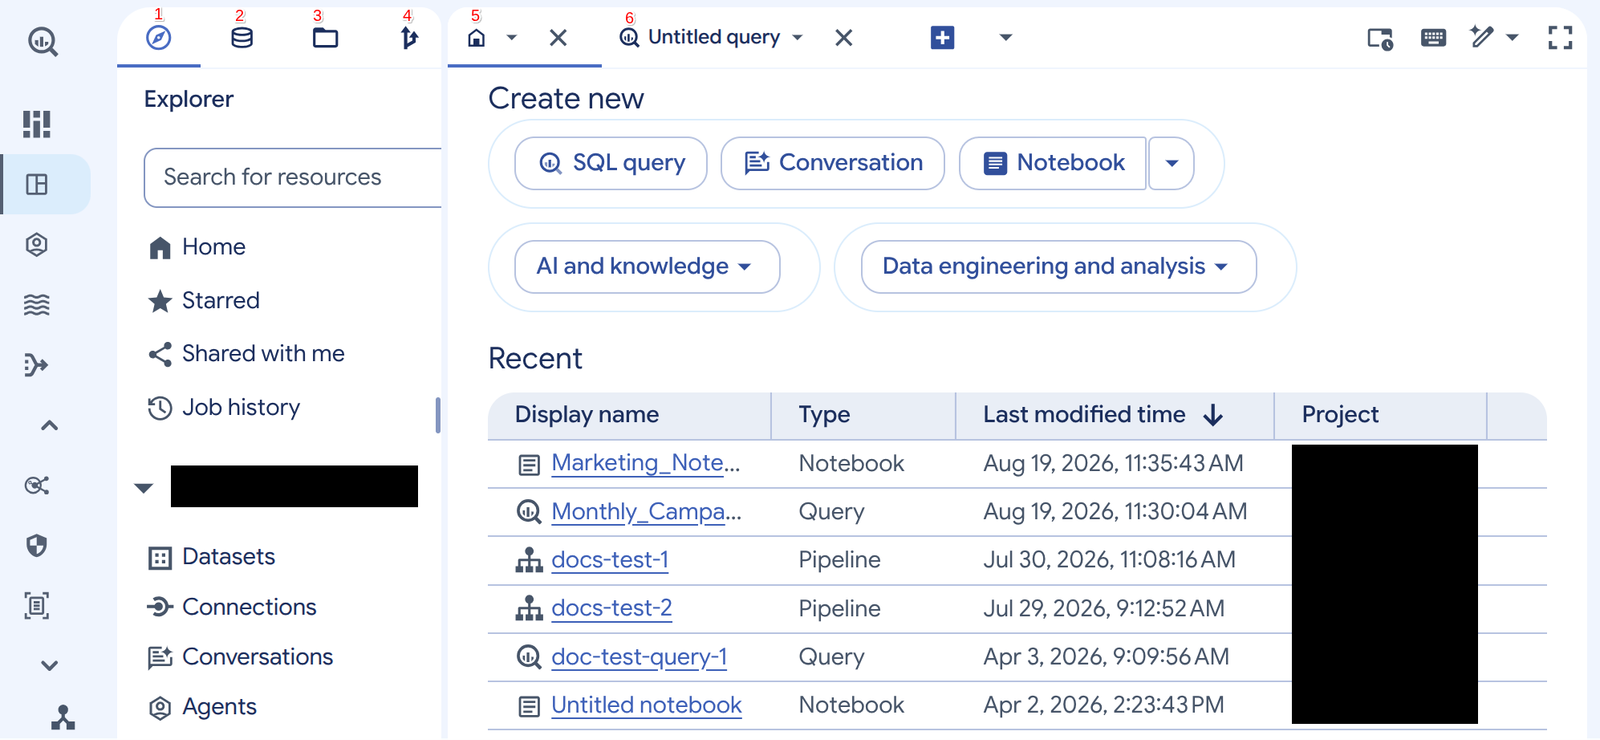
Le parcours d’authentification commence par la création du catalogue fédéré dans Google Cloud. Cette création génère automatiquement un compte de service, c’est-à-dire une identité technique utilisée pour établir l’accès à la source distante. Je récupère cette identité, puis je lui accorde les autorisations requises sur la plateforme concernée. Aucun accès utilisateur individuel ne remplace ces droits attribués au compte de service.
Comment Power Query améliore-t-il Report Builder ?
Les autorisations à prévoir dépendent de ce que le moteur doit faire :
Synchronisation des métadonnées. Le compte de service doit pouvoir accéder aux informations nécessaires pour découvrir ou actualiser les métadonnées exposées par la plateforme distante. Ces métadonnées décrivent notamment les tables et leur structure. Cette opération ne donne pas, à elle seule, accès au contenu des fichiers.
Accès aux données à l’exécution. Lorsqu’une requête est exécutée, le moteur compatible doit pouvoir lire les fichiers concernés dans le stockage distant. Les autorisations doivent donc couvrir ces fichiers et leur emplacement. Un catalogue visible dans BigQuery ne garantit pas que la lecture des données aboutira.
Quelle alternative à Sisense pour l’analytics embarquée ?
Je vérifie les deux chemins séparément : la synchronisation confirme que les métadonnées sont accessibles, tandis qu’une requête de lecture confirme que le moteur peut atteindre les fichiers. Un échec sur le premier chemin se traduit généralement par des métadonnées absentes ou non actualisées ; un échec sur le second bloque l’accès aux données à l’exécution.
Pour Databricks, qui sera détaillé ensuite, il faut appliquer ce principe aux autorisations configurées sur la plateforme et au stockage distant utilisé par les fichiers. Je ne peux pas déduire ces droits du seul fait que le catalogue fédéré a été créé dans Google Cloud : ils doivent être accordés explicitement à l’identité générée.
Comment connecter Databricks Unity Catalog à BigQuery ?
Pour interroger des données Databricks Unity Catalog depuis BigQuery, je crée un catalogue fédéré, puis j’établis une relation de confiance entre l’identité Databricks et Google Cloud. La connexion repose sur une fédération d’identités : aucun secret de clé de service n’est à intégrer dans BigQuery.
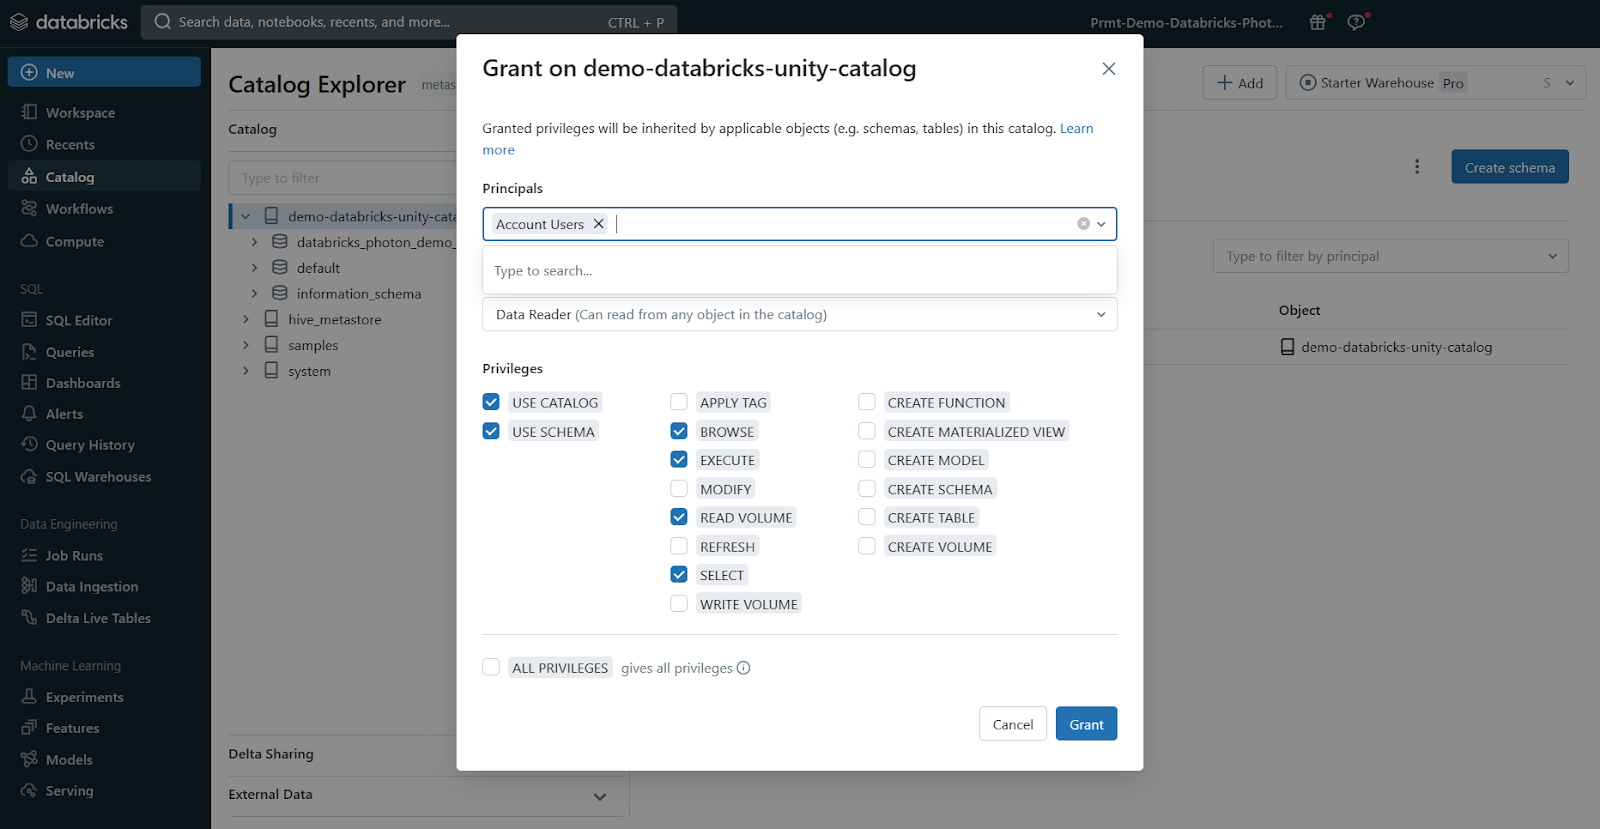
Côté Databricks, je vérifie d’abord les prérequis :
- J’associe le schéma cible à un emplacement externe déjà enregistré dans Unity Catalog.
- J’active l’accès aux données externes au niveau du metastore.
- Je crée un principal de service Databricks et conserve son UUID. Je relève aussi son identifiant d’application, utilisé lors de la création du catalogue fédéré.
Dans Google Cloud, je crée ensuite le catalogue fédéré avec gcloud, en renseignant l’URL de l’espace de travail Databricks et l’identifiant d’application du principal de service. Je lis la description du catalogue créé : elle fournit le compte de service attribué et l’identifiant de sujet requis pour la fédération.
Je retourne dans Databricks et accorde au principal de service le privilège EXTERNAL USE SCHEMA sur les schémas concernés, ou sur le catalogue si l’accès doit couvrir plusieurs schémas. Ce privilège autorise l’usage externe des objets Unity Catalog. Sans lui, la fédération d’identités ne suffit pas à rendre les données accessibles.
Je configure enfin une règle de fédération avec les valeurs suivantes. Les valeurs propres à l’environnement sont récupérées dans l’espace de travail ou dans la description du catalogue ; elles ne sont pas universelles.
- Émetteur : https://accounts.google.com
- Audience : https://accounts.cloud.databricks.com
- Identifiant de sujet : valeur indiquée dans la description du catalogue
- URL de l’espace de travail : URL réelle de l’espace Databricks cible
- Identifiant d’application : identifiant du principal de service Databricks
- Compte de service : compte attribué, indiqué dans la description du catalogue
Je ne fige pas ici de syntaxe de commande ou d’API : elle dépend de l’interface utilisée et de la version des services. Je vérifie surtout la correspondance exacte entre l’émetteur, l’audience et l’identifiant de sujet. Une valeur incorrecte bloque l’échange d’identité, même si les privilèges Unity Catalog sont correctement accordés.
Comment interroger les tables Iceberg fédérées ?
Les tables Iceberg fédérées s’interrogent depuis BigQuery sans recopier leurs fichiers dans Google Cloud. BigQuery fédère l’accès aux métadonnées, lit les fichiers Parquet dans le stockage distant et exécute le calcul sur Google Cloud.
Une table est référencée avec un chemin à quatre éléments : projet.catalogue.espace_de_noms.table. Chaque partie identifie un niveau de l’objet exposé à BigQuery.
| Élément | Rôle |
| projet | Projet BigQuery qui porte la référence. |
| catalogue | Catalogue contenant la table Iceberg. |
| espace_de_noms | Schéma ou espace qui organise les tables du catalogue. |
| table | Table Iceberg interrogée. |
Cette convention permet de viser les données fédérées depuis l’environnement BigQuery, tandis que les fichiers restent dans leur stockage distant. Le moteur ne déplace donc pas les données vers Google Cloud pour les analyser : il accède aux métadonnées fédérées, lit les fichiers Parquet concernés et réalise le calcul côté Google Cloud.
BigQuery sert à explorer ces données avec les outils d’analyse habituels. L’analytique conversationnelle peut aussi aider à explorer les données en formulant des demandes en langage naturel. Les modalités exactes de ces interactions ne sont pas détaillées ici.
Limite importante : l’exemple de requête réunissant des données de trois catalogues et les résultats associés ne sont pas détaillés dans les informations disponibles. Je ne peux donc pas préciser la syntaxe ni le résultat attendu sans inventer des éléments.
Le compromis est clair : moins de duplication et de transferts, mais une configuration des autorisations à maîtriser. Il faut contrôler les droits d’accès aux métadonnées et au stockage distant pour que les utilisateurs et BigQuery puissent lire les données nécessaires.
Que retenir de cette architecture multi-cloud ?
Je retiens une architecture où BigQuery fédère les métadonnées de catalogues comme Databricks Unity Catalog, Snowflake Horizon Catalog et AWS Glue Data Catalog grâce à Apache Iceberg REST. Les données Parquet restent dans leur stockage d’origine ; le calcul s’exécute sur Google Cloud. La mise en place repose sur la synchronisation des métadonnées, la création du catalogue fédéré et des autorisations correctement accordées, notamment pour Databricks. Le chemin à quatre éléments permet de référencer les tables Iceberg dans BigQuery. Cette approche réduit les besoins de déplacement et de duplication des données, ainsi que les frais associés. Vous pouvez ainsi explorer des données multi-cloud sans les centraliser au préalable.
FAQ
- Qu’est-ce qu’un lakehouse sans frontières ?
C’est une architecture qui permet d’interroger des données réparties entre plusieurs clouds sans les déplacer vers un entrepôt central. Les métadonnées sont fédérées et les fichiers restent dans leur stockage d’origine. - Quel est le rôle d’Apache Iceberg REST dans cette architecture ?
Apache Iceberg REST sert de spécification ouverte pour fédérer les métadonnées des catalogues pris en charge et rendre leurs tables accessibles depuis BigQuery. - Les données sont-elles copiées dans BigQuery ?
L’architecture décrite évite de déplacer les fichiers vers un entrepôt central. À l’exécution, un moteur compatible lit directement les fichiers Parquet dans le stockage distant. - Où le traitement des requêtes est-il effectué ?
Le traitement est effectué par les ressources de calcul Google Cloud, sans solliciter les clusters ou les entrepôts virtuels des plateformes distantes. - Comment référencer une table Iceberg fédérée dans BigQuery ?
Le chemin comporte quatre éléments : projet.catalogue.espace_de_noms.table. Les autorisations nécessaires doivent aussi être configurées sur la plateforme distante.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering. Je conçois des architectures de données fédérées et des workflows d’analytique qui rendent les données accessibles sans multiplier les copies ni les traitements manuels.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.