


DeepSeek Harness est gratuit. Vous payez séparément les appels aux modèles, selon votre mode de facturation, le modèle choisi, son réglage de raisonnement et l’activité de vos agents. Voici ce qui fait réellement varier la facture, et comment éviter les dépenses difficiles à repérer.
DeepSeek Harness est-il gratuit ?
DeepSeek Harness est gratuite : l’application ne facture ni licence, ni abonnement, ni accès à ses fonctionnalités. Ce coût nul concerne l’outil lui-même, pas les modèles qu’il peut solliciter.
L’interface web s’exécute localement. DeepSeek Harness existe aussi en version de bureau pour macOS et Windows. Sous Linux, l’interface web peut être exécutée avec Node.js. Ces variantes donnent accès à l’application, mais ne changent pas la façon dont les appels aux modèles sont facturés.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Quels modèles d’IA locaux choisir et installer ?
La facturation commence quand l’application sollicite un modèle pour produire une réponse. Autrement dit, ouvrir l’interface ou utiliser ses fonctionnalités sans lancer de requête à un modèle ne déclenche pas de frais liés à ces appels. Dès qu’un modèle est utilisé, le coût dépend du mode de facturation associé à son accès.
Il faut donc séparer deux lignes de coût :
- DeepSeek Harness : aucun frais de licence, d’abonnement ou d’accès aux fonctionnalités.
- Les appels aux modèles : ils peuvent être facturés selon le mode choisi et les conditions du fournisseur du modèle.
Le fait que l’interface soit locale ne signifie pas que les requêtes aux modèles sont gratuites. L’application sert à les déclencher ; le coût apparaît au niveau de l’accès au modèle, pas au niveau de DeepSeek Harness.
Comment réduire les tokens d’un prompt sans perdre en qualité ?
Pour estimer le coût réel à l’usage, il faut donc regarder comment les modèles sont facturés. Les modes de facturation disponibles, et les règles qui s’appliquent à chacun, sont le point à examiner ensuite.
Comment les appels aux modèles sont-ils facturés ?
Les appels aux modèles peuvent être facturés via une clé API ou via un compte DeepSeek approvisionné, selon la méthode active dans Harness. Le mode sélectionné détermine la source de budget sollicitée. Il faut donc le vérifier avant de lancer des tâches, surtout si plusieurs sources de paiement sont configurées.
| Clé API | Les appels sont associés au budget géré avec la clé API utilisée. Ce budget est distinct de celui du compte DeepSeek. |
| Compte DeepSeek | Les appels sont associés au compte DeepSeek approvisionné. Son budget est séparé de celui lié à une clé API. |
Ces deux voies ne correspondent pas à un même portefeuille. Un budget disponible sur une clé API ne signifie pas que le compte DeepSeek dispose du même montant, et l’inverse est tout aussi vrai. La sélection du mode de facturation détermine donc quel budget est réellement consommé par les appels concernés.
Quels dépôts GitHub pour les AI agent skills ?
Je vérifie toujours la méthode active dans les réglages de Harness avant d’évaluer le coût d’un usage. Je protège aussi les clés API : elles donnent accès à la source de facturation qui leur est associée. Évitez de les publier dans un dépôt, un document partagé ou un journal accessible à des personnes non autorisées.
Le montant consommé dépend ensuite de l’activité envoyée au modèle et de la façon dont Harness l’exécute. Le mode de facturation indique où la dépense est imputée, pas combien coûtera chaque tâche. Le coût varie notamment selon le modèle appelé, le volume de texte traité et le nombre d’appels nécessaires à une tâche.
Qu’est-ce qui fait varier le coût d’une tâche ?
Le coût d’une tâche dépend notamment du modèle utilisé, de son réglage de raisonnement et du nombre d’appels effectués pendant son exécution. Deux tâches proches peuvent donc consommer différemment, même si elles produisent un résultat de longueur similaire.
| Facteur | Effet sur le coût |
| Modèle | Le modèle détermine les conditions de tarification appliquées à chaque appel. Le coût dépend du modèle sélectionné et des règles de facturation en vigueur. |
| Nombre d’appels | Chaque appel au modèle peut ajouter de la consommation. Une tâche qui sollicite plusieurs fois le modèle, par exemple après des outils ou des étapes intermédiaires, peut donc coûter davantage. |
| Réglage de raisonnement | Un raisonnement plus poussé peut mobiliser davantage de jetons, c’est-à-dire les unités de texte traitées ou générées par le modèle. Il peut aussi allonger la durée de réponse et augmenter le coût associé à l’usage. |
Comment réussir le harness engineering d’un agent ?
Le réglage « max thinking » demande au modèle de consacrer plus de ressources à son raisonnement. Il peut être pertinent pour une tâche complexe, mais pas nécessairement pour une demande simple. Son effet dépend de la tâche et du comportement du modèle ; je ne peux pas en déduire une hausse fixe de consommation ou de durée.
Le niveau d’accès de l’agent ne fixe pas directement le prix. Donner à l’agent la permission d’utiliser des fichiers, des outils ou des systèmes externes ne change pas, en soi, la tarification du modèle. En revanche, ces permissions peuvent entraîner indirectement plus d’appels : l’agent peut chercher des informations, exécuter des actions, vérifier le résultat ou recommencer une étape. Une boucle de travail prolongée produit le même effet.
Je distingue donc les facteurs de tarification, comme le modèle et les conditions appliquées à ses appels, des facteurs de consommation, comme le raisonnement demandé, les outils utilisés et la durée de la tâche. Pour maîtriser le coût, il faut surtout observer le nombre d’appels et éviter les boucles inutiles, sans confondre permissions et prix unitaire.
Comment garder le contrôle sur son budget ?
Pour maîtriser les dépenses, identifiez d’abord le mode de facturation actif, puis surveillez les usages qui multiplient les appels aux modèles. Harness est gratuit ; les appels aux modèles sont facturés séparément.
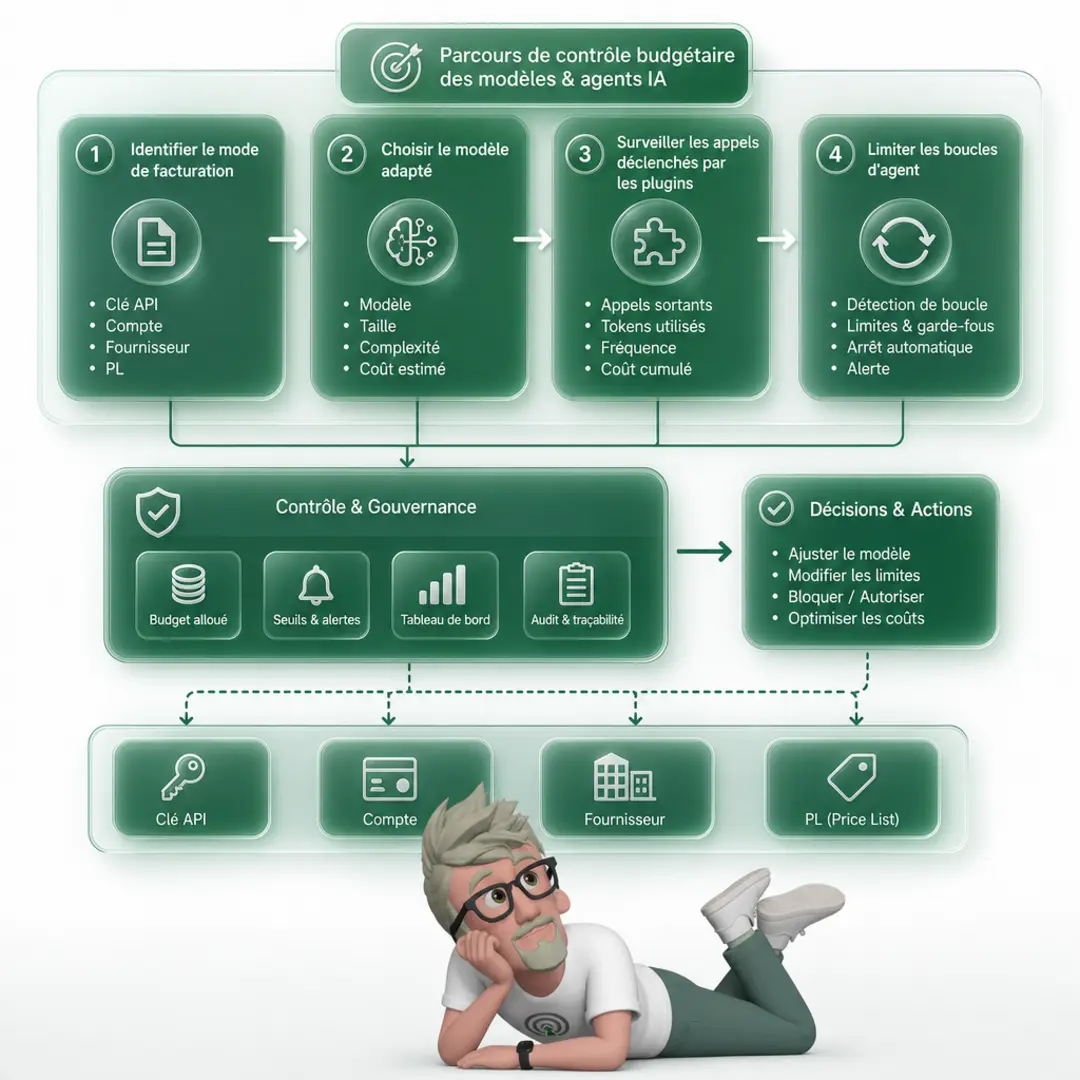
Vérifiez si Harness utilise une clé API ou un compte DeepSeek. Avec une clé API, les appels relèvent de la facturation associée à cette clé. Avec un compte DeepSeek, consultez les modalités de facturation de ce compte. Ne partez pas du principe que l’usage est inclus dans le prix de l’application.
Pour limiter les consommations inutiles, adaptez le modèle et le réglage de raisonnement à la tâche. Une tâche simple ne justifie pas forcément le modèle ou le niveau de raisonnement le plus avancé. L’effet exact sur la facture dépend toutefois de la configuration et des conditions de facturation appliquées.
Regardez aussi ce qui déclenche les appels, pas seulement le nombre de personnes qui utilisent l’outil. Les plugins, les automatisations et les boucles d’agent peuvent solliciter plusieurs fois les modèles pour une même demande. Ils consomment alors le même budget de modèles que les interactions directes.
- Confirmez le mode actif : clé API ou compte DeepSeek.
- Choisissez le modèle et le réglage de raisonnement selon la complexité réelle de la tâche.
- Examinez les plugins, automatisations et boucles d’agent susceptibles de répéter les appels.
- Suivez la facturation depuis le service associé au mode utilisé. Aucune fonction de plafond ou d’alerte n’est présumée ici.
| Facteur | Effet potentiel sur la consommation |
| Mode de facturation | Détermine le compte ou la clé auxquels les appels sont associés. |
| Modèle et raisonnement | Le choix peut modifier le coût des appels ; adaptez-le à la tâche. |
| Plugins et automatisations | Peuvent déclencher des appels supplémentaires aux modèles. |
| Boucles d’agent | Des étapes répétées peuvent multiplier les appels. |
Que faut-il retenir avant de lancer ses agents ?
DeepSeek Harness ne facture pas l’application : son interface et ses fonctionnalités sont gratuites. Le coût apparaît quand un agent appelle un modèle, via une clé API ou un compte DeepSeek approvisionné. Le montant dépend du modèle, du réglage de raisonnement et du volume d’appels. Les plugins, automatisations et boucles d’agent partagent le même budget ; une tâche prolongée peut donc consommer davantage, même si le niveau d’accès ne détermine pas directement le prix. Vérifiez le mode de facturation actif, protégez vos clés API et adaptez le modèle et le raisonnement à la tâche. Vous gardez ainsi une vision plus claire des coûts et évitez de confondre outil gratuit et usage sans frais.
FAQ
-
DeepSeek Harness est-il payant ?
Non, l’application est gratuite et n’impose ni frais de licence ni abonnement. Les appels aux modèles sont facturés séparément. -
Comment paie-t-on les appels aux modèles ?
Deux modes sont décrits : l’utilisation d’une clé API facturée selon l’usage, ou la connexion à un compte DeepSeek approvisionné. Vérifiez le mode actif dans les réglages. -
Qu’est-ce qui influence le coût d’une tâche ?
Le modèle, le réglage de raisonnement et le nombre d’appels effectués par l’agent influencent la consommation. Un réglage comme « max thinking » peut aussi modifier l’usage de jetons et la durée de réponse. -
Les plugins et automatisations consomment-ils le même budget ?
Oui. Les plugins, automatisations et boucles d’agent utilisent le budget associé aux appels aux modèles. -
Le niveau d’accès de l’agent détermine-t-il le prix ?
Pas directement. En revanche, des permissions plus larges ou des boucles de travail prolongées peuvent entraîner davantage d’appels, et donc augmenter la consommation.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. J’aide les équipes à concevoir des workflows agentiques maîtrisés, notamment sur la consommation des modèles et la fiabilité des applications métier intelligentes.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.