


On réduit le coût du fine-tuning en limitant les paramètres entraînés, en choisissant un modèle adapté et en maîtrisant l’infrastructure. LoRA et QLoRA sont deux leviers clés. Encore faut-il savoir quand modifier les poids plutôt que d’améliorer la récupération d’information.
Quand le fine-tuning est-il utile ?
Le fine-tuning est utile quand un modèle préentraîné répond de façon trop variable à une tâche récurrente, malgré des consignes bien conçues. Il consiste à poursuivre son entraînement sur des données propres à cette tâche. Le modèle ajuste alors ses poids, c’est-à-dire les paramètres qui déterminent ses réponses.
Je le distingue de deux leviers souvent suffisants. Le prompt engineering améliore les instructions transmises au modèle, sans modifier ses poids. La génération augmentée par récupération, ou RAG, fournit au modèle des informations issues de documents externes au moment de la réponse. Elle met à jour le contexte disponible, pas le modèle lui-même. Ces approches peuvent aussi être combinées : un modèle ajusté peut exploiter des documents récupérés, avec des consignes adaptées.
Comment router entre LLM local et API cloud ?
Le fine-tuning devient pertinent quand le comportement attendu doit rester cohérent à grande échelle, sur de nombreuses requêtes similaires. Il peut notamment aider à :
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
- Respecter un format de sortie exact, comme un schéma JSON ou une structure attendue par une application.
- Employer un vocabulaire spécialisé de façon plus régulière, à partir d’exemples représentatifs du domaine.
- Adopter une voix de marque ou un style rédactionnel stable, lorsque les consignes seules ne donnent pas une cohérence suffisante.
- Reproduire un comportement métier récurrent, avec des exemples de tâches et de réponses conformes aux attentes.
Il ne convient pas à tous les problèmes. Si les réponses sont incorrectes parce que le modèle ne dispose pas de la bonne information, ajuster ses poids n’est pas nécessairement la bonne réponse. Une meilleure récupération des documents suffit souvent, notamment lorsque les connaissances changent ou doivent rester traçables. Le fine-tuning ne remplace pas non plus des données d’entraînement propres : des exemples incohérents peuvent renforcer le comportement qu’on cherche justement à corriger.
Pour maîtriser les coûts, je vérifie d’abord si le problème vient des instructions, des informations manquantes ou du comportement du modèle. Le fine-tuning se justifie surtout dans ce dernier cas, quand les mêmes attentes reviennent à grande échelle et que les autres leviers ne les satisfont pas.
Comment choisir une méthode légère ?
Combien coûte DeepSeek Harness à l’usage ?
Pour réduire le coût du fine-tuning, je privilégie une méthode économe en paramètres comme LoRA ou QLoRA, plutôt qu’un entraînement complet. Ces deux approches limitent les paramètres mobilisés pour adapter le modèle et réduisent les ressources nécessaires par rapport à un entraînement complet.
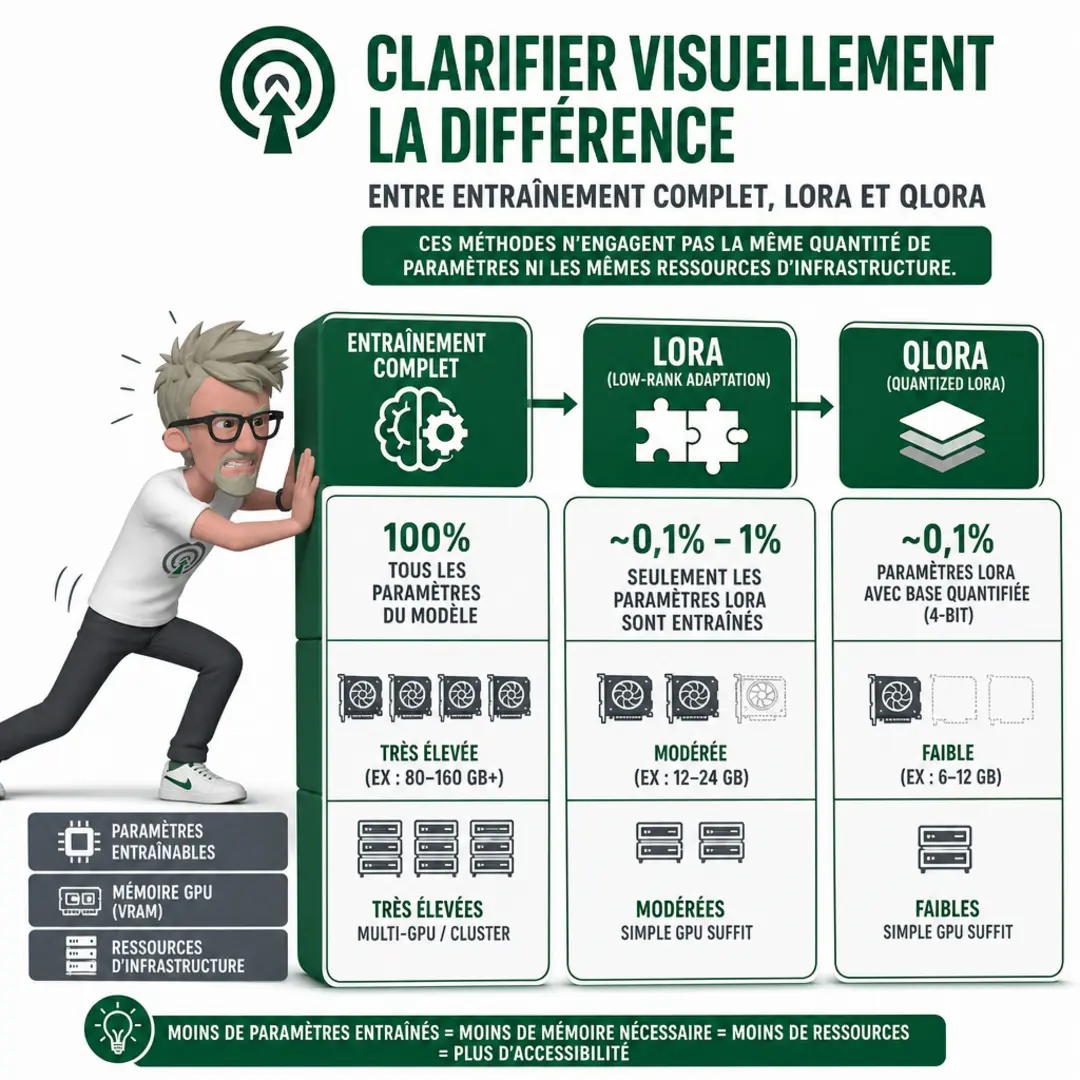
L’intérêt est direct : moins de paramètres à entraîner signifie une charge d’adaptation plus maîtrisée, donc des besoins en ressources et des coûts potentiellement plus faibles. Je ne peux pas déduire des seuls faits disponibles que LoRA ou QLoRA sera toujours le moins cher dans votre configuration. Le choix dépend aussi des contraintes d’infrastructure et du modèle visé.
Le périmètre considéré ici concerne des modèles denses d’environ 2 à 13 milliards de paramètres. Pour des modèles beaucoup plus grands, les besoins d’infrastructure augmentent. Il faut alors réévaluer le coût global avant de retenir une méthode, sans supposer que les gains observés sur des modèles plus petits se transposent tels quels.
Quels modèles d’IA locaux choisir et installer ?
La comparaison ci-dessous se limite aux caractéristiques établies : LoRA et QLoRA sont des méthodes économes en paramètres, conçues pour réduire les ressources nécessaires par rapport à un entraînement complet. Elle ne détaille ni leurs mécanismes ni leurs performances respectives.
| Méthode | Faits disponibles |
| LoRA | Fine-tuning économe en paramètres, avec des ressources nécessaires réduites par rapport à un entraînement complet. |
| QLoRA | Fine-tuning économe en paramètres, avec des ressources nécessaires réduites par rapport à un entraînement complet. |
Quels modèles peut-on adapter ?
Oui. Plusieurs familles de modèles ouverts peuvent être adaptées, notamment Llama 3.x, Qwen 2.5 et 3, Mistral, Gemma 2 à 4 et Phi. Ce sont des exemples, pas un classement : le bon choix dépend surtout de votre cas d’usage, du modèle précis et des ressources disponibles.
Les offres citées dans les informations disponibles incluent le fine-tuning géré chez OpenAI et Google, ainsi que des options LoRA à l’usage chez Together AI et Fireworks. LoRA est une méthode d’adaptation qui entraîne un petit nombre de paramètres supplémentaires plutôt que de modifier tous les poids du modèle. Je ne déduis de ces exemples ni tarifs ni disponibilité actuels.
Comment réduire les tokens d’un prompt sans perdre en qualité ?
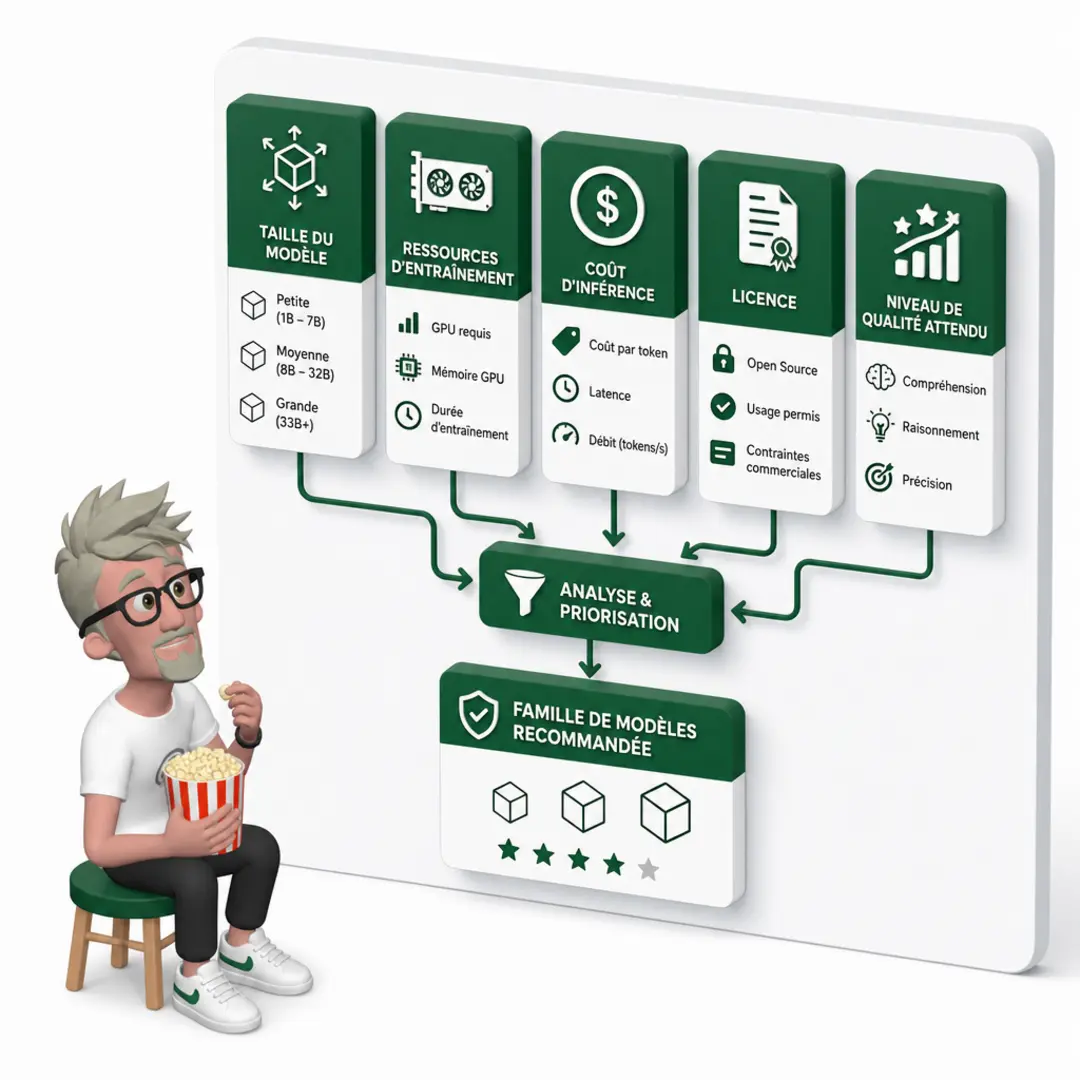
La taille du modèle change directement le coût d’entraînement et d’exploitation. Un modèle plus volumineux demande généralement davantage de mémoire GPU, de calcul et de stockage. Pour choisir, je vérifie la capacité d’infrastructure nécessaire à l’entraînement, mais aussi celle requise pour servir le modèle en production. Un modèle adapté qui ne tient pas dans le budget d’inférence reste un mauvais choix.
Les principaux critères à comparer sont les suivants :
- La taille du modèle : elle détermine une part importante des besoins en mémoire et en calcul.
- La méthode d’adaptation : LoRA peut réduire les ressources nécessaires par rapport à un entraînement complet, sans convenir à tous les objectifs.
- Le déploiement : estimez le coût par requête et les contraintes de latence, pas seulement le coût d’entraînement.
- Les conditions d’utilisation : vérifiez la licence et la disponibilité du checkpoint exact, car elles peuvent varier au sein d’une même famille.
Je commence par le plus petit modèle compatible avec le niveau de qualité attendu, puis je valide ce compromis sur un jeu de tests représentatif. Ça évite de payer pour une capacité que votre tâche n’utilise pas.
Comment accélérer l’entraînement et l’alignement ?
Pour accélérer l’entraînement et l’alignement, je joue sur deux leviers : des outils qui réduisent le temps nécessaire à chaque entraînement et des objectifs d’alignement dont la mise en œuvre mobilise moins de ressources. Le bon choix dépend du comportement visé et du budget disponible.
- Recourir à des outils d’entraînement plus rapides. Leur rôle est de réduire le temps consacré à l’adaptation du modèle, sans changer l’objectif recherché. Je les évalue selon leur compatibilité avec le modèle et le processus existants, puis selon leur effet sur la durée et les ressources nécessaires à l’entraînement. Un entraînement plus rapide permet de consacrer moins de temps et de ressources à chaque itération.
- Choisir des objectifs d’alignement moins coûteux. Un objectif d’alignement définit le comportement que le modèle doit apprendre à privilégier. Je le formule au niveau de précision réellement nécessaire : un périmètre trop large ou une cible mal définie peut rendre l’adaptation plus complexe sans répondre à un besoin concret. L’objectif retenu doit donc rester cohérent avec les usages attendus et les moyens disponibles.
Ces leviers sont distincts de LoRA et QLoRA, déjà abordés. LoRA et QLoRA réduisent la quantité de paramètres à adapter, et, pour QLoRA, la mémoire nécessaire à cette adaptation. Les outils plus rapides agissent sur la durée et les ressources mobilisées pendant l’entraînement. Le choix de l’objectif agit sur le travail d’alignement à réaliser. Ces approches peuvent se compléter, mais elles ne remplacent pas les mêmes optimisations.
En pratique, je vérifie que la réduction du coût ne dégrade pas le comportement attendu. Un entraînement plus court ou un objectif plus limité n’a de valeur que si le modèle reste adapté à votre cas d’usage.
Quel budget et quelle infrastructure prévoir ?
Oui, un fine-tuning peut coûter moins de 10 dollars en temps GPU brut lorsque des méthodes économes en paramètres sont appliquées à un petit modèle de 2 à 8 milliards de paramètres. Cette estimation couvre uniquement l’utilisation du GPU pendant l’entraînement, pas le coût total du projet. Les modèles beaucoup plus grands demandent davantage d’infrastructure et ne relèvent pas de cette estimation.
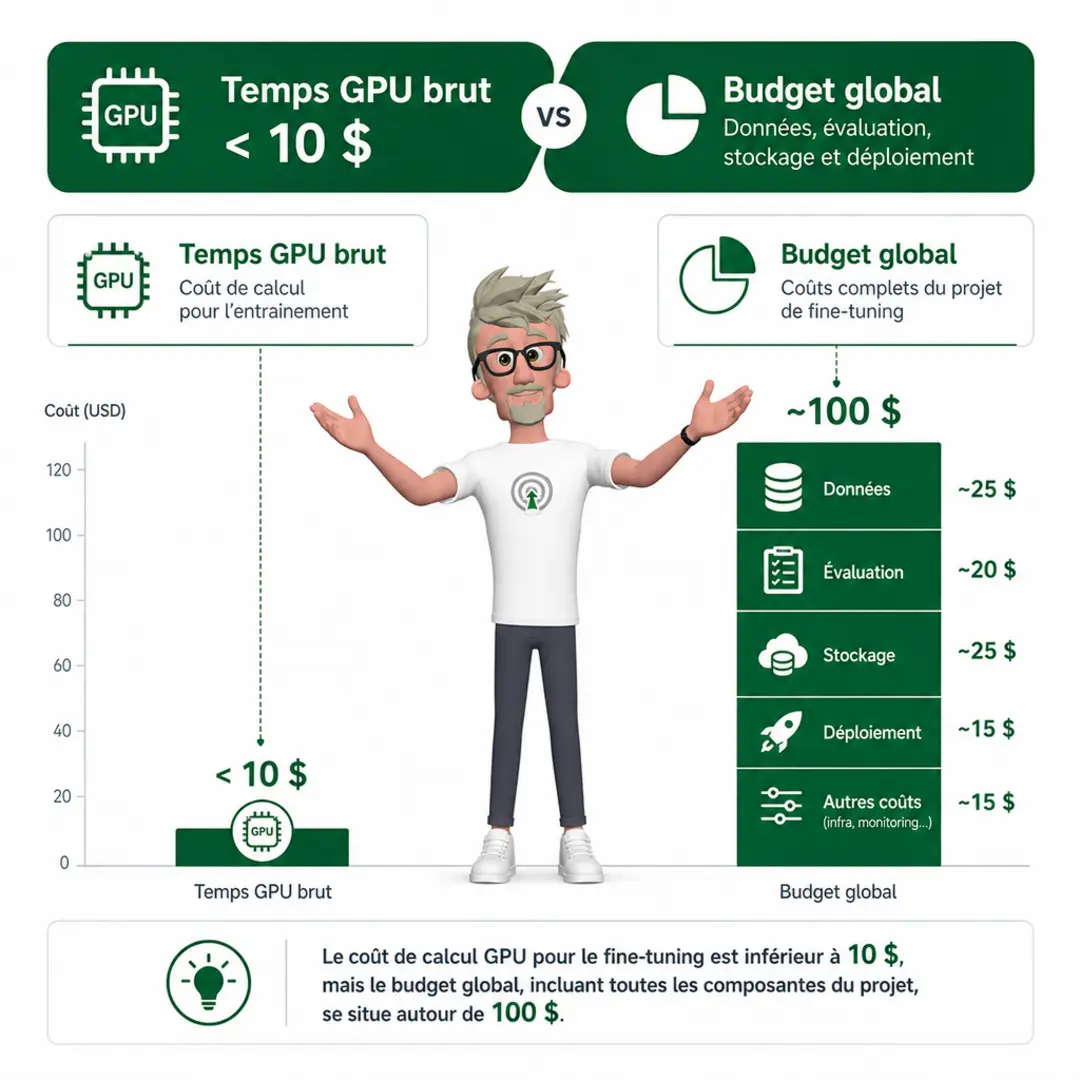
Le budget dépend surtout de trois facteurs. La taille du modèle fixe une partie des besoins en mémoire et en calcul. La méthode de fine-tuning détermine la quantité de paramètres modifiés : LoRA, par exemple, entraîne de petites matrices d’adaptation plutôt que l’ensemble du modèle ; QLoRA ajoute une quantification pour réduire l’empreinte mémoire. Enfin, les ressources mobilisées — GPU, mémoire disponible, stockage et environnement d’entraînement — déterminent ce qui peut être exécuté et dans quelles conditions.
Pour cadrer le budget, je sépare le calcul d’entraînement du coût complet. Le temps GPU brut donne un repère utile, mais il ne suffit pas à chiffrer un projet. Il faut aussi examiner les besoins liés à la préparation des données, aux essais, à l’évaluation, au stockage et au déploiement, selon le périmètre retenu. Ces postes varient d’un projet à l’autre ; je ne les déduis donc pas du seul coût GPU.
La synthèse tient en deux catégories :
| Informations chiffrées disponibles | Moins de 10 dollars en temps GPU brut peut être possible avec une méthode économe en paramètres sur un modèle de 2 à 8 milliards de paramètres. Ce montant n’est pas le budget total du projet. |
| À évaluer pour chaque projet | La taille du modèle, la méthode de fine-tuning, les ressources GPU et mémoire, le stockage, la préparation des données, l’évaluation et le déploiement. Les modèles beaucoup plus grands demandent davantage d’infrastructure. |
Quel levier tester en premier ?
Le fine-tuning est pertinent quand votre application exige un comportement cohérent, un format strict ou la maîtrise d’un vocabulaire spécialisé. Pour limiter la dépense, LoRA et QLoRA réduisent les ressources nécessaires, tandis que des outils d’entraînement plus rapides, des objectifs d’alignement moins coûteux et un choix d’infrastructure adapté complètent l’approche. De petits modèles de 2 à 8 milliards de paramètres peuvent coûter moins de 10 dollars en temps GPU brut avec des méthodes économes en paramètres, sans que cela représente le budget total. Avant d’entraîner, vérifiez si une meilleure récupération d’information suffit. Vous éviterez des coûts inutiles et choisirez une adaptation proportionnée à votre besoin.
FAQ
-
Qu’est-ce que le fine-tuning d’un LLM ?
C’est la poursuite de l’entraînement d’un modèle préentraîné sur des données propres à une tâche. Cette adaptation modifie les poids du modèle pour influencer son comportement, son format, son domaine ou son ton. -
Quelle différence avec le prompt engineering ou le RAG ?
Le fine-tuning modifie les poids du modèle. Le prompt engineering et la génération augmentée par récupération sont d’autres approches. Une meilleure récupération d’information suffit souvent et peut éviter un fine-tuning inutile. -
À quoi servent LoRA et QLoRA ?
LoRA et QLoRA sont des méthodes économes en paramètres utilisées pour adapter des modèles en limitant les ressources nécessaires par rapport à un entraînement complet. -
Combien coûte un fine-tuning avec une méthode économe ?
Pour de petits modèles de 2 à 8 milliards de paramètres, le temps GPU brut peut coûter moins de 10 dollars avec des méthodes économes en paramètres. Ce montant ne correspond pas nécessairement au coût total du projet. -
Quels modèles peuvent être adaptés ?
Les familles citées incluent Llama 3.x, Qwen 2.5 et 3, Mistral, Gemma 2 à 4 et Phi. Des offres de fine-tuning gérées ou de LoRA à l’usage existent également chez plusieurs fournisseurs.
A propos de l’auteur
Franck Scandolera est expert en Data engineering et en automatisation IA. Il conçoit des workflows agentiques et des applications métier intelligentes, avec une attention particulière à l’adaptation des modèles aux besoins opérationnels et à la maîtrise des ressources.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.