


Le reflection pattern sert à faire relire, critiquer puis corriger une réponse par un agent IA avant de l’envoyer en production. Je vous montre où ça marche, où ça coûte cher, et comment poser des limites propres pour gagner en qualité sans exploser la latence.
À quoi sert le reflection pattern ?
Le reflection pattern sert à améliorer une sortie d’agent IA en ajoutant une boucle générer, critiquer, réviser avant livraison.
Le principe est simple. L’agent produit un premier brouillon, puis il relit ce brouillon avec des critères précis, puis il génère une version corrigée. C’est une forme de contrôle qualité intégré dans le raisonnement de l’agent.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Comment créer un AI Data Analyst fiable en Python ?
Je préfère être clair tout de suite : ce n’est pas magique. Si vos critères de critique sont flous, l’agent va critiquer flou. Si vos sources sont mauvaises, il peut produire une réponse mieux écrite, mais toujours fausse. Le reflection pattern améliore la robustesse, pas la vérité absolue.
Sur le terrain, j’ai souvent vu le même problème. Un agent IA est excellent en démo, il répond vite, il impressionne tout le monde, puis en production il devient fragile. Il oublie une règle métier, il répond avec trop d’assurance, il invente une info, ou il envoie une réponse moyenne directement dans un CRM, une base de connaissance ou un workflow automatisé. Le reflection pattern sert justement à mettre un sas de contrôle avant que la réponse parte quelque part.
Les bénéfices sont très concrets :
- Moins d’erreurs visibles côté utilisateur.
- Des réponses plus propres, mieux structurées, moins bavardes.
- Une meilleure conformité aux règles internes, par exemple ton, mentions légales, politique de remboursement, critères SEO.
- Moins de contenu inutile dans les pages, les emails, les tickets support ou les fiches produit.
- Une confiance plus forte dans les automatisations IA, parce qu’on ne laisse pas le premier jet partir en production.
Comment créer un workflow multi-agent avec Copilot Studio ?
Côté SEO, c’est utile quand l’agent produit du contenu, des briefs, des FAQ ou des optimisations de pages. La boucle de critique peut vérifier l’intention de recherche, les répétitions, les informations faibles, les titres trop vagues, ou les passages qui n’apportent rien. Côté métier, c’est surtout un garde-fou.
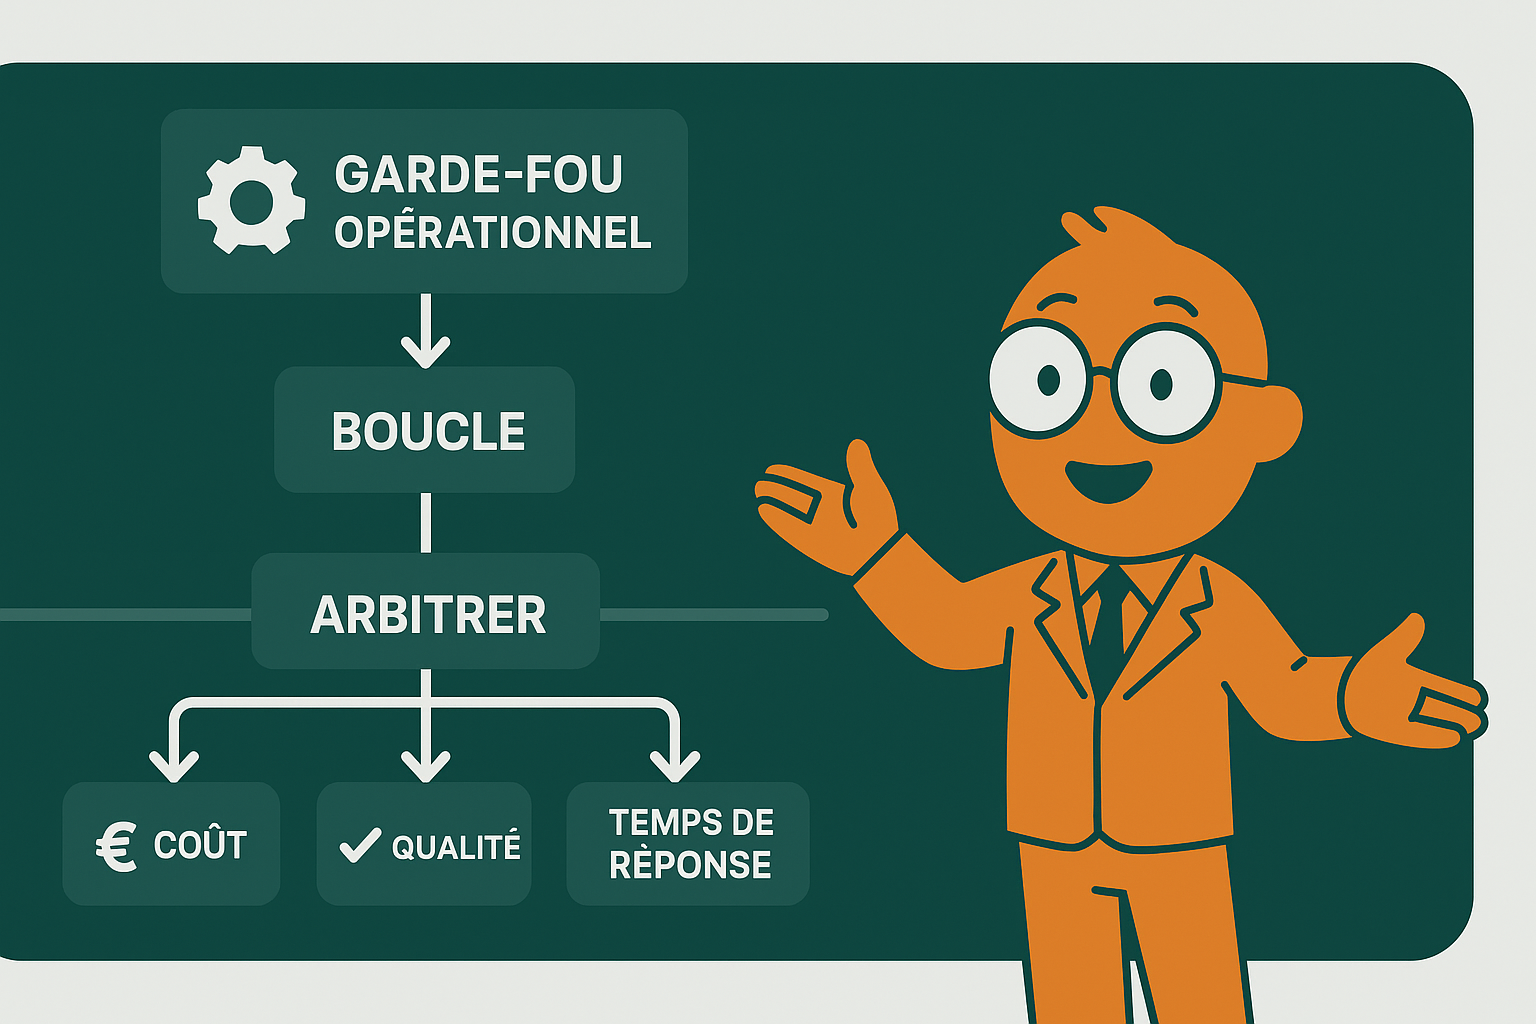
Il y a quand même un coût. Chaque boucle consomme du temps, des tokens, des appels modèle, parfois des appels à des outils externes. Il faut donc l’utiliser là où l’erreur coûte plus cher que la vérification.
| Approche | Avantage | Limite | Cas d’usage adapté |
| Réponse agent classique | Rapide, simple, moins coûteuse | Plus fragile, peu de contrôle avant livraison | Questions simples, brouillons internes, tâches à faible risque |
| Réponse avec reflection pattern | Plus propre, plus conforme, moins d’erreurs visibles | Plus lente, plus chère, dépendante des critères de critique | Support client, contenu SEO, CRM, base de connaissance, workflows automatisés |
Comment fonctionne la boucle ?
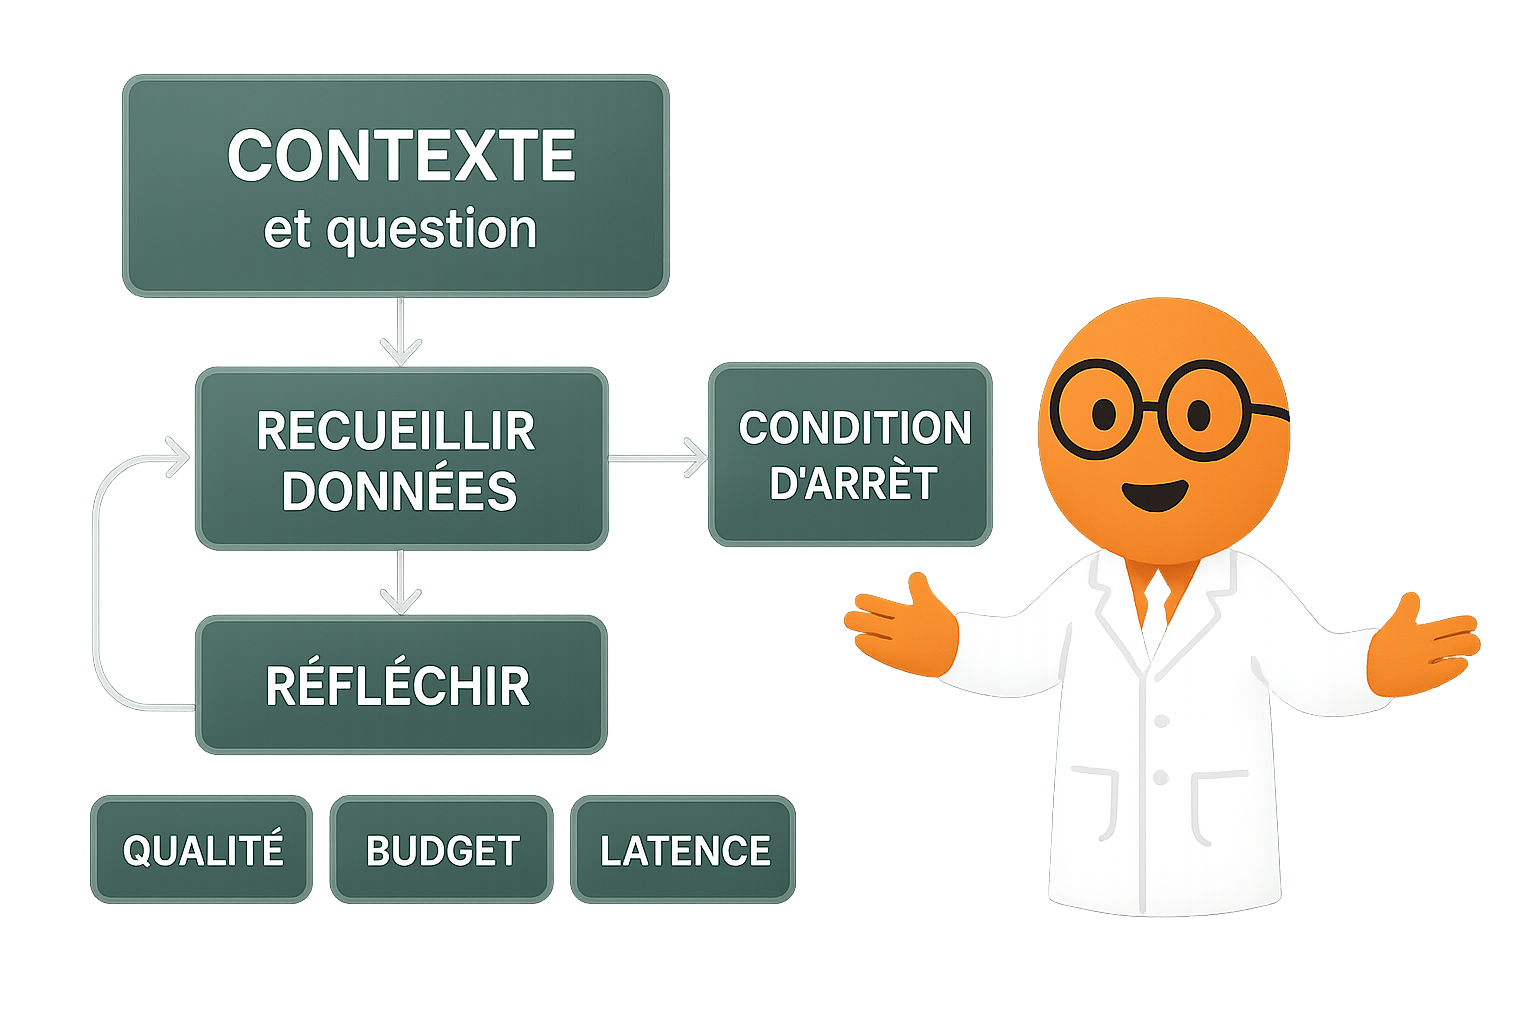
En production, la boucle de reflection fonctionne simplement en trois temps : Generate, Reflect, Refine. Je garde toujours une condition d’arrêt, sinon l’agent peut passer son temps à se corriger lui-même sans créer plus de valeur.
- Generate Le modèle produit un premier brouillon avec ce qu’il a sous la main : consigne système, documents, politiques internes, données accessibles, historique utilisateur. Cette sortie doit être conservée telle quelle, parce qu’elle devient la matière à critiquer. Sans brouillon stable, la critique flotte dans le vide.
- Reflect Le même modèle, ou un autre modèle plus spécialisé, évalue ce brouillon avec une grille claire : conformité, risque d’erreur, hallucination possible, contenu dangereux, réponse hors sujet, information inutile, ton inadapté. On peut aussi brancher des outils externes : recherche web, base de données, moteur documentaire, API métier. Mais attention, un outil externe n’améliore la vérité que si ses données sont fiables et si la requête est bien posée. J’ai déjà vu des agents “vérifier” une réponse avec une mauvaise recherche, et renforcer une erreur au lieu de la corriger.
- Refine L’agent réinjecte le brouillon et la critique dans le modèle pour produire une version corrigée. Exemple simple : une réponse support client dit “Vous pouvez être remboursé sous 30 jours”, mais elle oublie que le produit doit être non utilisé. La critique détecte l’oubli. La version finale devient : “Vous pouvez demander un remboursement sous 30 jours, si le produit n’a pas été utilisé et respecte nos conditions de retour.” C’est plus conforme, plus utile, et moins risqué.
def generate(question, context):
    # Produit le premier brouillon à partir du contexte disponible.
    return call_model(question=question, context=context)

def reflect(question, draft, context):
    # Évalue le brouillon avec une grille de critique claire.
    critique_prompt = {
        "question": question,
        "draft": draft,
        "criteria": [
            "conformité",
            "risque d'erreur",
            "hallucination possible",
            "contenu dangereux",
            "hors sujet",
            "information inutile",
            "ton inadapté"
        ]
    }
    return call_model_for_critique(critique_prompt, context)

def refine(question, draft, critique, context):
    # Corrige la réponse avec le brouillon et la critique.
    refine_prompt = {
        "question": question,
        "draft": draft,
        "critique": critique
    }
    return call_model(refine_prompt, context=context)

def reflection_loop(question, max_iterations=3, threshold=0.85):
    # Récupère le contexte utile : documents, règles internes, historique.
    context = load_context(question)

    # Génère et conserve le premier brouillon.
    answer = generate(question, context)
    last_critique = None

    for _ in range(max_iterations):
        # Critique la réponse actuelle.
        last_critique = reflect(question, answer, context)

        # Arrête la boucle si la qualité est suffisante.
        if last_critique["score"] >= threshold:
            break

        # Produit une version corrigée.
        answer = refine(question, answer, last_critique, context)

    return {
        "answer": answer,
        "critique": last_critique
    }
Comment GitHub Agentic Workflows automatise vos reviews ?
La condition d’arrêt n’est pas un détail technique. C’est ce qui protège le budget, la latence, et parfois la qualité. Une boucle trop longue peut finir par dégrader une bonne réponse, surtout quand le modèle commence à surcorriger des points qui étaient déjà corrects.
Quelle variante choisir ?
Le bon choix dépend surtout de quatre choses : le niveau de risque, le niveau de qualité attendu, la latence acceptable et les ressources que vous avez vraiment. Pas besoin de sur-ingénierie partout. J’ai vu des équipes monter une usine multi-agent pour corriger trois phrases marketing, et à l’inverse laisser un seul modèle valider des règles métier sensibles. Dans les deux cas, ça finit par coûter cher.
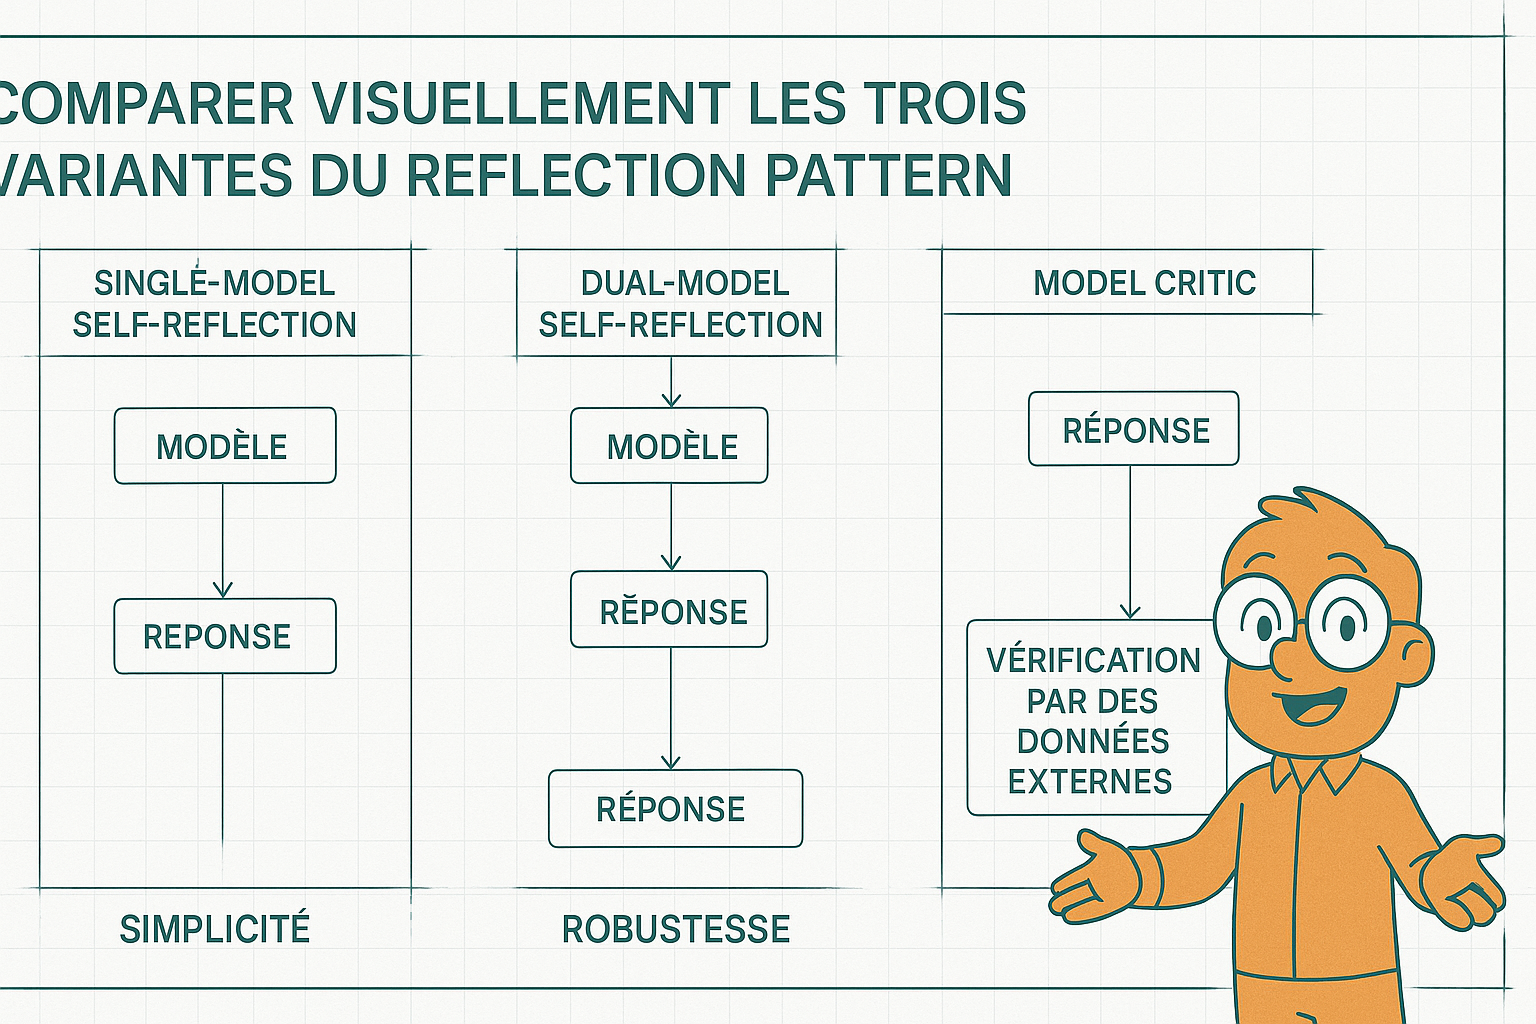
Le single-model self-reflection, c’est la version la plus simple. Le même modèle génère une réponse, puis relit sa propre réponse pour la critiquer ou l’améliorer. C’est rapide à mettre en place, moins coûteux qu’une architecture multi-agent, et souvent suffisant pour des tâches simples. Le problème, c’est le biais d’auto-préférence. Le modèle peut valider une erreur qu’il a lui-même produite, parce qu’il reste enfermé dans son propre raisonnement. Je l’utilise plutôt pour améliorer le style, raccourcir une réponse, vérifier une petite checklist, ou rendre un texte plus clair.
Comment créer un agent IA local en streaming ?
Le multi-agent reflection sépare les rôles. Un agent rédacteur produit la réponse, un agent critique la relit. Ça ressemble plus à une revue par les pairs. Le critique peut repérer des erreurs que le premier modèle ne voit pas, surtout si les prompts, les rôles ou même les modèles sont différents. C’est utile dès qu’on veut plus de robustesse. Le prix à payer est simple : plus de latence, plus d’orchestration, plus de logs à surveiller. Et les logs, ce sont les traces d’exécution qui permettent de comprendre qui a répondu quoi, quand, et pourquoi.
Le tool-augmented reflection ajoute des outils à la phase de critique. L’agent peut appeler une recherche, une base de données ou une API métier, c’est-à-dire une interface qui permet d’interroger un système interne. Là, on ne demande plus seulement au modèle de “réfléchir”, on lui demande de vérifier. Par exemple : contrôler un statut client, valider une règle tarifaire, confirmer une date, vérifier une politique interne. Attention quand même. Si l’outil renvoie des données périmées, mal filtrées ou incomplètes, l’agent peut devenir très sûr de lui avec une mauvaise information.
| Cas | Variante conseillée | Pourquoi | Point de vigilance |
| Contenu faible risque | Single-model self-reflection | Rapide, simple, peu coûteux | Ne pas lui demander de valider des faits critiques |
| Support client | Multi-agent reflection | Meilleure relecture avant réponse au client | Surveiller la latence et les escalades humaines |
| Conformité | Tool-augmented reflection | Besoin de vérifier une règle ou une politique officielle | Contrôler la fraîcheur et la source des données |
| Données métier sensibles | Tool-augmented reflection avec garde-fous | Le modèle doit valider contre les systèmes internes | Limiter les accès et tracer chaque appel outil |
| Réponse factuelle | Tool-augmented reflection ou multi-agent | La réponse doit être vérifiée, pas juste bien formulée | Éviter les sources floues ou non datées |
Comment limiter coût et latence ?
Le reflection pattern coûte cher quand on le laisse tourner “jusqu’à ce que ça ait l’air mieux”. Je l’ai vu chez un client sur un agent de support : trois critiques, deux réécritures, puis une quatrième “pour améliorer le ton”. Résultat, une réponse correcte, mais trop lente et deux fois trop chère.
Pour le tenir en production, je mets des garde-fous simples :
- Nombre maximum d’itérations : par exemple 2 ou 3, rarement plus.
- Score minimal de qualité : si la réponse atteint 85/100, on arrête.
- Absence de critique majeure : si les problèmes restants sont mineurs, on livre.
- Timeout : si la boucle dépasse 3 secondes, 10 secondes, ou votre limite métier, stop.
- Coût maximum : si l’agent a déjà consommé son budget, il rend la meilleure version disponible.
- Détection de boucle répétitive : si les mêmes critiques reviennent, ça ne sert à rien d’insister.
Ces seuils dépendent du cas d’usage. Une réponse marketing peut accepter plus de latence si elle évite une erreur visible. Un agent conversationnel temps réel, non. Là, je garde la boucle très courte, voire je l’évite.
La grille de critique doit être écrite avant le prompt de réflexion. Sinon, on demande au modèle de juger au feeling. Et en production, le feeling coûte cher. Ma grille contient souvent : conformité aux règles, exactitude factuelle, complétude, clarté, sécurité, absence de contenu inutile.
import time

class ReflectionAgent:
    def __init__(self, max_iterations=3, min_score=85, timeout_seconds=8):
        self.max_iterations = max_iterations
        self.min_score = min_score
        self.timeout_seconds = timeout_seconds

    def generate(self, task):
        # Ici, je brancherais un vrai LLM.
        return f"Réponse initiale pour : {task}"

    def reflect(self, draft):
        # Ici, je demanderais au LLM de critiquer selon une grille fixe.
        issues = []

        if len(draft) < 80:
            issues.append({"severity": "critical", "message": "Réponse trop courte"})

        score = 90 if not issues else 70
        decision = "accept" if score >= self.min_score and not issues else "refine"

        return {
            "score": score,
            "issues": issues,
            "decision": decision
        }

    def refine(self, draft, critique):
        # Ici, je demanderais au LLM de corriger uniquement les points listés.
        return draft + " Version enrichie avec plus de détails utiles."

    def should_stop(self, critique, iteration, start_time):
        elapsed = time.time() - start_time
        has_critical_issue = any(
            issue["severity"] == "critical"
            for issue in critique["issues"]
        )

        if critique["score"] >= self.min_score:
            return True

        if iteration >= self.max_iterations:
            return True

        if not has_critical_issue:
            return True

        if elapsed >= self.timeout_seconds:
            return True

        return False

    def run(self, task):
        start_time = time.time()
        draft = self.generate(task)
        logs = []

        for iteration in range(1, self.max_iterations + 1):
            critique = self.reflect(draft)

            logs.append({
                "iteration": iteration,
                "draft": draft,
                "critique": critique
            })

            if self.should_stop(critique, iteration, start_time):
                break

            draft = self.refine(draft, critique)

        return {
            "final": draft,
            "iterations": len(logs),
            "duration_seconds": round(time.time() - start_time, 2),
            "logs": logs
        }
Côté monitoring, je journalise le brouillon, la critique, la version finale, le nombre d’itérations, le temps total, le coût estimé et les appels outils. Je fais attention aux données sensibles. Pas de logs clients, santé, paiement ou RH sans cadre clair, chiffrement, durée de conservation et accès contrôlés.
Ma règle pratique est simple : si l’agent touche à des décisions importantes, j’ajoute de la réflexion. Si la réponse est banale et temps réel, je garde la boucle courte ou je l’évite.
Alors, on l’ajoute où dans votre agent IA ?
Le reflection pattern est utile quand un agent IA doit produire mieux qu’une première réponse brute. La logique est simple : générer, critiquer, réviser. Les variantes changent selon le besoin : un seul modèle pour aller vite, plusieurs agents pour mieux relire, des outils externes pour vérifier des faits. Le vrai sujet, c’est le cadrage. Sans critères d’arrêt, sans grille de critique et sans suivi des coûts, on fabrique juste une boucle chère. Bien posé, ce pattern améliore la qualité, réduit les erreurs visibles et vous aide à mettre des agents IA plus fiables en production.
FAQ
- Qu’est-ce que le reflection pattern pour agent IA ?Le reflection pattern est une boucle où un agent IA génère une première réponse, la critique avec des critères définis, puis produit une version corrigée. L’idée est d’ajouter une étape de contrôle avant d’envoyer la réponse en production.
- Le reflection pattern supprime-t-il les hallucinations ?Il peut les réduire, mais il ne les supprime pas. Si le modèle critique mal sa propre réponse ou si les sources externes sont mauvaises, l’erreur peut rester. C’est pour ça que les critères de critique et les outils de vérification sont essentiels.
- Quelle différence entre self-reflection et multi-agent reflection ?En self-reflection, le même modèle génère et critique sa réponse. C’est simple et rapide, mais plus fragile. En multi-agent reflection, un autre agent joue le rôle de relecteur. C’est souvent plus robuste, mais aussi plus coûteux et plus lent.
- Quand utiliser une réflexion avec outils externes ?Je l’utilise quand la réponse dépend de faits vérifiables : données client, règles internes, tarifs, dates, disponibilité, documentation produit. L’agent peut alors interroger une base, une API ou un moteur de recherche avant de corriger sa réponse.
- Comment éviter que la boucle coûte trop cher ?Il faut fixer un nombre maximum d’itérations, un seuil de qualité, un timeout et des règles d’arrêt claires. Il faut aussi logger le temps, le coût, les appels outils et les décisions de critique. Sans ça, la qualité peut monter un peu, mais la facture aussi.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent industrialiser leurs données, leurs automatisations et leurs agents IA sans empiler des outils au hasard. Avec webAnalyste et Formations Analytics, j’ai travaillé pour des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer vos agents IA, vos workflows ou vos données de production, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.