
Sept projets open source explorent différentes façons de donner une mémoire persistante aux agents IA. Je compare leurs approches, du rappel de faits à la réflexion sur les expériences passées, en passant par les graphes temporels et le partage du contexte entre environnements.
À quoi sert la mémoire d’un agent IA ?
La mémoire d’un agent IA lui permet de conserver des informations utiles et de les retrouver plus tard, au lieu de repartir de zéro à chaque échange. Elle apporte une continuité entre les sessions : l’agent peut réutiliser des faits, des préférences ou des éléments issus d’expériences précédentes.
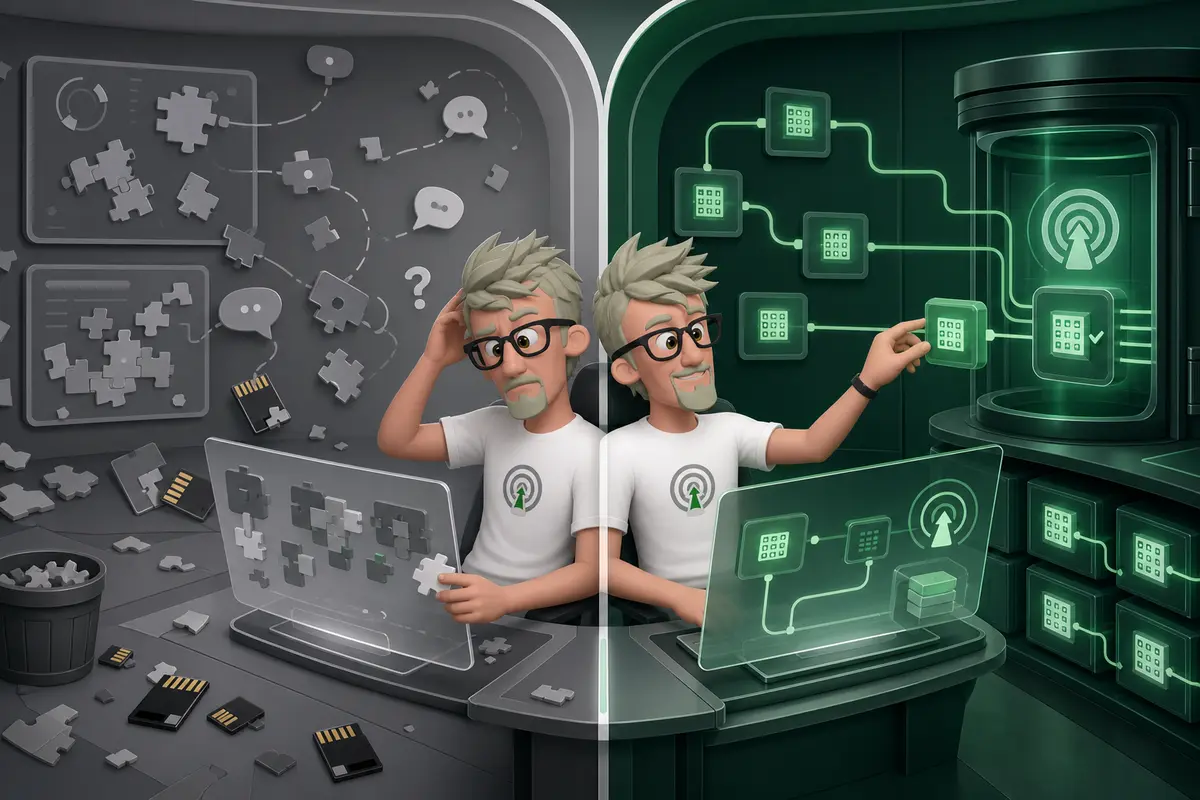
Sans mémoire persistante, chaque nouvelle session oblige l’agent à reconstruire son contexte à partir des informations disponibles. Il risque alors de redemander ce qu’on lui a déjà dit, de répéter une erreur ou de ne pas réutiliser une solution qu’il a déjà rencontrée. La mémoire ne consiste donc pas à tout conserver. Il faut choisir quoi enregistrer, comment le retrouver et dans quel contexte le réutiliser.
Comment classer des textes en few-shot avec Scikit-LLM ?
Les projets open source abordés dans cet article explorent plusieurs façons de résoudre ce problème. Certains enregistrent des faits et les retrouvent au moment utile. D’autres apprennent à partir d’expériences passées, organisent des connaissances réutilisables, relient les informations dans un graphe — une structure où les éléments sont connectés entre eux — ou transfèrent le contexte d’un environnement à un autre.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Je vais présenter sept projets. Je les aborde comme des pistes différentes pour donner à un agent une mémoire exploitable, sans supposer qu’ils répondent tous au même besoin. Selon le cas, on cherchera surtout à retrouver un souvenir précis, à capitaliser sur une expérience, à structurer un ensemble de connaissances ou à transporter le contexte entre plusieurs outils.
Je commence par les projets centrés sur les souvenirs et leur réutilisation. C’est une approche concrète pour comprendre comment un agent peut conserver une information, la retrouver au bon moment et s’en servir dans une nouvelle session. La question n’est pas seulement de mémoriser, mais de retrouver la bonne information quand elle devient utile.
Comment ces projets mémorisent-ils les expériences ?
Comment utiliser Gemini 4 Argon dans n8n ?
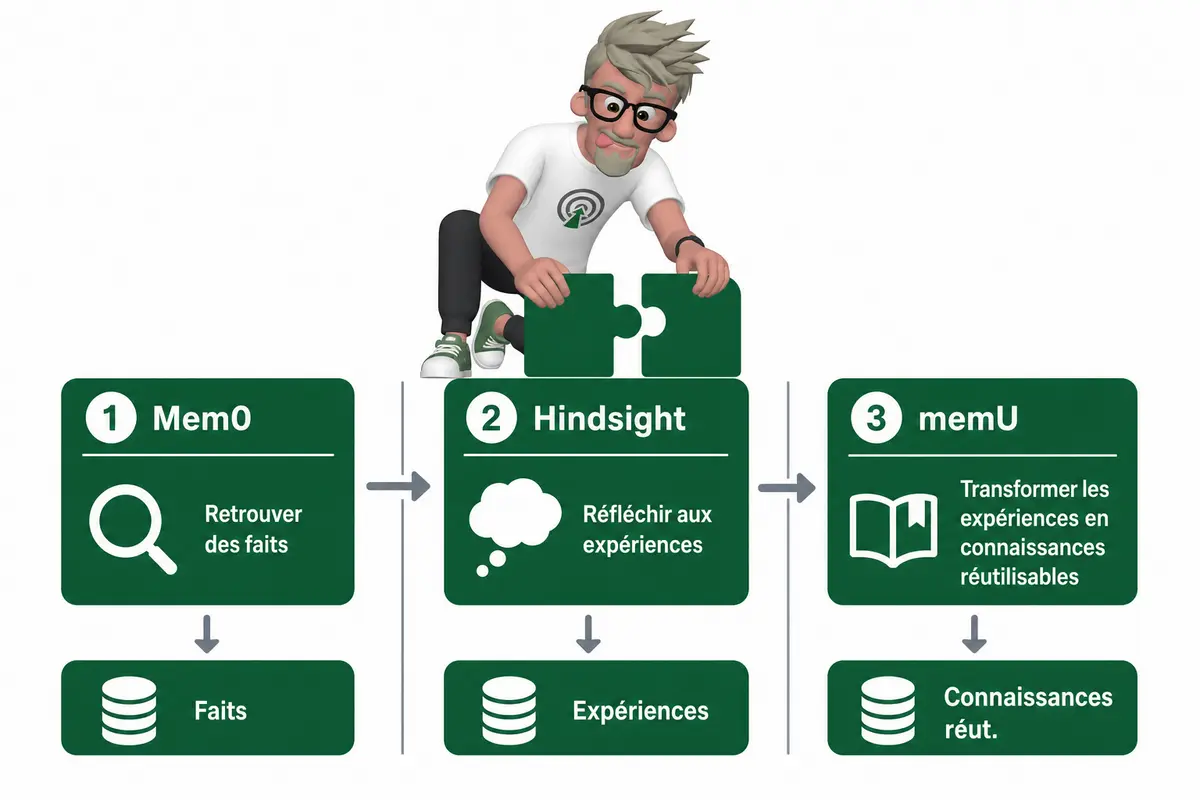
Ces projets mémorisent les expériences en les transformant en informations que l’IA peut retrouver ou réutiliser plus tard. Leur différence tient surtout à ce qu’ils font de ces expériences : rappeler des faits, réfléchir aux épisodes passés ou faire émerger des connaissances utiles avant une nouvelle tâche.
Avec Mem0, je vois une couche de mémoire polyvalente. Elle conserve des faits, des préférences et des interactions antérieures, puis les restitue quand ils deviennent pertinents. L’intérêt est simple : l’IA n’a pas besoin de reconstruire tout le contexte à chaque session. Elle peut, par exemple, retrouver une préférence exprimée précédemment ou se rappeler un échange lié à la demande du moment.
Hindsight met davantage l’accent sur la mémorisation, le rappel et la réflexion. Il ne s’agit pas seulement de ressortir une information passée, mais d’examiner les expériences pour éclairer des décisions ultérieures. La mémoire sert alors à tirer parti de ce qui s’est déjà produit, plutôt qu’à répéter mécaniquement le contexte.
Comment passer un prototype IA en production SaaS ?
memU prend une autre direction : il organise les expériences de façon proactive en connaissances réutilisables. Quand une nouvelle tâche arrive, il cherche les informations susceptibles de l’aider. La connaissance n’est donc pas seulement rappelée à la demande ; elle est structurée pour pouvoir resservir dans des situations nouvelles.
| Projet | Rôle de la mémoire |
| Mem0 | Retrouver des faits, des préférences et des interactions. |
| Hindsight | Réfléchir aux expériences pour soutenir des décisions futures. |
| memU | Faire émerger des connaissances réutilisables pour de nouvelles tâches. |
La distinction est utile : se rappeler un fait, apprendre d’une expérience et préparer une connaissance pour un usage futur sont trois opérations différentes. La suite mène aux systèmes qui relient les informations entre elles, afin de dépasser le simple stockage de souvenirs isolés.
Comment les graphes relient-ils les connaissances ?
Un graphe relie des informations en représentant les relations entre elles. Pour une mémoire IA, ça permet de retrouver un fait et de comprendre à quoi il se rattache. Deux projets open source explorent cette approche, avec des objectifs différents.
Que faut-il savoir sur IQuest-Q1, le modèle MoE ?
Cognee transforme des documents, du code et des conversations en mémoire connectée et consultable. Il associe la recherche vectorielle — qui retrouve des contenus proches par leur sens — aux relations représentées dans un graphe. L’agent peut ainsi retrouver une information pertinente sans perdre les liens avec d’autres éléments. C’est utile quand une réponse dépend du contexte, pas seulement d’un passage isolé.
Graphiti s’appuie sur des graphes de connaissances temporels. Il vise à représenter l’évolution des faits et des relations dans le temps, pour distinguer des informations anciennes de nouvelles et suivre les changements. Cette dimension compte quand un agent doit tenir compte de ce qui était vrai auparavant, de ce qui l’est maintenant, ou de la manière dont une situation a évolué.
La différence est importante. Relier des éléments de connaissance aide à répondre à des questions du type « À quoi cette information est-elle liée ? ». Représenter leur évolution dans le temps aide plutôt à répondre à « Quand était-ce vrai ? » ou « Qu’est-ce qui a changé ? ». Les deux besoins peuvent se recouper, mais ils ne sont pas identiques.
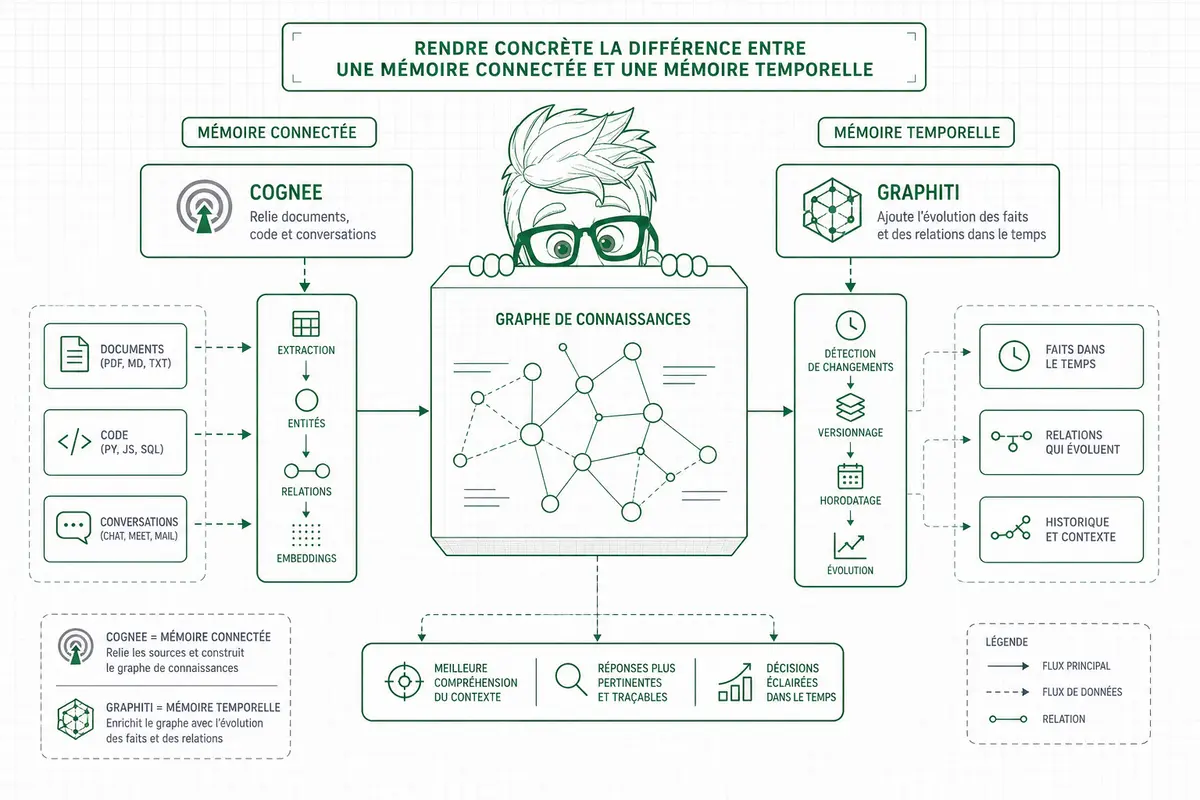
Pour choisir, je pars de l’usage attendu. Un agent qui doit retrouver des informations dispersées et leurs relations peut bénéficier d’une mémoire connectée comme celle proposée par Cognee. Si l’ancienneté et l’évolution des faits sont déterminantes, l’approche temporelle de Graphiti devient pertinente. Dans les deux cas, la mémoire doit rester exploitable au-delà d’une seule conversation. Reste donc à regarder comment le contexte est conservé et rendu portable d’un agent ou d’un système à l’autre.
Comment conserver et transférer le contexte ?
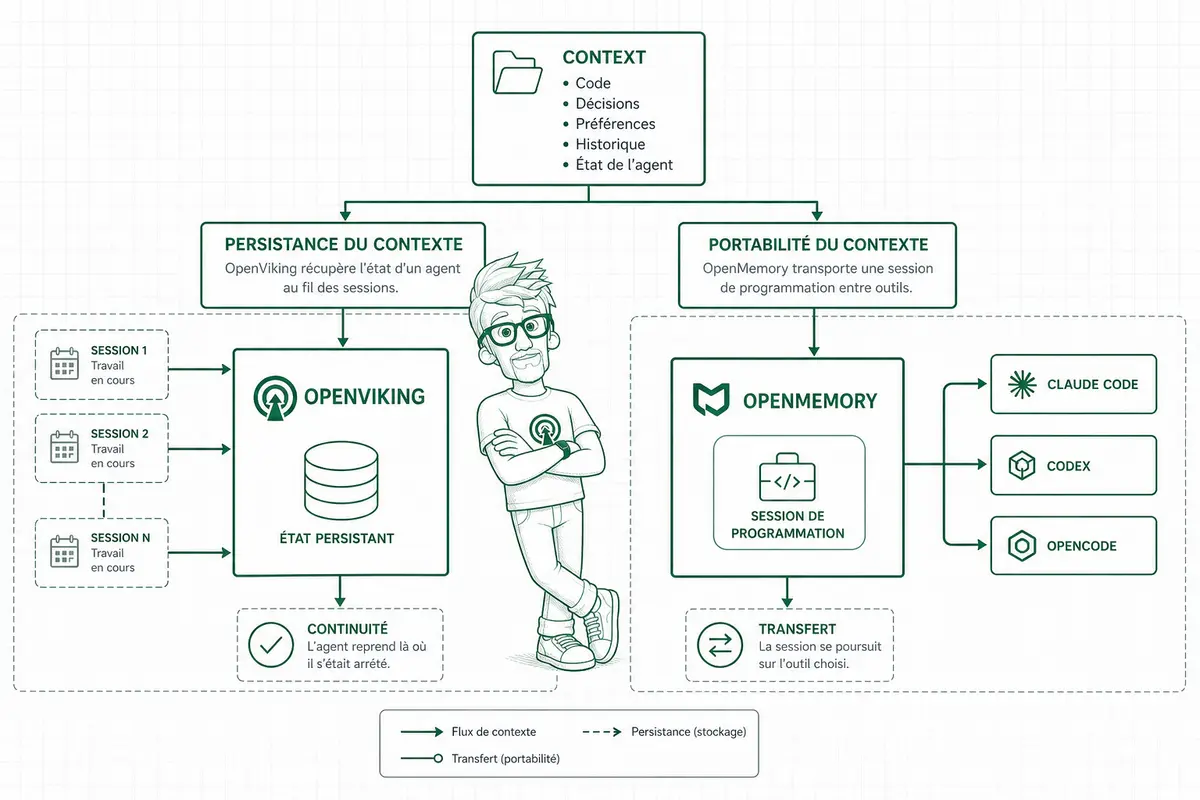
Pour conserver et transférer le contexte, je distingue deux besoins. OpenViking vise à rendre l’état des agents persistant et récupérable entre les interactions. OpenMemory cible plutôt la portabilité des sessions de programmation entre Claude Code, Codex et OpenCode.
Avec OpenViking, le contexte antérieur est organisé pour pouvoir être réutilisé lors de sessions ou de tâches ultérieures. L’idée n’est pas seulement de garder une trace, mais de permettre à l’agent de retrouver des éléments utiles après une interruption. C’est une approche centrée sur la persistance dans le temps.
OpenMemory répond à un autre problème : reprendre une session de programmation dans un environnement différent, sans reconstituer manuellement l’historique. Le projet permet l’import et l’export de sessions entre Claude Code, Codex et OpenCode. Ici, l’enjeu principal est le transfert du contexte entre outils, pas nécessairement sa conservation durable comme mémoire générale.
Cette distinction aide à cadrer le choix. Une mémoire persistante conserve des éléments pour des interactions futures. Un mécanisme de transfert transporte une session existante d’un environnement à un autre. Selon le besoin, on peut chercher à mémoriser des faits, réfléchir aux expériences passées, faire émerger des connaissances, relier des informations ou suivre leur évolution. Si le besoin porte plutôt sur la reprise d’une session de programmation, le transfert devient le critère central.
| Besoin | Projet à examiner |
| Mémoriser des faits ou réutiliser le contexte dans le temps | OpenViking, pour organiser et récupérer le contexte antérieur |
| Réfléchir aux expériences, faire émerger des connaissances, relier des informations ou suivre leur évolution | Définir d’abord le comportement de mémoire attendu |
| Transporter une session de programmation entre Claude Code, Codex et OpenCode | OpenMemory, avec l’import et l’export des sessions |
Comment choisir la mémoire adaptée à votre agent ?
Ces sept projets répondent à des besoins différents. Mem0 mise sur le rappel de faits et de préférences, Hindsight sur la réflexion à partir des expériences, et memU sur l’émergence de connaissances réutilisables. Cognee relie les informations avec des vecteurs et un graphe, tandis que Graphiti représente aussi leur évolution dans le temps. OpenViking conserve le contexte entre les interactions, et OpenMemory facilite son transfert entre environnements de programmation.
Je commencerais par préciser ce que votre agent doit retenir et réutiliser, puis je comparerais les projets sur ce besoin concret. Vous éviterez ainsi d’ajouter une mémoire trop complexe et gagnerez en continuité sans reconstruire l’historique à chaque session.
FAQ
- Qu’est-ce que la mémoire persistante d’un agent IA ?
C’est un mécanisme qui conserve des informations utiles entre les interactions ou les sessions afin que l’agent puisse les retrouver et les réutiliser sans reconstruire tout le contexte. - Quelle différence entre Mem0, Hindsight et memU ?
Mem0 sert à enregistrer et retrouver des faits, préférences et interactions. Hindsight met l’accent sur la mémorisation, le rappel et la réflexion sur les expériences. memU organise les expériences en connaissances réutilisables et cherche à faire émerger les informations pertinentes pour de nouvelles tâches. - À quoi servent Cognee et Graphiti ?
Cognee transforme documents, code et conversations en mémoire connectée, en combinant recherche vectorielle et relations de graphe. Graphiti utilise des graphes de connaissances temporels pour représenter l’évolution des faits et des relations. - OpenViking et OpenMemory répondent-ils au même besoin ?
Ils traitent tous deux de la continuité du contexte, mais sous des angles distincts. OpenViking vise à rendre l’état d’un agent persistant et récupérable. OpenMemory porte sur l’import et l’export de sessions de programmation entre Claude Code, Codex et OpenCode. - Comment choisir un projet de mémoire pour un agent IA ?
Partez de l’information que votre agent doit conserver et de la façon dont il devra la réutiliser : rappel de faits, réflexion sur les expériences, organisation de connaissances, relations entre éléments, suivi de leur évolution ou transfert d’une session.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Data, IA, tracking avancé server-side, Analytics Engineering et automatisation No/Low Code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor sur leurs projets data et IA. Je suis disponible pour aider votre entreprise, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.