


Je le crée en codant une pipeline qui impose six réflexes d’analyste senior avant toute réponse. L’idée est simple : vérifier les données, produire du SQL, contrôler les petits effectifs, puis seulement demander au LLM de synthétiser et recommander.
Pourquoi un chatbot se trompe si vite ?
Un chatbot se trompe vite quand on lui demande une conclusion business sans lui imposer de méthode, de contrôles et de limites statistiques.
Le problème n’est pas le LLM en lui-même. Un LLM, c’est un grand modèle de langage, donc un moteur très fort pour comprendre une demande, reformuler, générer du texte, proposer une analyse. Mais si on l’utilise en mode naïf, une question, une réponse, aucune vérification, on lui demande presque de deviner. Et il va le faire avec assurance.
Comment utiliser le reflection pattern en production ?
Un analyste senior ne travaille pas comme ça. Il ne saute pas directement à “il faut augmenter le budget acquisition” ou “le churn vient du pricing”. Il commence par clarifier la question business. Il regarde le périmètre des données. Il formule des hypothèses. Il écrit ou vérifie une requête SQL, donc la requête qui interroge la base de données. Il contrôle les volumes, les dates, les valeurs nulles, les doublons, les types de champs. Puis seulement après, il traduit les résultats en synthèse claire et en recommandations.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
C’est exactement ce que je veux coder dans un AI Data Analyst fiable. L’IA ne doit pas remplacer la discipline analytique. Elle doit l’exécuter. La pipeline doit forcer ce chemin : compréhension métier, hypothèses, plan SQL, validation, synthèse exécutive, recommandations. Si une étape manque, la réponse doit être considérée comme fragile.
J’ai vu plusieurs équipes obtenir des recommandations très séduisantes avec un LLM, puis découvrir que la donnée reposait sur trois lignes ou sur un champ mal typé. Un montant stocké en texte, une date interprétée n’importe comment, un segment client vide à 80%. C’est bête, mais c’est souvent là que l’analyse casse.
| Réflexe junior | Risque | Réflexe senior codé dans la pipeline |
| Demander directement une recommandation | Obtenir une réponse convaincante mais non vérifiée | Reformuler la question business et définir le périmètre |
| Lancer une requête SQL sans hypothèse | Mesurer le mauvais indicateur ou comparer les mauvaises périodes | Formuler les hypothèses avant de générer le plan SQL |
| Faire confiance au premier résultat | Basculer sur une conclusion basée sur trop peu de données | Contrôler les volumes, les types, les valeurs nulles et les anomalies |
| Transformer trop vite le résultat en action | Produire une recommandation jolie, mais dangereuse | Séparer la synthèse des faits et les recommandations business |
Comment créer un workflow multi-agent avec Copilot Studio ?
Pour moi, la fiabilité vient de là. Pas d’un prompt magique. D’un cadre qui empêche l’IA de répondre trop vite.
Quelles données faut-il vérifier avant l’IA ?
Avant l’IA, je vérifie le schéma, les types, les valeurs manquantes et la taille réelle de l’échantillon. C’est le minimum vital avant de demander quoi que ce soit à un LLM, parce qu’un modèle peut très bien produire une réponse fluide sur une donnée bancale.
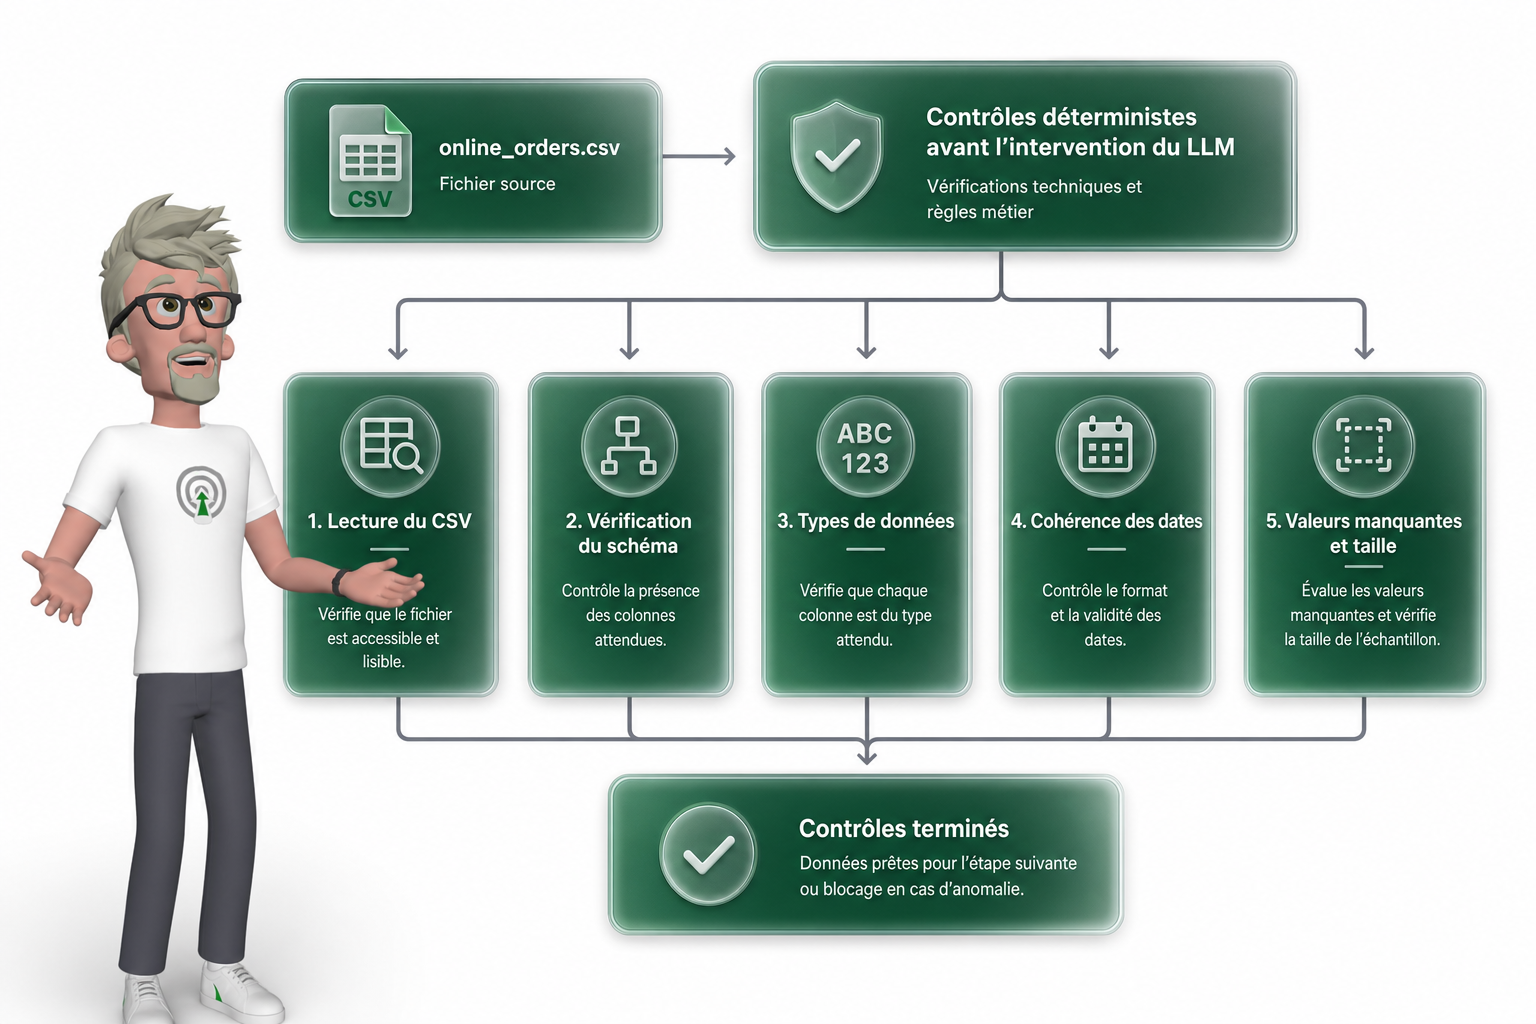
Dans mon cas, le fichier online_orders.csv est un petit jeu de données de commandes en ligne. Il contient 29 lignes et ces colonnes : product_id, promotion_id, cost_in_dollars, customer_id, date_sold, units_sold.
Comment GitHub Agentic Workflows automatise vos reviews ?
Sa petite taille est justement intéressante. Elle force à rester prudent. Une moyenne peut avoir l’air spectaculaire juste parce qu’elle repose sur une seule commande. J’ai déjà vu ça chez un client : une “meilleure promotion” détectée par l’IA, alors qu’elle n’avait été utilisée qu’une fois. Techniquement la réponse était vraie. Méthodologiquement, elle ne valait rien.
Avec pandas, je fais d’abord les contrôles simples. Je lis le CSV, je contrôle les types avec dtypes, je compte les valeurs manquantes avec isna, puis je convertis date_sold en vraie date avec to_datetime. Dans ce jeu, date_sold arrive comme du texte, et il n’y a pas de valeurs manquantes.
import pandas as pd

# Je charge le fichier de commandes
df = pd.read_csv('online_orders.csv')

# Taille du dataset : ici on attend 29 lignes
print(df.shape)

# Types détectés par pandas
print(df.dtypes)

# Contrôle des valeurs manquantes par colonne
print(df.isna().sum())

# date_sold est stockée comme texte, je la convertis proprement
df['date_sold'] = pd.to_datetime(df['date_sold'], errors='coerce')

# Si ce nombre est supérieur à zéro, certaines dates ne sont pas convertibles
print(df['date_sold'].isna().sum())

# Vue rapide des distributions numériques et catégorielles
print(df.describe(include='all'))
Cette étape est déterministe. Ça veut dire qu’elle ne dépend pas d’un LLM, ni d’une interprétation probabiliste. Le même fichier donne les mêmes contrôles. C’est cette base fiable qui permet ensuite à l’IA de raisonner sur quelque chose de propre.
| Contrôle | Ce que je vérifie | Décision associée |
| Schéma | Présence des colonnes attendues | Je bloque l’analyse si une colonne clé manque |
| Taille | Nombre de lignes, ici 29 | Je reste prudent sur les moyennes et classements |
| Types | Types détectés par pandas avec dtypes | Je corrige les types avant l’analyse |
| Dates | Conversion de date_sold avec to_datetime | Je vérifie les dates non convertibles |
| Valeurs manquantes | Comptage avec isna().sum() | Je traite ou signale les trous avant le LLM |
Comment contrôler les promotions avec DuckDB ?
Comment créer un agent IA local en streaming ?
Je contrôle les promotions avec une requête SQL DuckDB avant de laisser l’IA interpréter les résultats. Je préfère faire ça parce que ça pose une base claire, vérifiable, et surtout reproductible. L’IA peut commenter, reformuler, détecter des patterns, mais les chiffres doivent venir d’un calcul que je peux relire.
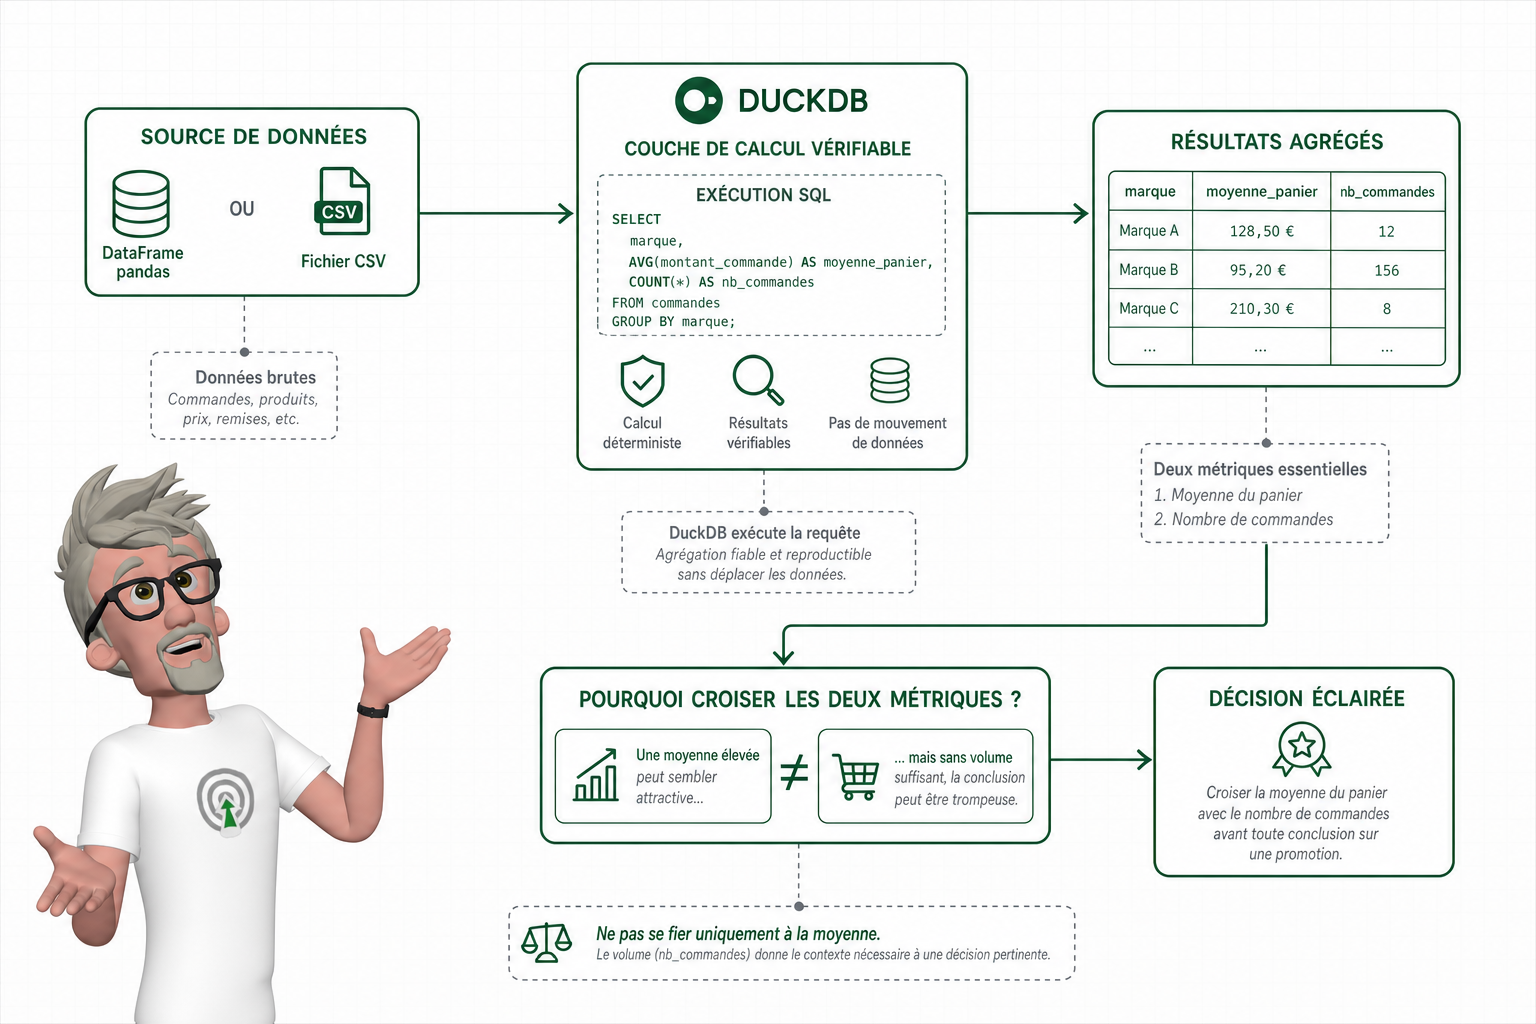
DuckDB est pratique ici parce que c’est une base analytique embarquée. En clair, je l’utilise directement depuis Python, sans serveur à installer. Je peux exécuter du SQL sur un DataFrame pandas ou même sur un fichier CSV. C’est parfait pour un AI Data Analyst, parce que SQL devient une couche de contrôle lisible. Quelqu’un d’autre peut relancer la même requête et vérifier le résultat. C’est quand même plus sain qu’une réponse générée directement par un modèle sans trace de calcul.
import duckdb

# Je crée une connexion DuckDB en mémoire
con = duckdb.connect()

# J’expose le DataFrame pandas comme une table SQL
con.register('orders', df)

query = '''
SELECT
    promotion_id,
    COUNT(*) AS order_count,
    SUM(units_sold) AS total_units,
    SUM(units_sold * cost_in_dollars) AS total_revenue,
    AVG(units_sold) AS avg_units_per_order
FROM orders
GROUP BY promotion_id
ORDER BY avg_units_per_order DESC
'''

# J’exécute la requête et je récupère un DataFrame
promo_results = con.execute(query).df()
print(promo_results)

# Je marque les groupes trop petits pour éviter les conclusions rapides
promo_results['low_sample_flag'] = promo_results['order_count'].lt(3)
print(promo_results)
La requête regroupe les commandes par promotion_id. Je récupère le nombre de commandes, le total d’unités vendues, le revenu total, et la moyenne d’unités par commande. Le revenu total est calculé simplement avec units_sold multiplié par cost_in_dollars, comme dans le dataset disponible.
Le piège principal, je l’ai vu souvent chez des clients, c’est de se jeter sur la meilleure moyenne. Ici, la promotion 4 a la meilleure moyenne d’unités par commande, mais elle repose sur une seule commande. C’est exactement le genre de signal qui attire l’œil et qui peut pourtant être fragile. Un analyste senior ne dit pas automatiquement “la promotion 4 est la meilleure”. Il dit plutôt “résultat intéressant, mais effectif insuffisant, à valider sur plus de volume”. C’est moins spectaculaire, mais beaucoup plus fiable.
| Métrique | Utilité | Risque si on l’interprète seule |
| Nombre de commandes | Mesure la taille de l’échantillon | Un petit volume peut donner un signal instable |
| Unités totales | Montre l’impact global sur les ventes | Favorise les promotions très exposées |
| Revenu total | Mesure la valeur générée | Peut cacher une faible rentabilité |
| Moyenne d’unités par commande | Compare l’efficacité moyenne | Peut être trompeuse avec trop peu de commandes |
Comment brancher OpenAI et Anthropic proprement ?
Je crée un wrapper LLM unique pour appeler OpenAI ou Anthropic sans disperser la logique API dans tout le projet.
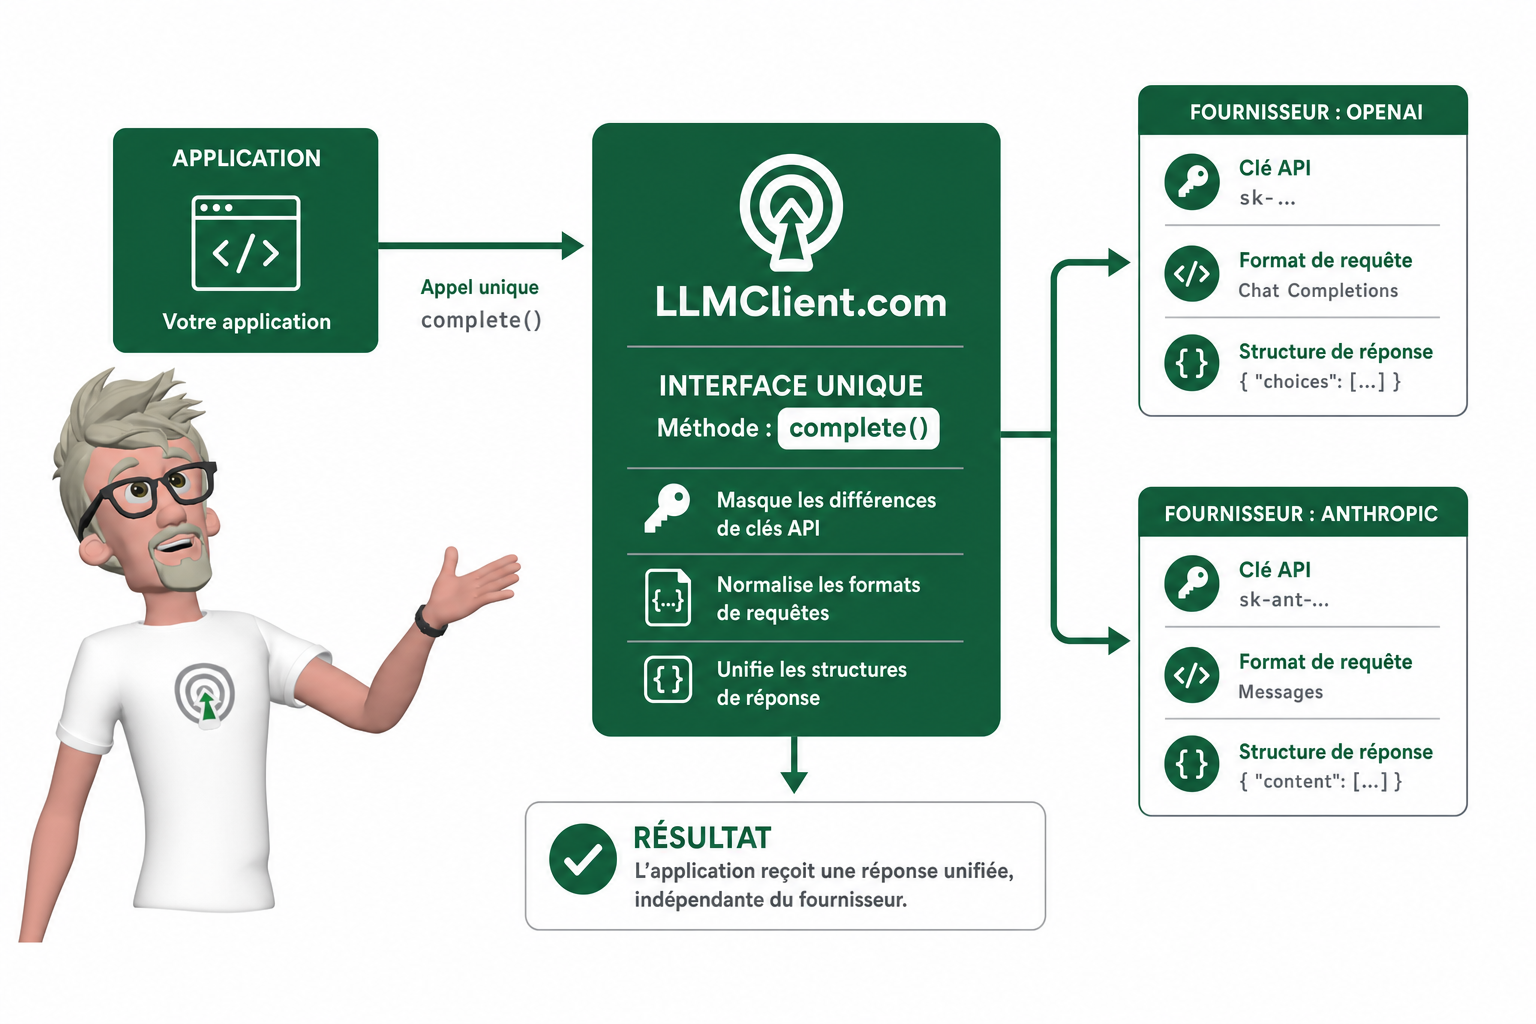
L’objectif est simple : je veux une interface commune. J’envoie un prompt système, un prompt utilisateur, et je récupère du texte. Point. Derrière, chaque fournisseur fait sa cuisine avec ses formats de réponse, et c’est justement ce que je ne veux pas voir partout dans mon code.
Avec OpenAI, via l’API Chat Completions du SDK officiel, le texte revient généralement dans choices, puis message.content. Avec Anthropic, le SDK renvoie plutôt une liste de blocs de contenu, et il faut extraire les blocs dont le type est text. Rien de compliqué, mais si je répète ça dans dix fichiers, je me prépare juste des bugs pénibles.
J’installe les dépendances nécessaires comme ça :
pip install pandas duckdb openai anthropic python-dotenvJe garde les clés API dans des variables d’environnement. C’est plus propre que de les écrire en dur dans le code, surtout quand le projet part sur GitHub, en staging, ou chez un client. J’ai déjà vu des clés copiées dans un notebook partagé trop vite, et franchement, ça arrive plus souvent qu’on ne le pense.
import os
from typing import Literal

class LLMClient:
    def __init__(self, provider: Literal['openai', 'anthropic'], model: str):
        self.provider = provider
        self.model = model

        if provider == 'openai':
            from openai import OpenAI
            self.client = OpenAI(api_key=os.environ.get('OPENAI_API_KEY'))

        elif provider == 'anthropic':
            from anthropic import Anthropic
            self.client = Anthropic(api_key=os.environ.get('ANTHROPIC_API_KEY'))

        else:
            raise ValueError('Provider non supporté')

    def complete(self, system_prompt: str, user_prompt: str, temperature: float = 0.2) -> str:
        # OpenAI : extraction du texte depuis choices
        if self.provider == 'openai':
            response = self.client.chat.completions.create(
                model=self.model,
                temperature=temperature,
                messages=[
                    {'role': 'system', 'content': system_prompt},
                    {'role': 'user', 'content': user_prompt}
                ]
            )
            return response.choices[0].message.content

        # Anthropic : extraction du texte depuis les blocs de contenu
        response = self.client.messages.create(
            model=self.model,
            temperature=temperature,
            max_tokens=1200,
            system=system_prompt,
            messages=[
                {'role': 'user', 'content': user_prompt}
            ]
        )

        text_blocks = []
        for block in response.content:
            if getattr(block, 'type', None) == 'text':
                text_blocks.append(block.text)

        return ''.join(text_blocks)
Avec ça, le reste de l’application ne sait même pas quel fournisseur est utilisé. Et c’est exactement ce que je cherche. Si demain je remplace un modèle OpenAI par Claude, je change la config, pas toute l’architecture.
| Point comparé | OpenAI | Anthropic |
| Variable d’environnement | OPENAI_API_KEY | ANTHROPIC_API_KEY |
| Structure de réponse | Texte récupéré via choices[0].message.content | Texte récupéré depuis les blocs content de type text |
| Intérêt du wrapper | Masquer le format OpenAI derrière une méthode complete() | Masquer l’extraction des blocs texte derrière la même méthode complete() |
Comment faire raisonner l’IA en senior ?
Je fais raisonner l’IA en senior en lui imposant une chaîne d’étapes et en lui donnant les résultats déterministes comme garde-fous.
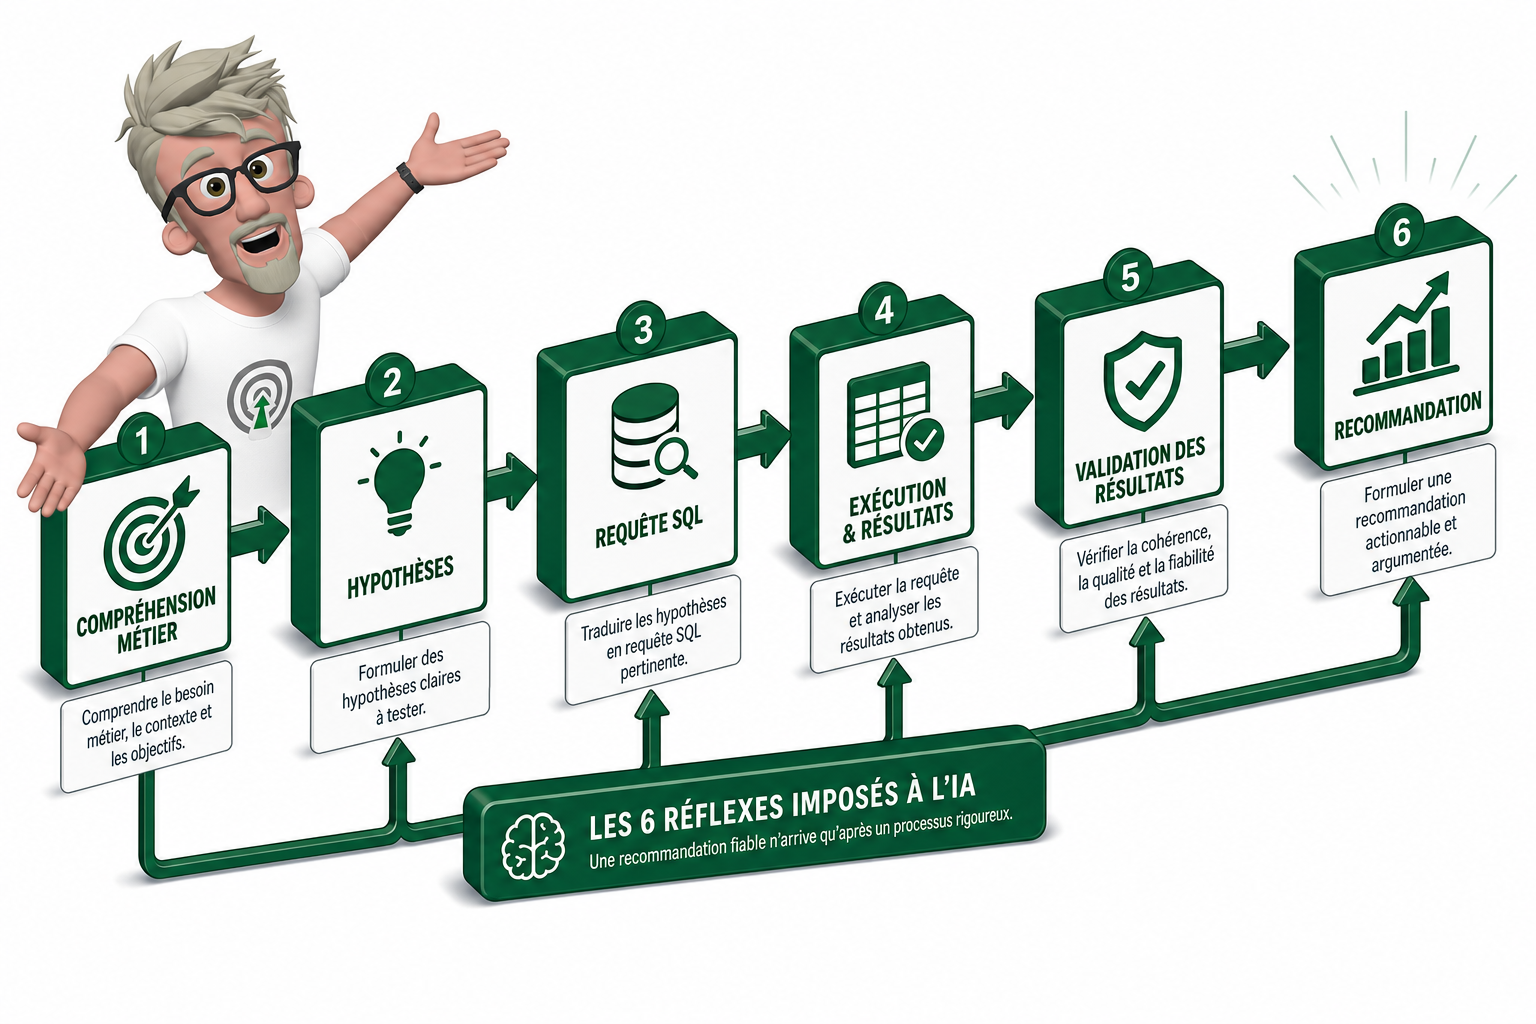
Je ne lui demande pas de deviner dans le vide. Je lui donne le contexte business, le schéma inspecté, les contrôles pandas, les résultats DuckDB, et surtout les alertes comme low_sample_flag. DuckDB, ici, c’est le moteur SQL local qui calcule vraiment les agrégats. Le LLM, le modèle de langage, devient un rédacteur analytique cadré. Pas un oracle.
Le flux est simple. L’IA reformule la question business, puis elle pose des hypothèses testables. Elle propose ou vérifie un plan SQL. Elle contrôle les résultats. Elle produit une synthèse exécutive. Elle recommande des actions prudentes. Le point dur, c’est la validation. Si la promotion 4 a une moyenne élevée sur une seule commande, elle doit le dire avant toute conclusion. J’ai vu ce cas chez un client e-commerce, et sans ce garde-fou tout le monde partait sur “il faut pousser cette promo”. Mauvaise idée.
SYSTEM_PROMPT = '''
Tu es un analyste data senior.
Tu ne conclus jamais sans regarder la taille des échantillons.
Tu distingues signal, limite et recommandation.
Si un groupe repose sur trop peu de lignes, tu le dis clairement.
'''

STEPS = [
    ('business_understanding', 'Reformule la question business et précise ce qu’il faut mesurer.'),
    ('hypotheses', 'Liste les hypothèses plausibles, sans conclure.'),
    ('sql_plan', 'Explique le plan SQL nécessaire pour répondre proprement.'),
    ('validation', 'Analyse les résultats fournis et signale les petits effectifs.'),
    ('executive_summary', 'Rédige une synthèse courte pour un décideur.'),
    ('recommendations', 'Propose des recommandations prudentes et actionnables.')
]

def run_ai_data_analyst(question: str, schema_text: str, promo_results_text: str, llm: LLMClient) -> dict:
    memory = {
        'question': question,
        'schema': schema_text,
        'promo_results': promo_results_text
    }

    outputs = {}

    for step_name, instruction in STEPS:
        user_prompt = f'''
Question business : {memory['question']}

Schéma et contrôles pandas :
{memory['schema']}

Résultats DuckDB contrôlés :
{memory['promo_results']}

Étape à réaliser : {instruction}

Réponds de façon concise. Si une promotion a une moyenne élevée mais un faible nombre de commandes, signale la limite avant toute recommandation.
'''
        outputs[step_name] = llm.complete(SYSTEM_PROMPT, user_prompt)
        memory[step_name] = outputs[step_name]

    return outputs
Voici l’appel typique, sans inventer de chiffre. Je transforme juste le DataFrame promo_results en texte lisible pour le modèle.
question = 'Quelle promotion semble générer le plus d’unités vendues par commande ?'

promo_results_text = promo_results.to_string(index=False)

analysis = run_ai_data_analyst(
    question=question,
    schema_text=schema_text,
    promo_results_text=promo_results_text,
    llm=llm
)
Le résultat attendu n’est pas “mettez tout le budget sur la promotion 4”. Le résultat attendu, c’est une synthèse nuancée. Moyenne élevée, oui. Volume trop faible, oui. Besoin de validation sur plus de commandes, clairement.
| Étape | Biais réduit |
| Compréhension business | Hallucination sur l’objectif réel |
| Hypothèses testables | Conclusion trop rapide |
| Plan SQL | SQL implicite ou métrique floue |
| Validation | Petit échantillon ignoré |
| Synthèse exécutive | Jargon inutile |
| Recommandations prudentes | Action agressive non justifiée |
Et si votre IA arrêtait de conclure trop vite ?
Créer un AI Data Analyst fiable, ce n’est pas juste brancher un modèle sur un CSV. Je commence par les contrôles simples avec pandas, je vérifie les agrégations avec DuckDB, puis je donne au LLM un cadre strict pour raisonner. Le point clé, c’est la prudence sur les petits effectifs. Une promotion peut sembler excellente sur une seule commande, ça ne suffit pas pour décider. Cette approche garde le meilleur des LLM, la vitesse et la synthèse, sans abandonner la rigueur analytique. Le bénéfice pour vous : des analyses plus rapides, mais surtout moins naïves et plus utiles pour décider.
FAQ
- Qu’est-ce qu’un AI Data Analyst fiable ?
C’est un assistant IA qui ne répond pas directement au feeling. Il suit une méthode : compréhension business, hypothèses, requêtes ou plan SQL, validation des résultats, synthèse et recommandations. Le plus important, c’est qu’il signale les limites, surtout quand les volumes sont faibles. - Pourquoi utiliser DuckDB dans ce type de pipeline ?
DuckDB permet d’exécuter du SQL analytique directement depuis Python, sur un DataFrame pandas ou un fichier CSV. Je l’utilise comme contrôle déterministe avant le LLM. Ça évite de demander au modèle de calculer ou d’interpréter sans base vérifiée. - Pourquoi les petits effectifs sont dangereux en analyse data ?
Parce qu’une moyenne peut devenir très flatteuse sur une seule ligne. Dans l’exemple des promotions, la promotion 4 a la meilleure moyenne d’unités par commande, mais elle repose sur une seule commande. Un analyste senior ne conclut pas trop vite dans ce cas. - OpenAI ou Anthropic, lequel choisir pour l’analyste IA ?
Les deux peuvent fonctionner. Le bon réflexe est de créer un wrapper commun pour éviter de lier toute la logique métier à un seul fournisseur. OpenAI et Anthropic n’ont pas exactement la même structure de réponse, donc l’abstraction simplifie le code. - Est-ce que cette approche remplace un analyste data ?
Non, elle automatise une partie de sa discipline. Elle aide à produire plus vite une analyse structurée, mais elle doit rester cadrée par des contrôles, des règles et une validation humaine quand la décision business est importante.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes data, marketing et business sur des sujets où la donnée doit rester fiable, exploitable et actionnable. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez mettre en place ce type d’automatisation IA proprement dans votre entreprise, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.