
Agentic Context Engineering améliore un agent en faisant évoluer le contexte qu’il consulte, sans modifier les poids du modèle. Je détaille le fonctionnement du playbook, les mises à jour ciblées et ce que les benchmarks permettent réellement de conclure.
Comment fonctionne la boucle ACE ?
La boucle ACE améliore les performances d’un agent en faisant évoluer le contexte qu’il consulte, sans modifier les poids du modèle. L’agent conserve les enseignements utiles de ses tentatives dans un playbook, c’est-à-dire un ensemble d’instructions et de connaissances qu’il peut réutiliser pour traiter de nouvelles tâches.
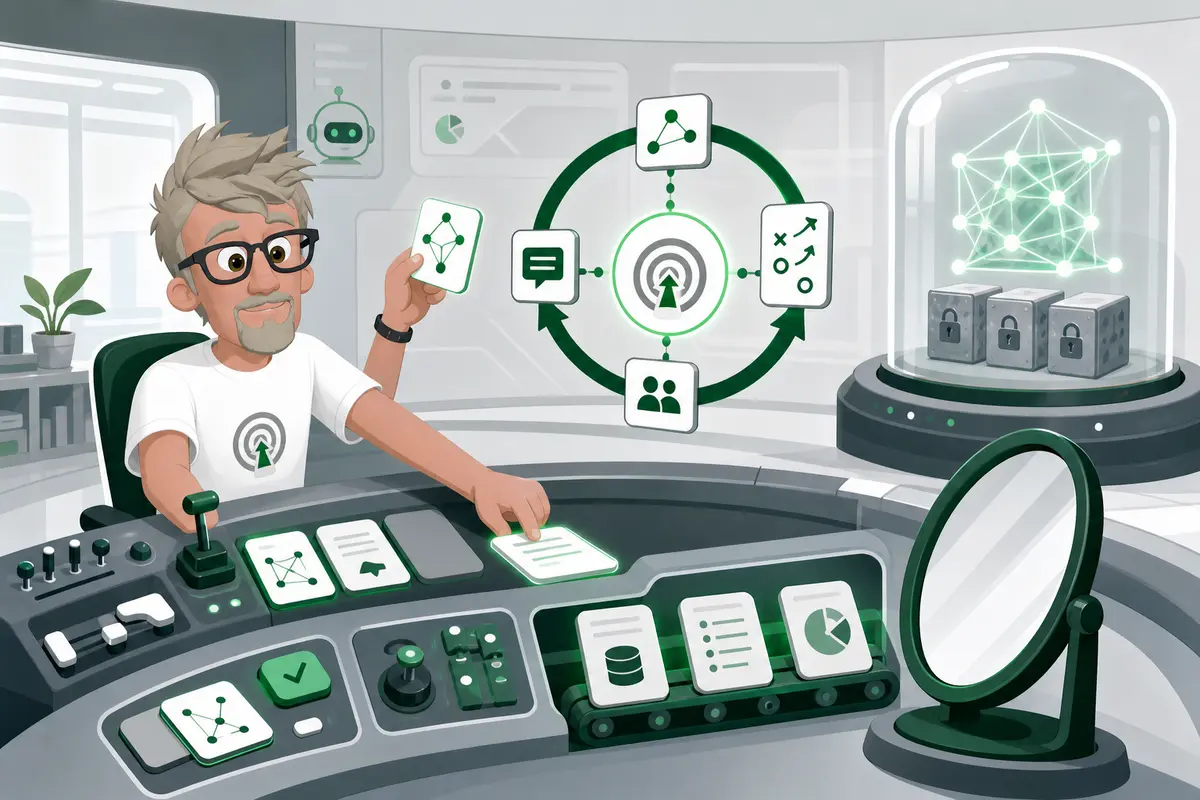
La boucle repose sur trois rôles complémentaires. Le Generator commence par essayer la tâche en s’appuyant sur le playbook existant. Sa réponse peut être correcte ou révéler une limite, par exemple une étape oubliée ou une règle mal appliquée.
Comment classer des textes en few-shot avec Scikit-LLM ?
Le Reflector examine ensuite la tentative et les retours disponibles. Il cherche à en tirer une leçon exploitable : ce qui a fonctionné, ce qui a échoué et ce qui pourrait aider lors d’une prochaine tâche similaire. L’objectif n’est pas de conserver toute la conversation, mais d’identifier une information utile pour améliorer le contexte.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Le Curator transforme cette leçon en une mise à jour ciblée. Une logique de fusion applique ensuite cette modification au playbook existant. Le contexte évolue donc de façon contrôlée, plutôt que d’être remplacé entièrement après chaque tentative.
C’est la différence avec un réentraînement du modèle. Dans ACE, on ne modifie pas ses poids : on met à jour les informations auxquelles l’agent a accès quand il travaille. Le modèle lui-même reste inchangé, tandis que son playbook peut s’enrichir au fil des retours.
Comment utiliser Gemini 4 Argon dans n8n ?
Le playbook est donc la mémoire opérationnelle de cette boucle. Sa structure détermine comment les leçons sont organisées et retrouvées, et comment l’agent peut les mobiliser pour une tâche. C’est son rôle et son fonctionnement qu’il faut maintenant préciser.
Que contient le playbook ACE ?
Le playbook ACE est un ensemble de leçons réutilisables que l’agent peut consulter lors de tâches ultérieures. Il conserve les apprentissages utiles au lieu de repartir de zéro à chaque fois.
Chaque entrée décrit une connaissance pratique, liée à un identifiant qui permet de la retrouver et de la modifier. Elle peut prendre plusieurs formes :
- Des règles d’utilisation des outils, par exemple les paramètres à privilégier ou les étapes à respecter pour appeler une API.
- Du code réutilisable, comme une fonction ou un modèle qui a déjà permis de résoudre un problème.
- Des conseils de dépannage, qui indiquent comment reconnaître une erreur fréquente et quoi essayer ensuite.
Comment passer un prototype IA en production SaaS ?
Le playbook évolue avec l’expérience. L’agent peut ajouter une entrée, la réviser si elle est imprécise, fusionner des informations redondantes ou supprimer une leçon devenue inutile. Ces décisions dépendent de l’utilité de chaque entrée et de la taille du contexte disponible. Le contexte, c’est l’information que le modèle reçoit pour produire sa réponse ; il est limité et doit rester pertinent.
C’est pour ça qu’ACE privilégie de petites modifications ciblées plutôt qu’une réécriture complète du playbook. Une réécriture peut faire disparaître des détails qui semblaient secondaires, mais qui aident réellement l’agent à réussir. Dans un cas évalué sur AppWorld, une réécriture a réduit le contexte de 18 282 à 122 tokens, tandis que la précision est passée de 66,7 % à 57,1 %. Ce résultat concerne ce cas précis ; il ne permet pas de conclure que toutes les configurations réagissent de la même façon.
Une entrée n’est donc pas bonne simplement parce qu’elle est concise ou bien formulée. Sa qualité se mesure à son utilité sur les tâches : il faut vérifier si elle aide effectivement l’agent à obtenir de meilleurs résultats, puis la conserver, l’ajuster ou la retirer en fonction de cette évaluation.
Que montrent les benchmarks d’ACE ?
Que faut-il savoir sur IQuest-Q1, le modèle MoE ?
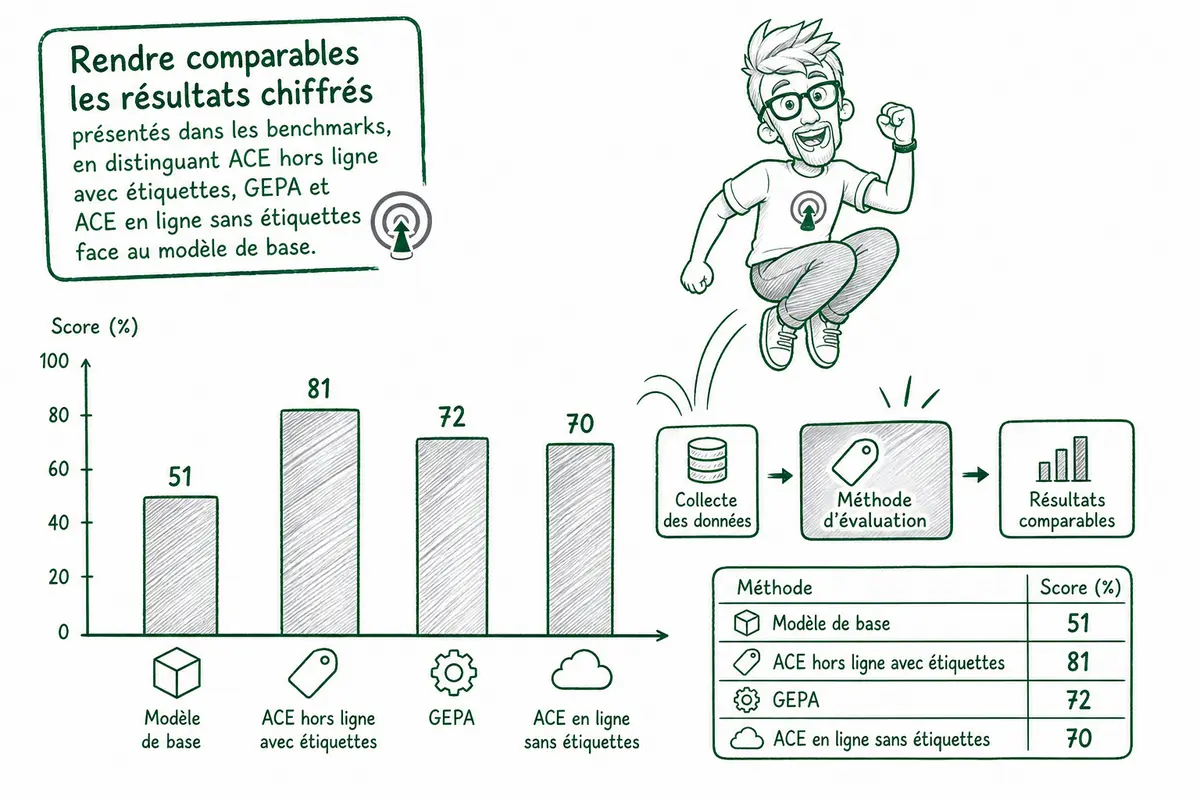
Les benchmarks montrent qu’ACE peut améliorer les performances d’un agent en faisant évoluer un playbook, c’est-à-dire une mémoire de stratégies réutilisables. Les résultats dépendent toutefois du domaine, du mode d’adaptation et du type de retour fourni à l’agent. Il faut donc éviter de comparer les scores sans tenir compte de ces différences.
AppWorld est un environnement d’évaluation où les agents accomplissent des tâches en utilisant des API et du code. Une règle pédagogique possible serait de parcourir les pages de résultats de factures en suivant le champ next_page jusqu’à ce qu’il soit vide. L’agent pourrait alors intégrer cette règle à son playbook pour une tâche similaire. Cet exemple illustre une règle possible ; il ne décrit pas une expérience rapportée ni un résultat mesuré.
Les évaluations distinguent deux configurations. En adaptation hors ligne, le playbook est construit avant les tests, puis utilisé pendant ceux-ci. En adaptation en ligne, l’agent prédit d’abord la réponse à une tâche, puis met à jour son playbook à partir du retour disponible. Cette différence compte : les deux configurations n’exposent pas l’agent aux mêmes informations au même moment.
Sur AppWorld, ACE dépasse les méthodes comparées dans les configurations rapportées. En finance, ACE hors ligne avec étiquettes atteint 81,9 % en moyenne sur FiNER et Formula, contre 72,5 % pour GEPA. Le résultat en ligne sans étiquettes est plus nuancé : ACE est sous le modèle de base sur FiNER, avec 67,3 % contre 70,7 %, mais progresse sur Formula.
Ces chiffres ne racontent donc pas une amélioration uniforme. Les types de retours diffèrent selon les évaluations, notamment entre les configurations avec étiquettes et sans étiquettes. Pour interpréter les comparaisons, je regarde à la fois le benchmark, le mode d’adaptation et le retour fourni, pas seulement le score final.
Quelles sont les limites d’un playbook évolutif ?
Un playbook évolutif ne s’améliore que si les retours permettent de vérifier ce qui a échoué et pourquoi. Si le retour est incomplet ou ambigu, l’agent peut retenir une mauvaise règle, puis la réutiliser dans des situations où elle ne s’applique pas. Le mécanisme d’apprentissage ne corrige pas automatiquement des données de feedback de mauvaise qualité.
Les ablations menées sur AppWorld, un environnement d’évaluation où des agents accomplissent des tâches via des applications simulées, montrent que plusieurs composants contribuent aux performances. L’adaptation sur plusieurs époques — des cycles successifs d’analyse et de mise à jour du playbook — apporte un gain. Le Reflector dédié, chargé d’extraire des leçons à partir des résultats, contribue lui aussi aux performances. Enfin, un échauffement hors ligne, réalisé avant l’évaluation en ligne, améliore les résultats obtenus ensuite.
Ces résultats ne signifient pas qu’ACE réduit le coût de chaque réponse à un utilisateur. Les gains de vitesse et de coût rapportés concernent certaines phases d’apprentissage évaluées, comme la création ou l’actualisation du contexte. Une fois le playbook utilisé, sa taille compte aussi : davantage de contenu peut augmenter le nombre de tokens traités à chaque requête, donc le coût et parfois la latence.
| Limite | Conséquence pratique |
| Retours peu vérifiables | L’agent peut intégrer une leçon erronée. |
| Playbook trop long | Le contexte consommé par les requêtes peut augmenter. |
| Résultats issus d’un benchmark | Les gains observés sur AppWorld ne garantissent pas les mêmes résultats ailleurs. |
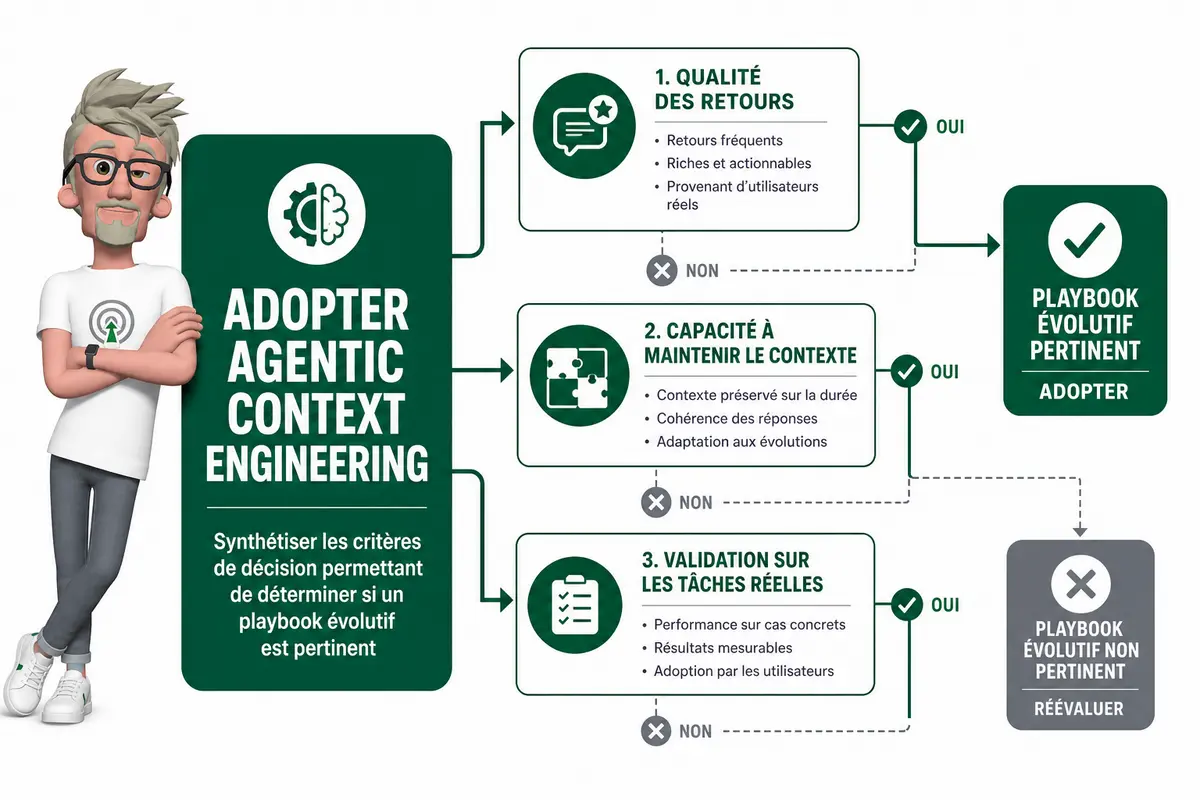
ACE est pertinent quand vous disposez de retours utiles, que vous pouvez les exploiter de façon répétée et que vous maintenez des entrées ciblées, plutôt qu’un historique accumulé sans tri. Je vérifierais aussi le coût complet : celui de l’apprentissage, mais aussi celui du contexte utilisé à l’exécution. Les résultats publiés sont encourageants, pas une garantie de gain dans tous les produits, toutes les tâches ou toutes les configurations.
Le playbook évolutif est-il adapté à vos agents ?
ACE fait progresser un agent en améliorant son playbook, pas les poids du modèle. Sa boucle Generator, Reflector et Curator transforme les tentatives et leurs retours en petites règles réutilisables. Les résultats rapportés sont encourageants, mais ils dépendent de la qualité des retours, du protocole d’évaluation et de la taille du contexte. Les benchmarks hors ligne et en ligne ne racontent pas la même chose, et les gains de coût mesurés pendant l’apprentissage ne décrivent pas le coût de chaque requête. Avant d’adopter ACE, vérifiez donc que vos retours permettent de valider les leçons apprises. Vous pourrez ainsi faire évoluer vos agents sans perdre les informations utiles de leur contexte.
FAQ
- Qu’est-ce qu’Agentic Context Engineering ?
ACE est une approche qui améliore les performances d’un agent en mettant à jour le contexte qu’il consulte, sans modifier les poids du modèle. - Comment ACE apprend-il de ses tâches ?
Le Generator tente la tâche, le Reflector analyse la tentative et les retours, puis le Curator transforme la leçon en mise à jour ciblée du playbook. - Que peut-on stocker dans un playbook ACE ?
Il peut contenir des règles d’utilisation d’outils, du code réutilisable et des conseils de dépannage. Ses entrées peuvent être ajoutées, révisées, fusionnées ou supprimées. - ACE est-il toujours plus performant qu’un modèle de base ?
Non. Les résultats varient selon la configuration et les retours disponibles. En ligne sans étiquettes, ACE obtient 67,3 % sur FiNER, contre 70,7 % pour le modèle de base, mais progresse sur Formula. - Pourquoi éviter de réécrire entièrement le contexte ?
Une réécriture peut supprimer des informations utiles. Dans un cas AppWorld rapporté, le contexte est passé de 18 282 à 122 tokens et la précision a baissé de 66,7 % à 57,1 %. ACE privilégie des mises à jour ciblées.
A propos de l’auteur
Je suis Franck Scandolera, expert en data, IA et automatisation No/Low Code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne les entreprises sur l’intégration de l’IA et l’automatisation, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.