
Pour fiabiliser un agent IA longue durée, je ne compte pas seulement sur ses instructions : je définis un harness déterministe, je rends son contexte visible et je contrôle ses actions. Voici comment structurer sa mémoire, gérer les sessions et poser des limites claires aux accès.
Qu’est-ce qui distingue un agent d’un modèle ?
Un modèle génère du texte. Un agent exécute des actions dans un fonctionnement défini. La différence ne tient pas à une consigne plus détaillée, mais à la façon dont le modèle est intégré à un système qui peut agir.
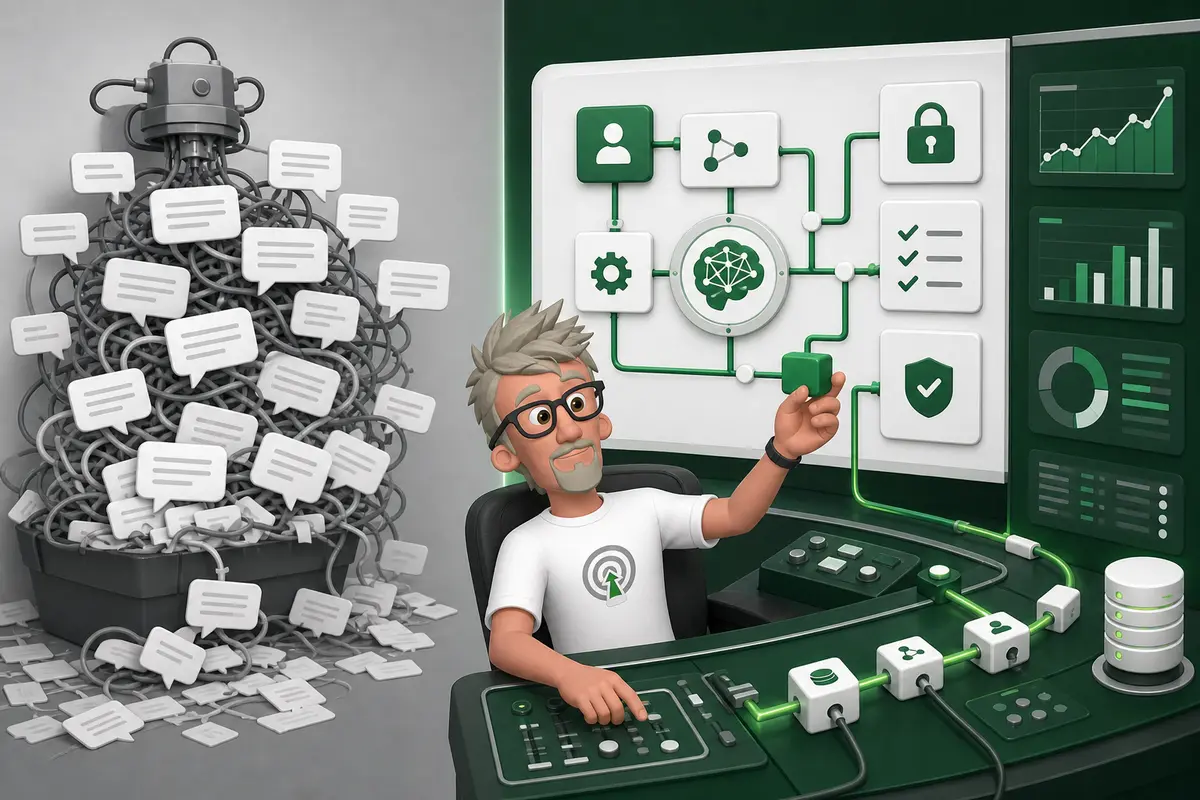
Le modèle produit une réponse à partir de son entrée. À lui seul, il ne décide pas comment une action doit être exécutée, vérifiée ou reprise après un échec. L’agent, lui, associe le modèle à des outils et à des règles d’exécution : par exemple, il peut demander au modèle une décision, transmettre cette décision à un outil, puis vérifier le résultat. Ce sont les composants du système qui réalisent ces opérations, pas une capacité autonome qu’on pourrait attribuer au modèle.
Comment classer des textes en few-shot avec Scikit-LLM ?
Des consignes seules ne suffisent donc pas à fiabiliser un agent, surtout sur une tâche longue. Elles orientent les réponses, mais ne garantissent ni le respect des étapes, ni la validité des données, ni la bonne gestion d’une interruption. J’ai déjà vu des agents suivre une consigne au début, puis diverger après plusieurs échanges parce qu’aucun mécanisme ne contrôlait leurs sorties.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Le harness, c’est la structure déterministe qui encadre l’exécution de l’agent. Il définit quand le modèle est appelé, quelles actions sont autorisées, comment les résultats sont validés et quoi faire en cas d’erreur. Il gère aussi le contexte transmis au modèle : les informations utiles à la tâche, leur ordre et leur quantité. Le modèle génère des sorties ; le harness applique les règles et orchestre le fonctionnement.
Cette séparation rend le système plus prévisible, mais elle ne suffit pas si on ne peut pas comprendre ce que le modèle a reçu. Pour diagnostiquer une mauvaise décision, il faut pouvoir inspecter le contexte utilisé au moment de l’appel, pas seulement relire les consignes générales. C’est ce contexte, et la manière de le rendre observable, qui permet de vérifier pourquoi l’agent a produit une réponse ou déclenché une action.
Comment rendre le contexte visible ?
Comment utiliser Gemini 4 Argon dans n8n ?
Le contexte utilisé par l’agent doit être visible et géré explicitement. Sans cette visibilité, il est difficile de comprendre pourquoi l’agent agit d’une certaine façon, ou de repérer une information manquante ou devenue obsolète.
Concrètement, on doit pouvoir comprendre sur quelles informations l’agent s’appuie pendant son exécution. Ce contexte peut influencer ses réponses, ses décisions et la suite de son travail. Le rendre visible permet de vérifier si les informations disponibles sont toujours pertinentes, et de distinguer ce que l’agent sait de ce qu’on suppose qu’il sait.
Le contexte peut être compressé quand il devient trop volumineux ou qu’une partie des informations n’a plus besoin d’être conservée dans son intégralité. Mais la compression n’est pas une solution automatique. Elle peut faire perdre des éléments utiles, et il faut donc garder en tête ce qui doit rester compréhensible pour la suite du travail. Je préfère traiter la compression comme un choix de gestion du contexte, pas comme une garantie de fiabilité.
Comment passer un prototype IA en production SaaS ?
Cette visibilité aide aussi à décider ce qui doit être conservé d’une exécution à l’autre. C’est le lien avec les sessions persistantes : une session persistante permet de garder certains éléments pour continuer plus tard, mais tout ne doit pas forcément être conservé. Selon le besoin, une information reste utile, ou le contexte doit être réinitialisé pour éviter de s’appuyer sur des éléments qui ne correspondent plus à la situation.
Quand on sait ce que l’agent utilise, on peut décider plus clairement ce qui doit durer et ce qui doit repartir de zéro. Sans cette distinction, la persistance risque de prolonger un contexte devenu inadapté.
Comment gérer mémoire et sessions ?
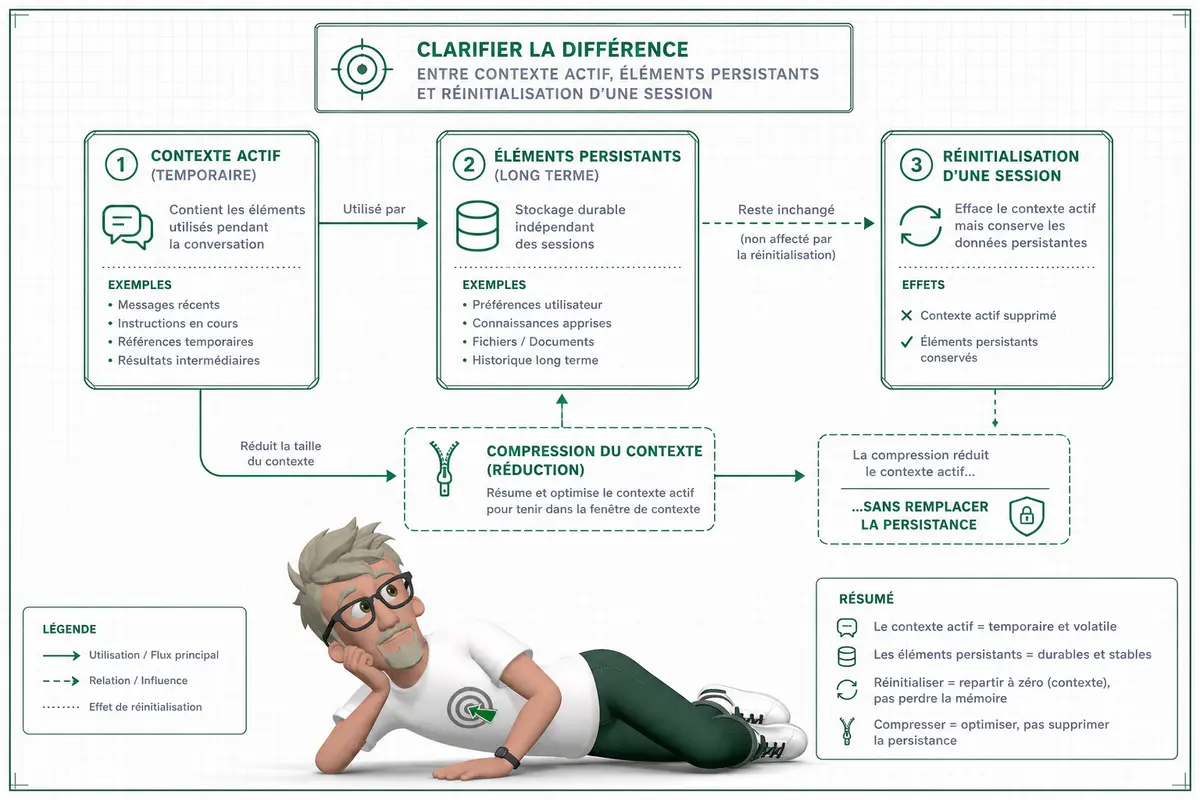
Une session peut être réinitialisée à partir d’éléments persistants, stockés hors de son contexte actif. Je distingue les échanges et données actuellement chargés pour l’agent de ce qui est conservé afin de reprendre le travail après une interruption. Réinitialiser une session ne signifie donc pas repartir de zéro : on reconstruit son contexte à partir des éléments persistants fournis.
Que faut-il savoir sur IQuest-Q1, le modèle MoE ?
Le contexte actif contient ce que l’agent peut utiliser pendant l’exécution en cours. Il peut inclure les derniers échanges, les instructions et les résultats utiles à la tâche. Les éléments persistants, eux, sont disponibles en dehors de cette session et peuvent être réinjectés lorsqu’on en démarre une nouvelle. Leur contenu et leur mode de conservation dépendent du système ; il n’y a pas de format universel.
La compression devient utile quand le contexte actif approche la limite que le modèle peut traiter. Elle consiste à réduire des informations détaillées pour en conserver une version plus courte, au prix d’une perte possible de nuances. Elle ne remplace pas la persistance : les éléments nécessaires à une reprise doivent rester accessibles séparément.
Voici une illustration conceptuelle autonome. La session est une structure de données, les éléments persistants sont fournis explicitement, et la fonction de réinitialisation reconstruit le contexte à partir d’eux.
def reset_session(persistent_items):
    # Crée une nouvelle session à partir des éléments fournis.
    return {
        "active_context": list(persistent_items)
    }


# Ces éléments représentent des informations conservées hors session.
persistent_items = [
    "Objectif : préparer le rapport mensuel.",
    "Dernière étape terminée : collecte des ventes."
]

# La nouvelle session reprend à partir de ces éléments.
session = reset_session(persistent_items)
print(session["active_context"])
La persistance pose aussi une question de permissions. Un élément conservé ne doit pas être accessible automatiquement à tous les agents ou utilisateurs : il faut contrôler qui peut le lire, le modifier ou le réinjecter dans une session, et vérifier que ces droits sont toujours valides au moment de la reprise.
Comment encadrer les actions et les accès ?
Le développeur doit définir explicitement les permissions des services dans lesquels l’agent peut stocker des informations. Le harness — l’enveloppe qui contrôle et vérifie l’exécution de l’agent — doit ensuite valider que ces règles sont bien appliquées, avant chaque appel de service.
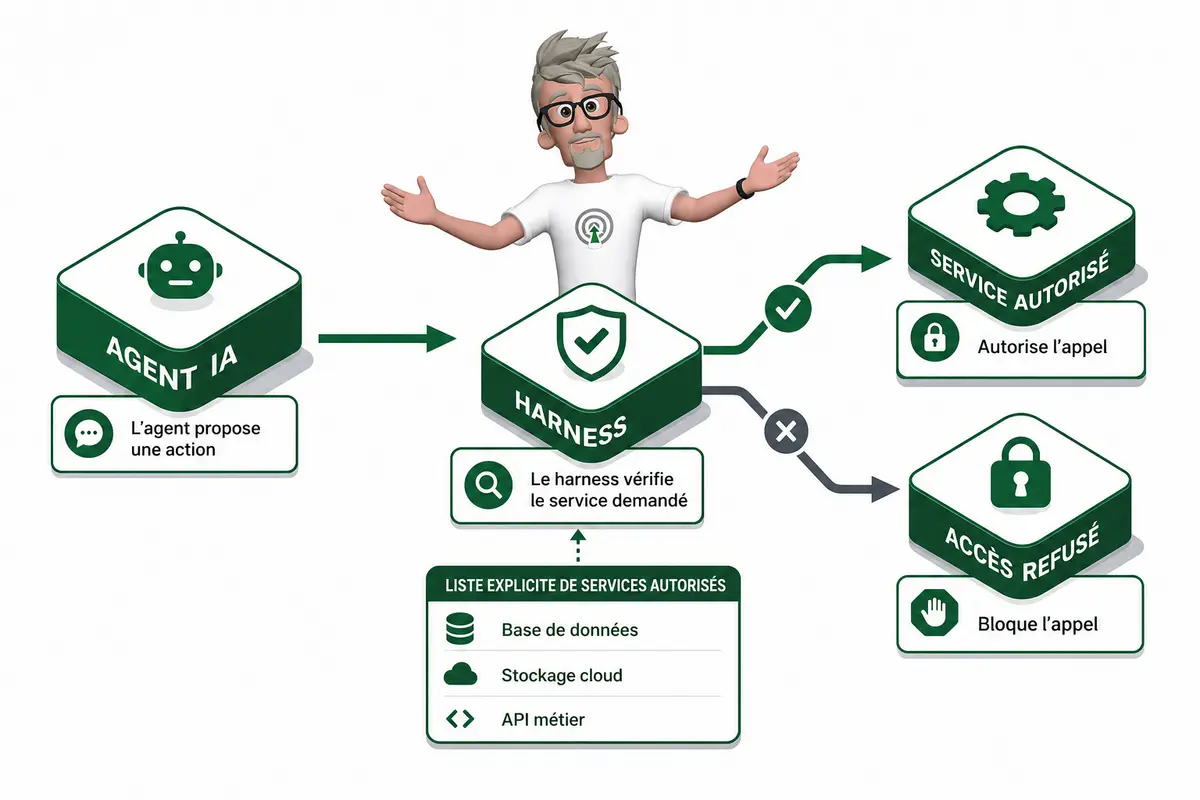
Sans limites définies, l’agent peut tenter d’écrire dans un service qui n’était pas prévu, ou y envoyer des données sensibles. Avec des règles déterministes, chaque opération passe par une vérification explicite : le service est autorisé, sinon l’action est refusée. L’agent peut proposer une action, mais il ne décide pas seul de ses permissions. Je recommande aussi de n’accorder que les accès nécessaires à sa tâche, plutôt que de lui ouvrir tous les services disponibles.
Voici une illustration autonome, sans dépendance. Elle vérifie qu’un service figure dans la liste autorisée avant que le stockage soit accepté. Dans une application réelle, cette vérification doit être placée dans le harness, au plus près de l’appel au service.
def verifier_service_stockage(service_demande, services_autorises):
    # Refuse l'opération si le service n'est pas explicitement autorisé.
    if service_demande not in services_autorises:
        raise PermissionError(
            f"Stockage refusé pour le service : {service_demande}"
        )

    return True


services_autorises = ["base_clients", "espace_projets"]

# Le stockage peut continuer uniquement si la vérification réussit.
verifier_service_stockage("espace_projets", services_autorises)
Ce contrôle ne remplace pas les permissions configurées directement dans les services. Il ajoute une barrière vérifiable dans le parcours de l’agent. Le harness peut tester les cas autorisés et refusés, puis bloquer l’appel réel si la vérification échoue.
La fiabilité dépend aussi du contexte transmis à l’agent : il doit savoir quelles données il peut stocker, dans quel service et pour quelle tâche. Validation, permissions minimales et contexte explicite se complètent. C’est ce cadre qui permet à un agent longue durée d’agir sans transformer chaque nouvelle étape en accès implicite.
Et si vous commenciez par le harness ?
Un agent fiable ne repose pas uniquement sur la qualité de ses instructions. Le modèle génère du texte, mais c’est le harness qui encadre l’exécution, valide les opérations et organise le contexte. Pour les tâches longues, je rends ce contexte visible, je le compresse quand c’est utile et je distingue la session active des informations persistantes. Je définis aussi les permissions des services utilisés pour stocker ces informations. Ces choix rendent le fonctionnement de l’agent plus explicite et plus maîtrisable. Commencez par les règles d’exécution et les accès, puis faites évoluer la gestion de la mémoire selon vos besoins : vous gagnerez en contrôle et en fiabilité.
FAQ
- Pourquoi un prompt ne suffit-il pas à fiabiliser un agent ?
Un prompt donne des consignes au modèle, mais ne définit pas à lui seul le fonctionnement de l’agent. Un harness peut encadrer son exécution avec des validations et une gestion explicite du contexte. - Quelle est la différence entre un modèle et un agent ?
Le modèle génère du texte. L’agent s’inscrit dans un système qui exécute des actions selon un fonctionnement défini. - Pourquoi rendre le contexte de l’agent visible ?
Pour savoir quelles informations sont utilisées par l’agent et mieux gérer ce qui reste dans la session ou doit être conservé pour la suite. - Faut-il toujours compresser le contexte ?
Non. La compression est utile dans certains cas, mais elle doit répondre à un besoin. La gestion du contexte doit rester explicite. - Comment limiter les accès d’un agent ?
Le développeur définit les permissions des services où l’agent peut stocker des informations, puis le fonctionnement de l’agent doit respecter ces limites.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA et automatisation No/Low Code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne les entreprises sur leurs projets de tracking server-side, d’Analytics Engineering et d’intégration de l’IA, notamment pour Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.