
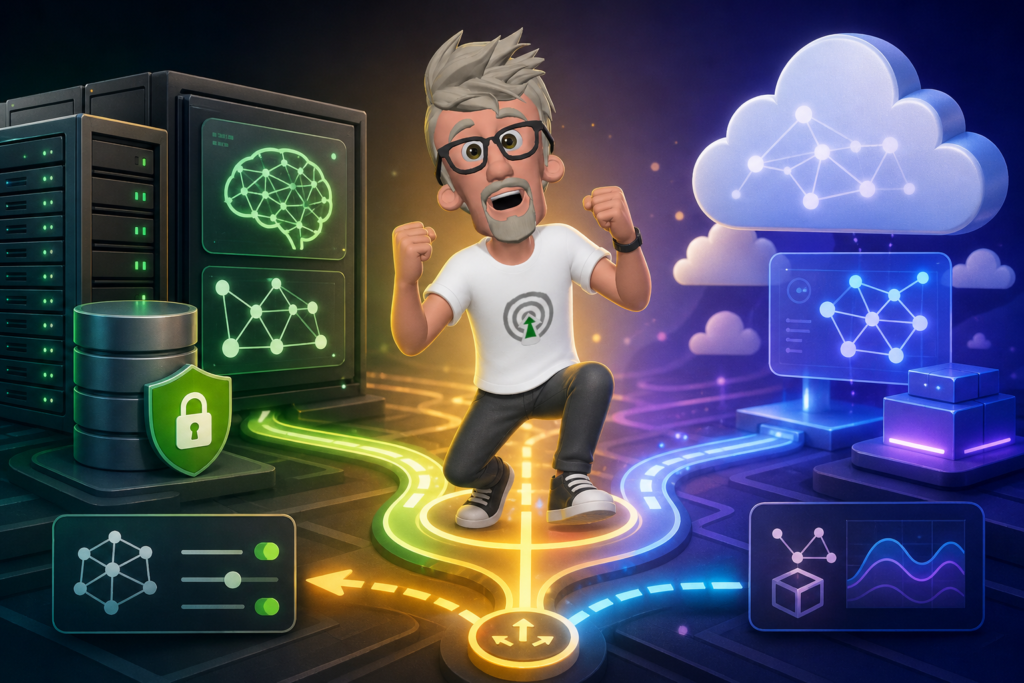


Je route chaque requête vers un LLM local ou une API cloud selon les données à traiter, les capacités attendues et les ressources disponibles. Une architecture hybride évite d’imposer un seul modèle à tous les usages. Reste à définir les critères, le matériel et la pile adaptés.
Pourquoi combiner LLM local et cloud ?
Une architecture hybride répartit les requêtes entre des modèles locaux et des services cloud selon leurs besoins. Le routage ne consiste pas à tout traiter localement : il permet de garder certaines données dans l’environnement de l’organisation, tout en mobilisant les capacités cloud quand elles apportent une valeur réelle.
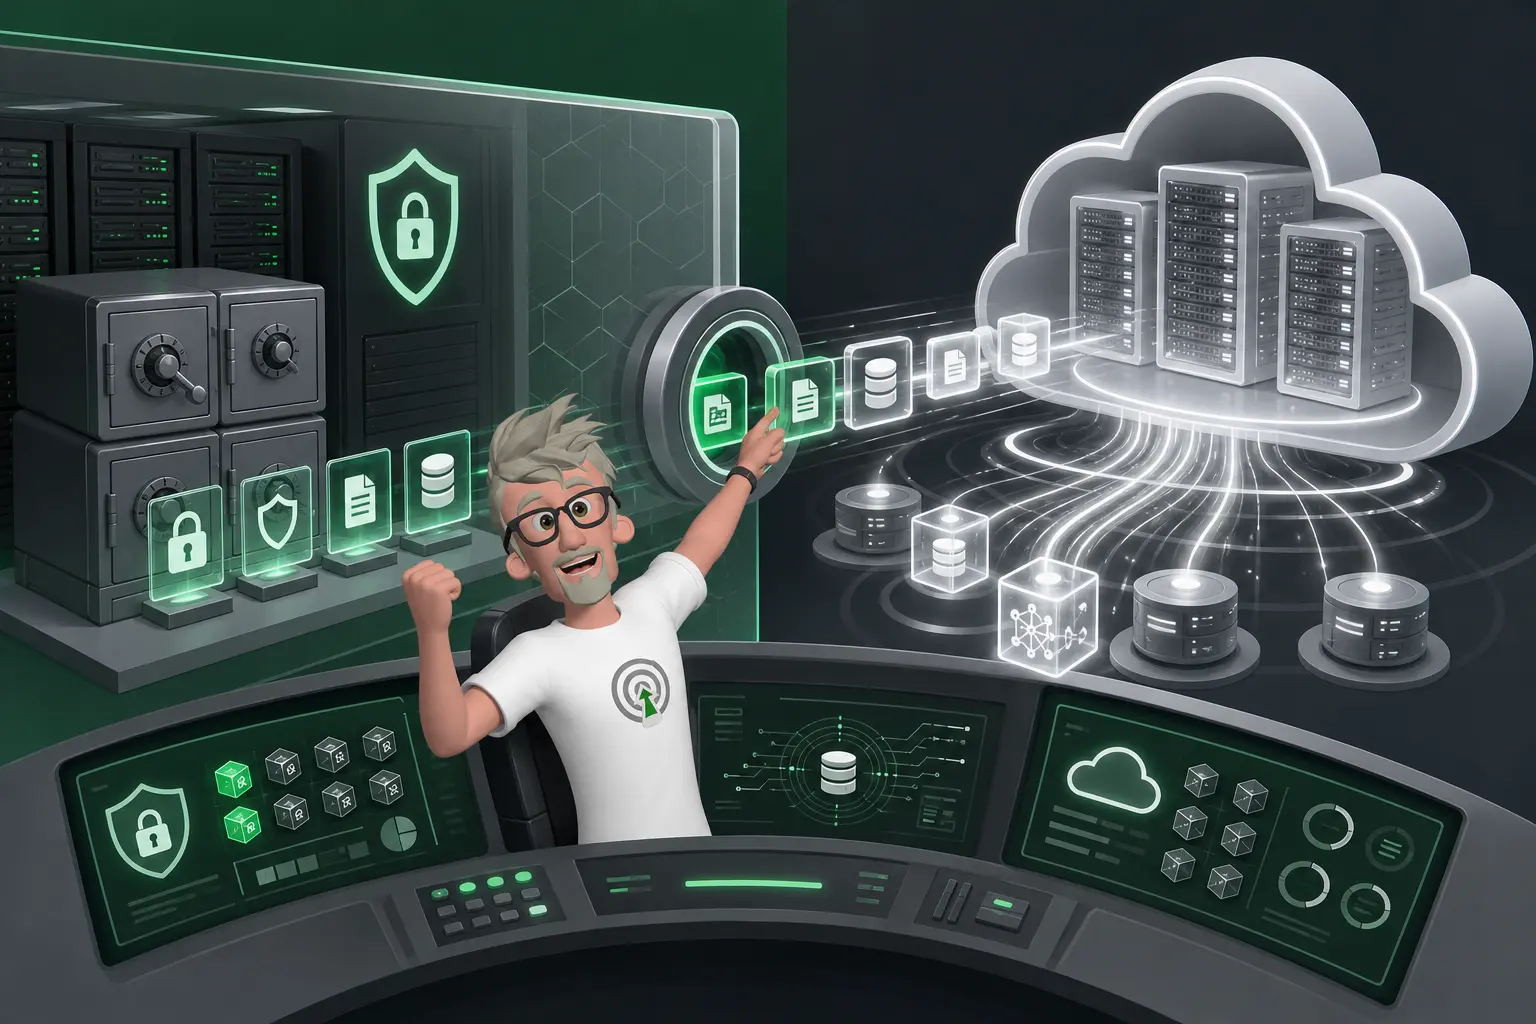
Un modèle local s’exécute sur une infrastructure que l’organisation contrôle. Les données peuvent ainsi être traitées au sein de son réseau, selon la configuration retenue. En contrepartie, il faut dimensionner et exploiter les ressources : processeurs, mémoire, accélérateurs, supervision et mises à jour. Les services cloud donnent accès à des modèles parfois plus capables, sans que l’organisation ait à gérer leur infrastructure. Mais l’envoi d’une requête à une API implique de vérifier où et comment les données sont traitées, au regard des exigences internes et de conformité applicables. Je ne considère jamais qu’un choix d’hébergement constitue, à lui seul, une garantie de sécurité ou de conformité.
Comment réduire le coût du fine-tuning des LLM ?
En pratique, le routeur peut s’appuyer sur quelques critères explicites :
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
| Confidentialité | Les données sensibles peuvent orienter la requête vers un traitement local, si cette option répond aux exigences de l’organisation. |
| Conformité | Les contraintes applicables au cas d’usage déterminent quels traitements sont acceptables. |
| Capacités requises | Un raisonnement complexe, une grande fenêtre de contexte ou une qualité de génération supérieure peuvent justifier un appel cloud. |
| Ressources disponibles | La charge, la latence et la capacité de l’infrastructure locale influencent le choix au moment de l’exécution. |
J’ai déjà vu des équipes vouloir héberger chaque requête localement « par principe », puis se heurter au coût d’exploitation ou aux limites du modèle. Une politique de routage utile rend ces arbitrages observables et ajustables, plutôt que de les figer dans une règle unique. Le choix du modèle et celui du matériel vont donc ensemble : les capacités recherchées définissent les ressources nécessaires, et les ressources disponibles bornent les modèles locaux qu’on peut exploiter.
Quel modèle open-weight choisir ?
Le bon choix consiste à tester plusieurs modèles sur vos tâches réelles, puis à déployer le plus petit modèle qui répond de façon fiable. La taille seule ne prédit pas la qualité : mesurez la précision, la latence, le taux d’erreur et la consommation mémoire sur vos propres prompts.
Combien coûte DeepSeek Harness à l’usage ?
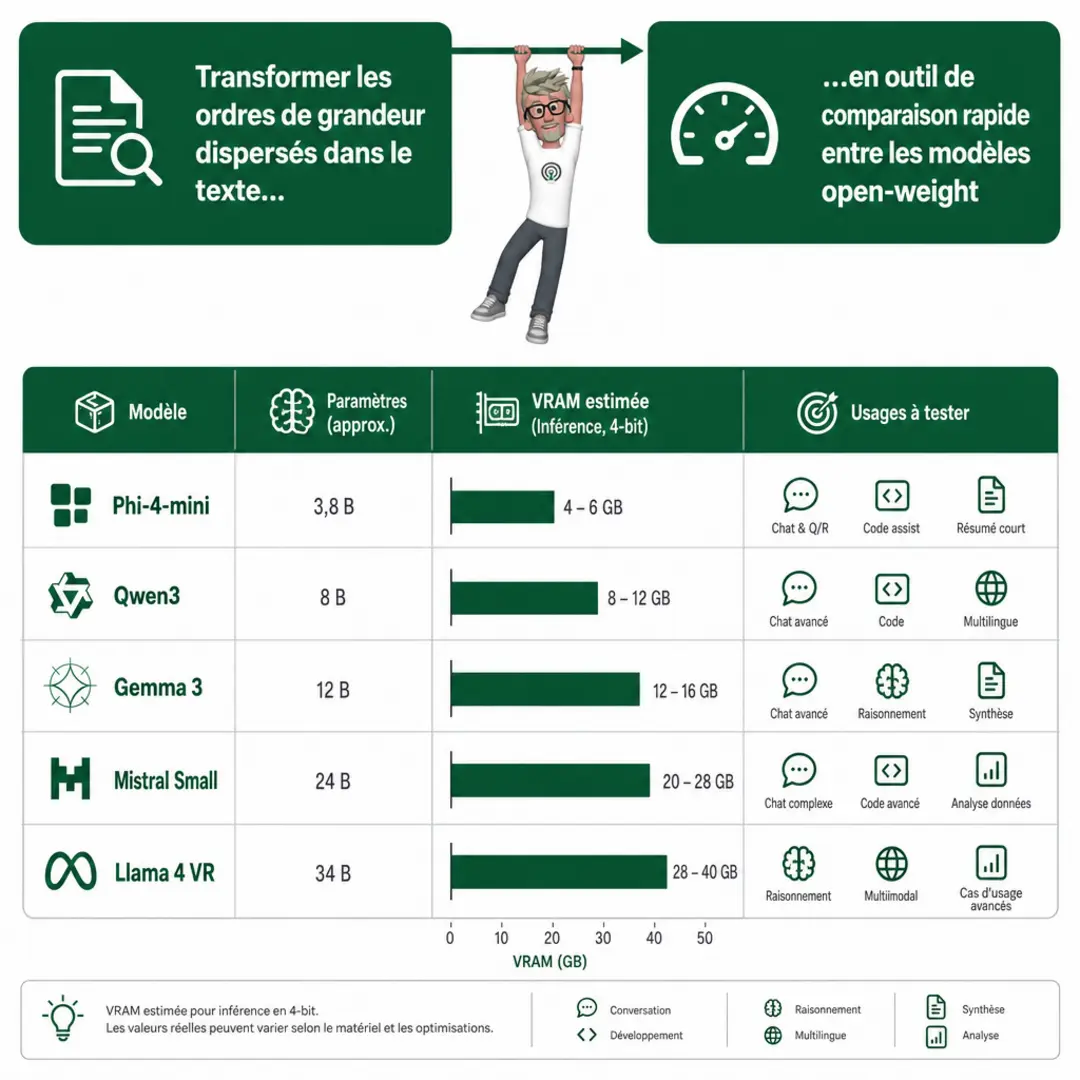
Les besoins en mémoire ci-dessous sont des ordres de grandeur, pas des garanties. Ils varient selon la quantification — une compression des poids du modèle —, la longueur du contexte, le moteur d’inférence et la mémoire réservée à l’application. La mémoire nécessaire augmente aussi quand plusieurs requêtes tournent en parallèle.
- Phi-4-mini compte 3,8 milliards de paramètres. Avec environ 8 Go de VRAM, c’est un candidat compact pour un assistant local et des tâches ciblées.
- Qwen3 8B demande autour de 8 Go en configuration 8 bits. Je le testerais pour un assistant local généraliste, du code et du raisonnement courant.
- Gemma 3 12B et DeepSeek R1-Distill-Qwen-14B demandent environ 12 à 16 Go quantifiés. Le premier est à évaluer pour les tâches multimodales ; le second pour le raisonnement, notamment quand les réponses doivent être structurées.
- Mistral Small 3.1 nécessite environ 12 à 16 Go en quantification 4 bits, ou 44 à 55 Go sans quantification. Il peut convenir à un assistant polyvalent, à la programmation et à l’analyse multimodale.
- Llama 4 Scout totalise 109 milliards de paramètres, dont 17 milliards actifs par requête. Prévoyez environ 55 à 80 Go selon la configuration. Il vise plutôt les environnements équipés, notamment pour l’analyse multimodale.
En pratique, je commence avec deux ou trois candidats et un jeu de tests représentatif. Un petit modèle local suffit souvent pour classer, extraire ou reformuler. Je réserve les modèles plus lourds aux cas où le gain de qualité est mesurable.
| Modèle | VRAM estimée | Usages à tester |
| Phi-4-mini | Environ 8 Go | Assistant local |
| Qwen3 8B | Environ 8 Go en 8 bits | Assistant, code |
| Gemma 3 12B | Environ 12 à 16 Go quantifiés | Analyse multimodale |
| DeepSeek R1-Distill-Qwen-14B | Environ 12 à 16 Go quantifiés | Raisonnement |
| Mistral Small 3.1 | Environ 12 à 16 Go en 4 bits ; 44 à 55 Go sans quantification | Code, assistant, multimodal |
| Llama 4 Scout | Environ 55 à 80 Go | Analyse multimodale |
De quel matériel un LLM local a-t-il besoin ?
Un modèle local doit tenir dans les ressources disponibles pour rester adapté à un usage quotidien. La capacité à charger un modèle une fois ne suffit pas : il faut aussi préserver une latence acceptable quand les requêtes s’enchaînent.
Quels modèles d’IA locaux choisir et installer ?
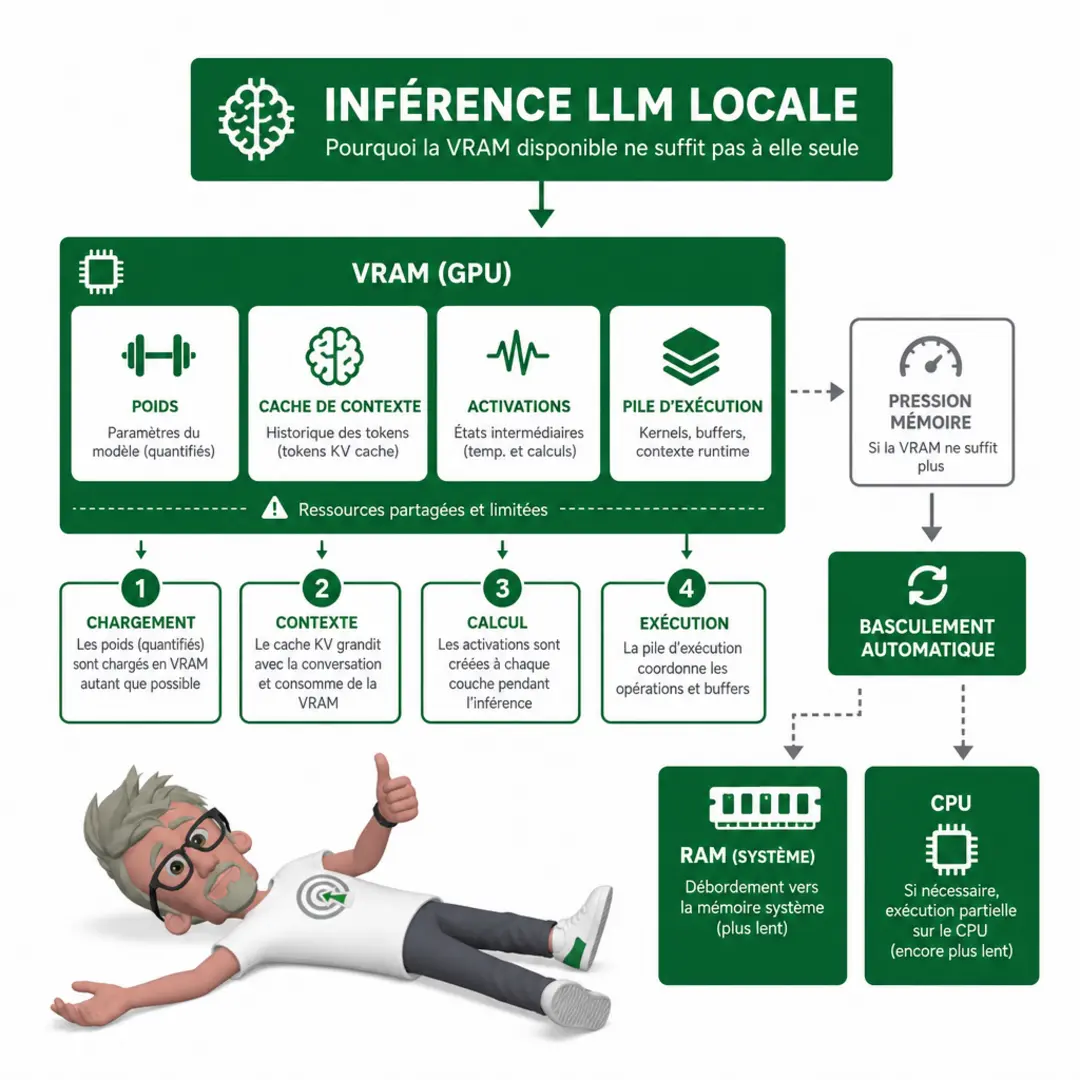
La VRAM, mémoire dédiée de la carte graphique, détermine principalement quelle part du modèle peut être exécutée sur le GPU. Pendant l’inférence, c’est-à-dire la génération de réponses, les poids du modèle doivent être chargés en mémoire. Il faut aussi réserver de la place aux activations et au cache des échanges précédents, dont la taille augmente avec le contexte. La mémoire réellement nécessaire dépasse donc l’empreinte des seuls poids.
La quantification réduit le nombre de bits utilisés pour représenter ces poids. Elle diminue l’empreinte mémoire et peut permettre d’exécuter un modèle plus volumineux sur le même matériel. Une quantification modérée offre souvent un compromis acceptable entre mémoire, vitesse et qualité. Une compression plus agressive réduit davantage les besoins, mais peut dégrader les résultats sur des tâches complexes, notamment le raisonnement numérique. Le compromis doit être testé sur vos propres cas d’usage, pas seulement évalué à partir d’un benchmark général.
Si la VRAM manque, le moteur d’inférence peut transférer une partie du calcul vers la mémoire système ou le processeur. Ça évite parfois l’échec du chargement, mais les échanges entre GPU, RAM et CPU ralentissent les réponses. Sur un usage interactif, la latence devient vite le problème visible.
Comment réduire les tokens d’un prompt sans perdre en qualité ?
Le moteur d’inférence gère le chargement des poids, la quantification et la répartition des calculs. La pile de déploiement complète — serveur de modèles, conteneurs, orchestration et supervision — ajoute ses propres besoins en mémoire. Je vérifie donc le comportement du modèle dans son environnement réel, avec le contexte et le volume de requêtes prévus. C’est souvent là qu’un choix qui semblait fonctionner en test révèle ses limites.
Comment assembler la pile d’un LLM auto-hébergé ?
Une pile standard de LLM auto-hébergé comporte cinq couches complémentaires. Le routage entre un modèle local et une API cloud s’inscrit dans cette architecture : il s’appuie sur le moteur d’inférence et la couche applicative.
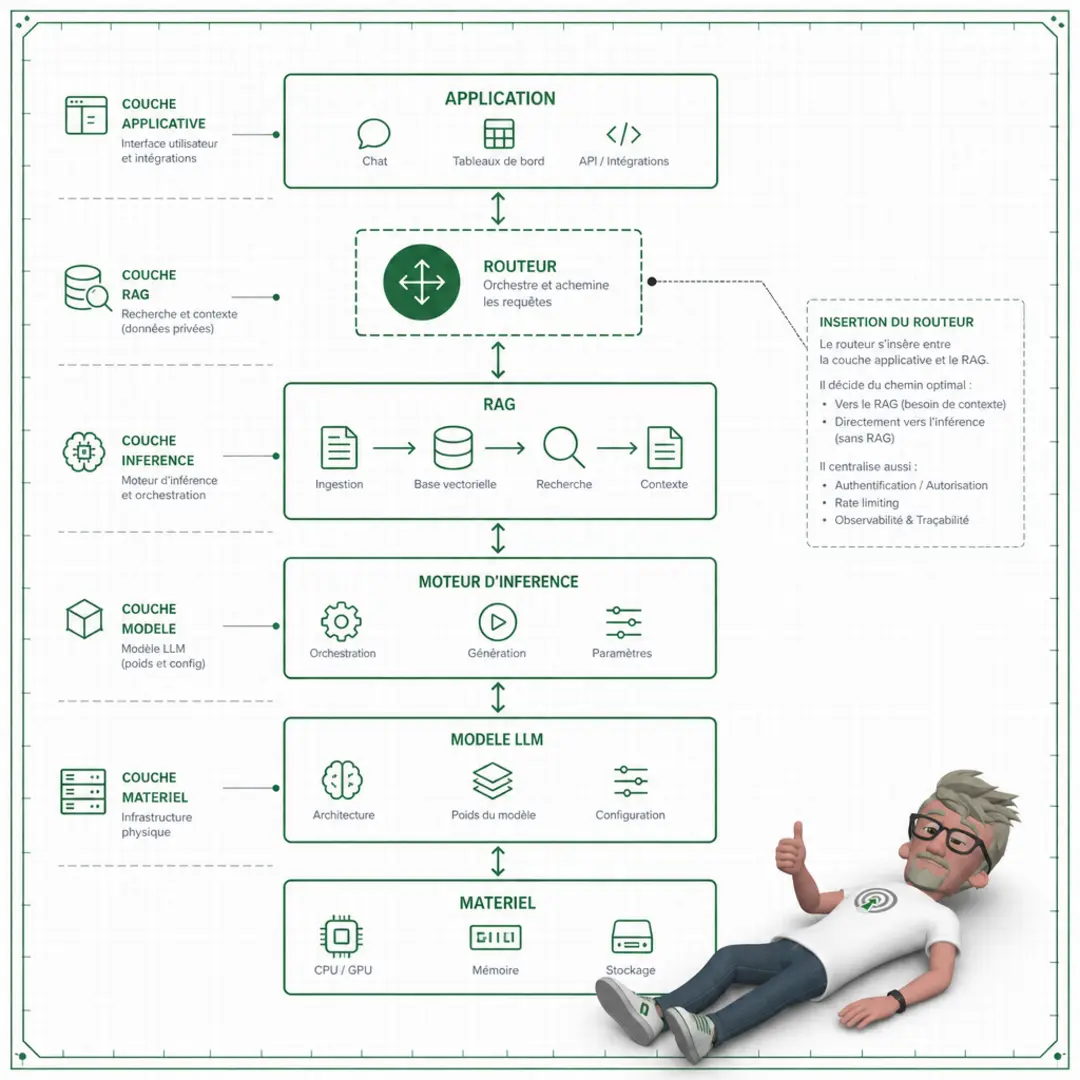
- Matériel. Il fournit les ressources de calcul. Le GPU, processeur spécialisé dans les calculs parallèles, influence notamment les modèles que l’on peut exécuter localement.
- Modèle choisi. C’est le modèle de langage utilisé pour générer les réponses. Son choix dépend des besoins de l’application et des ressources disponibles.
- Moteur d’inférence. Des outils comme Ollama ou vLLM chargent le modèle et peuvent exposer une API pour que d’autres composants lui envoient des requêtes.
- Couche de récupération d’informations. Un RAG (génération augmentée par récupération) apporte au modèle des données privées ou spécialisées au moment de la requête.
- Couche applicative. Une interface de discussion, une API ou un workflow reçoit les demandes et les transmet aux composants concernés.
Le routeur peut appliquer une règle explicite : garder en local les données sensibles ; utiliser le cloud pour les demandes non sensibles qui exigent une capacité absente du client local. Si aucune option n’est compatible, il vaut mieux refuser la requête que l’envoyer au mauvais endroit.
Le code ci-dessous illustre cette logique avec des clients abstraits injectés. Il sert à montrer le contrat et la règle de décision, pas à fournir une intégration prête à l’emploi avec Ollama, vLLM ou un fournisseur cloud.
from dataclasses import dataclass
from typing import Protocol

class LLMClient(Protocol):
    capabilities: set[str]

    def generate(self, prompt: str) -> str:
        ...

@dataclass
class Request:
    prompt: str
    sensitive: bool
    required_capabilities: set[str]

class Router:
    def __init__(self, local: LLMClient, cloud: LLMClient):
        self.local = local
        self.cloud = cloud

    def generate(self, request: Request) -> str:
        # Les données sensibles restent sur le client local.
        if request.sensitive:
            if request.required_capabilities > self.local.capabilities:
                raise RuntimeError("Capacité locale indisponible pour une donnée sensible")
            return self.local.generate(request.prompt)

        # Le cloud n'est utilisé que si le local ne couvre pas le besoin.
        if request.required_capabilities <= self.local.capabilities:
            return self.local.generate(request.prompt)
        if request.required_capabilities <= self.cloud.capabilities:
            return self.cloud.generate(request.prompt)

        raise RuntimeError("Aucun client ne couvre les capacités requises")
Dans un déploiement réel, ces capacités doivent être définies et vérifiées selon vos modèles et vos clients. La pile décrit où le routage s’insère ; les critères de routage — sensibilité, capacités requises et contraintes d’exécution — déterminent quand chaque chemin est choisi.
Comment décider où envoyer chaque requête ?
Il faut router chaque requête selon ses exigences, plutôt que de tout envoyer au même endroit. Le traitement local est à privilégier quand les données doivent rester dans votre infrastructure et que le modèle local répond au besoin. Le cloud devient une option si les capacités du modèle ou l’échelle requise dépassent les ressources locales, à condition que la politique de données l’autorise.
La décision repose sur quelques arbitrages :
- Confidentialité et conformité : vérifiez les règles de résidence, de conservation et de traitement des données. Si le cloud est interdit, une insuffisance locale doit provoquer un refus ou une escalade, pas un transfert automatique.
- Capacités du modèle : comparez la qualité nécessaire à la tâche, pas seulement la taille ou la réputation du modèle.
- VRAM et ressources opérationnelles : la VRAM, ou mémoire vidéo du GPU, limite les modèles et les volumes traités en parallèle. L’exploitation locale demande aussi du suivi, de la maintenance et une gestion de capacité.
La décision se place avant l’appel au modèle. Les deux clients exposent la même interface ; le routeur choisit l’un d’eux sans modifier le reste du code.
def select_client(task, policy, local, cloud):
    # can_serve vérifie la compatibilité et la capacité disponible.
    if local.can_serve(task):
        return local

    # Ne jamais contourner une exigence de traitement local.
    if policy.must_stay_local:
        raise RuntimeError("Aucun traitement local adapté ou disponible")

    if policy.cloud_allowed and cloud.can_serve(task):
        return cloud

    raise RuntimeError("Aucun client autorisé et disponible")

client = select_client(task, policy, local_client, cloud_client)
result = client.generate(prompt)
Dans cette interface, can_serve tient compte de l’adéquation du modèle et de la capacité disponible. Pour le client local, cela inclut notamment la VRAM et la charge ; pour le cloud, les capacités exposées par le service et sa disponibilité. Je garde le routage explicite : les replis silencieux vers le cloud sont une mauvaise surprise en production.
| Critère | Option à privilégier |
| Données à maintenir dans l’infrastructure | Local, si le modèle convient et dispose de ressources suffisantes |
| Capacités locales insuffisantes | Cloud, uniquement si la politique l’autorise |
| Charge supérieure aux ressources locales | Cloud autorisé, sinon mise en attente ou escalade |
| Contraintes d’exploitation locale | Comparer la capacité réelle de l’équipe à maintenir le service |
Le bon arbitrage se valide ensuite sur les tâches réelles de votre organisation : qualité obtenue, latence, taux d’échec et contraintes de traitement observées.
Quel équilibre retenir pour votre architecture ?
Je ne choisirais pas entre auto-hébergement et cloud comme s’il fallait n’en garder qu’un. Le choix dépend des données, des capacités attendues et des ressources disponibles. Testez plusieurs modèles sur vos tâches, puis retenez le plus petit modèle fiable. Vérifiez que la VRAM et le moteur d’inférence tiennent la charge ; la quantification peut réduire l’empreinte, avec un compromis possible sur les tâches complexes. Une pile composée du matériel, du modèle, du moteur, du RAG et de l’application donne un cadre clair. En routant les requêtes selon leurs besoins, vous gardez le contrôle tout en mobilisant le cloud quand il apporte une capacité utile.
FAQ
-
Qu’est-ce qu’un LLM auto-hébergé ?
C’est un modèle exécuté sur l’infrastructure de l’organisation, plutôt que via une API cloud. Il demande du matériel, un moteur d’inférence et des ressources de maintenance. -
Pourquoi utiliser une architecture hybride ?
Elle permet de traiter localement les requêtes qui doivent rester dans l’infrastructure et de recourir au cloud lorsque ses capacités ou son échelle sont nécessaires. -
Quel modèle open-weight choisir pour débuter ?
Testez plusieurs modèles sur vos tâches réelles, puis retenez le plus petit qui répond de façon fiable. Le choix dépend aussi de la VRAM disponible et du niveau de quantification. -
À quoi sert la quantification d’un LLM ?
Elle représente les poids du modèle avec moins de bits pour réduire leur empreinte mémoire. Une compression plus agressive peut toutefois dégrader certaines tâches complexes, notamment le raisonnement numérique. -
Que faire si le modèle dépasse la VRAM disponible ?
Le moteur peut transférer une partie du travail vers la mémoire système ou le processeur, au risque de ralentir les réponses. Vous pouvez évaluer un modèle plus petit ou une quantification adaptée.
A propos de l’auteur
Franck Scandolera accompagne les équipes sur l’architecture Data et l’automatisation IA. Il conçoit des workflows et des applications métier intelligentes, avec une attention particulière au choix des modèles, à la circulation des données et à l’intégration dans les systèmes existants.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.