


DeepSeek Harness ressemble surtout à une base technique pour construire des agents IA, pas à un outil fini. Ce qui m’intéresse ici, c’est son architecture plugin-first, son sandbox isolé, ses logs append-only et ce que ça change pour des équipes qui veulent industrialiser des agents.
Pourquoi DeepSeek Harness attire autant ?
Ce qui attire avec DeepSeek Harness, c’est qu’il ne se vend pas juste comme un agent de codage de plus. Je le vois plutôt comme un runtime open source pour construire des agents IA modulaires. Un runtime, dit simplement, c’est la couche qui exécute et coordonne tout ce qui fait tourner l’agent : le modèle, les outils, les logs, l’interface, les règles d’exécution.
Le point intéressant, c’est son approche plugin-first. Presque tout peut devenir un plugin. L’adaptateur de modèle, le registre d’outils, les logs, le sandbox, l’interface utilisateur, et même la boucle de l’agent. Et ça, pour une équipe data, IA ou automatisation, ça change pas mal de choses.
Quelle mémoire IA choisir pour vos agents ?
Dans beaucoup de projets agents que je vois chez des clients, le problème n’est pas de faire une démo. Ça, on y arrive vite. Le vrai sujet arrive après, quand il faut changer de modèle, sécuriser l’exécution, tracer les actions, remplacer un outil interne, ou brancher l’agent sur un autre workflow. Si tout est collé ensemble, chaque changement devient une mini refonte.
Avec une logique plugin, l’idée est plus saine :
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
- Vous pouvez remplacer le modèle sans réécrire toute l’orchestration.
- Vous pouvez changer le sandbox sans toucher à l’interface.
- Vous pouvez ajouter des outils métier sans casser la boucle principale.
- Vous pouvez tester plusieurs profils d’agents avec moins de dette technique.
DeepSeek Harness s’appuie aussi sur Cordis, un framework de plugins déjà éprouvé. C’est important, parce que la modularité est facile à promettre et beaucoup plus dure à maintenir proprement. Le projet revendique aussi une base conceptuelle autour de la composabilité spatio-temporelle. Dit simplement, l’objectif est de rendre les composants d’un agent plus composables dans leur contexte, dans leur ordre d’exécution, et dans leur évolution dans le temps.
Gemini 3.5 Transcribe ou GPT-Transcribe ?
Je reste prudent quand même. DeepSeek Harness est en préversion développeur. Ça veut dire que les APIs peuvent changer, les profils peuvent bouger, certaines compatibilités peuvent casser. Techniquement, c’est très intéressant. Mais je ne le traiterais pas encore comme un produit stable à déployer partout en production sans garde-fous.
| Critère | Agent prêt à l’emploi | Runtime d’agent |
| Personnalisation | Rapide au début, mais souvent limitée. | Plus flexible, car chaque couche peut être remplacée. |
| Maintenance | Simple si l’usage reste standard. | Plus exigeante, mais plus propre sur des systèmes complexes. |
| Risques | Dépendance forte aux choix du fournisseur. | Risque technique plus élevé, surtout en préversion. |
| Usage idéal | Démo, assistant simple, besoin immédiat. | Plateforme interne, agents métier, architecture évolutive. |
Qu’est-ce qui rend son architecture différente ?
Ce qui rend DeepSeek Harness différent, c’est que chaque couche importante de l’agent peut être branchée, remplacée ou inspectée comme un module. Dit simplement, on n’est pas face à un gros bloc opaque. On est face à une architecture où les morceaux de l’agent sont séparés, visibles, et interchangeables.
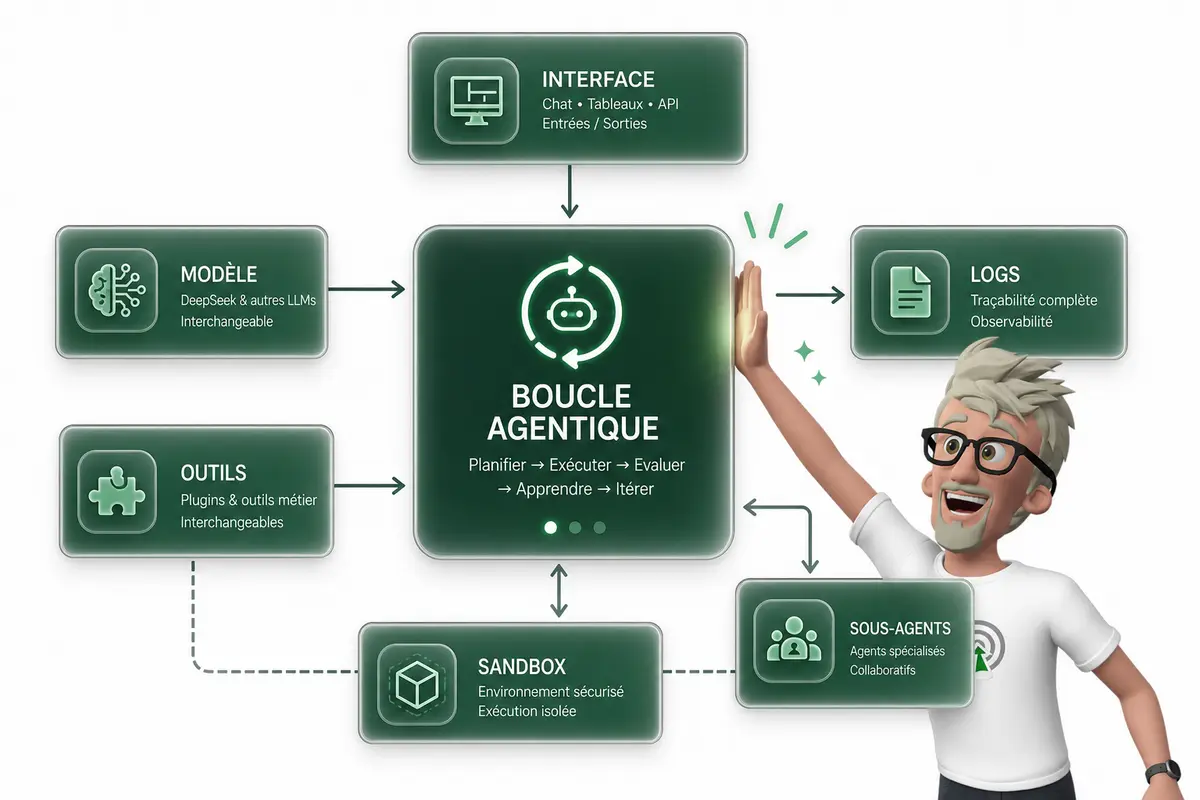
On retrouve des briques assez classiques pour un agent IA, mais elles sont pensées comme des composants. Les adaptateurs de modèles servent à connecter différents LLM, c’est-à-dire les grands modèles de langage comme GPT, Claude, Gemini ou DeepSeek. Les outils permettent à l’agent d’agir, chercher, lire, écrire, appeler une API. La sandbox isole les exécutions pour éviter qu’un agent fasse n’importe quoi sur votre environnement. Les logs gardent une trace de ce qui s’est passé. L’interface expose l’usage. La boucle agentique pilote le cycle “je réfléchis, j’agis, j’observe, je recommence”.
Quelles erreurs Python IA faussent vos modèles ?
À côté de ça, on trouve aussi les sous-agents, les approbations humaines, la planification et les préréglages. Les sous-agents permettent de déléguer des tâches spécialisées. Les approbations servent à garder la main avant une action sensible. La planification aide l’agent à découper un objectif. Les préréglages permettent de charger une configuration adaptée à un usage donné.
Le profil web par défaut montre bien cette logique. On y observe une architecture concrète composée de nombreux plugins, avec 152 plugins distincts dans la configuration par défaut. Le chiffre n’est pas là pour faire joli. Il montre surtout que la modularité n’est pas juste une promesse marketing, elle est visible dans la configuration.
Autre point important, DeepSeek Harness est model-agnostic. Ça veut dire qu’il n’est pas enfermé dans un seul modèle. Il peut fonctionner avec de nombreux fournisseurs, autour d’une quarantaine selon les éléments disponibles. Le vrai sujet, ce n’est pas le nombre exact. C’est la liberté de tester plusieurs LLM, de changer de fournisseur, d’arbitrer entre coût, latence, qualité et confidentialité.
Pourquoi choisir une architecture IA hybride ?
Dans les projets IA que je vois chez les clients, le vrai sujet arrive rarement au premier prompt. Le sujet, c’est comment on change de modèle, comment on trace les actions, comment on isole les exécutions, et comment on garde le contrôle quand l’agent commence à manipuler des outils.
- Ce que ça apporte concrètement : Plus de flexibilité, plus de contrôle, et une architecture plus facile à auditer.
- Ce que ça complexifie : La configuration, la gouvernance, les tests et la maintenance des modules.
- Pour qui ça a du sens : Les équipes qui veulent industrialiser des agents IA, pas juste faire une démo qui marche une fois.
Comment fonctionne l’isolation et la traçabilité ?
DeepSeek Harness mise sur deux choses qui ont l’air techniques, mais qui changent tout en production : l’isolation au niveau du système d’exploitation et les logs de session append-only. Pour moi, c’est là qu’on passe d’un agent “démo sympa” à un agent qu’on peut vraiment laisser travailler sans serrer les dents.
L’isolation OS-level, c’est simple dans l’idée. Au lieu de laisser l’agent agir directement sur toute la machine, on l’exécute dans un environnement limité. Sur Linux, ça peut passer par des mécanismes comme les namespaces, les permissions, les conteneurs. Sur macOS, on pense plutôt sandboxing applicatif et restrictions système. Sur Windows, on peut s’appuyer sur des environnements isolés, des droits utilisateurs limités ou des processus cloisonnés.
Le but n’est pas de faire joli dans une architecture. Le but, c’est d’éviter qu’un agent qui manipule des fichiers, lance des commandes ou appelle des outils puisse toucher à n’importe quoi. Un agent IA peut se tromper. Il peut mal interpréter une consigne. Il peut aussi recevoir une instruction piégée dans un fichier ou une page web. Si tout est ouvert, la moindre erreur devient un incident.
Les logs append-only sont l’autre moitié du sujet. Append-only veut dire qu’on ajoute les événements à l’historique, sans réécrire le passé. On garde la trace complète de la session : ce que l’agent a reçu, ce qu’il a décidé, quel outil il a appelé, avec quel résultat. Et surtout, on ne nettoie pas les traces comme si rien ne s’était passé.
En entreprise, c’est indispensable pour l’audit, le débogage, le contrôle qualité, la responsabilité et la compréhension des erreurs. J’ai vu des prototypes très prometteurs devenir inutilisables parce que personne ne pouvait expliquer pourquoi l’agent avait supprimé un fichier, modifié une donnée ou appelé le mauvais outil. Sur le moment, les logs paraissent secondaires. Le jour où l’agent fait quelque chose d’imprévu, ils deviennent la seule chose qui compte.
La délégation à des agents concurrents ou à des sous-agents rend le sujet encore plus sérieux. C’est puissant, parce qu’on peut répartir les tâches, comparer des réponses, spécialiser des agents. Mais plus il y a d’acteurs autonomes, plus la gouvernance devient compliquée. Les permissions, les logs et l’isolation ne sont plus des options. C’est le minimum vital.
| Fonctionnalité | Intérêt concret | Point de vigilance |
| Sandbox OS-level | Limiter ce que l’agent peut lire, modifier ou exécuter sur le système. | Définir des permissions assez strictes sans bloquer le travail utile. |
| Logs append-only | Conserver une trace fiable des actions, décisions et appels d’outils. | Protéger ces logs et éviter qu’ils exposent des données sensibles. |
| Sous-agents | Créer des architectures plus puissantes avec des agents spécialisés. | Éviter une chaîne d’actions impossible à comprendre ou à contrôler. |
| Approbations | Demander une validation humaine avant les actions risquées. | Bien choisir les seuils pour ne pas ralentir tout le système. |
| Registre d’outils | Savoir quels outils existent, qui peut les appeler et dans quel contexte. | Maintenir le registre à jour quand les workflows évoluent. |
Que voit-on quand on le lance vraiment ?
Quand je le lance vraiment, je ne vois pas juste un “outil IA” de plus. Je vois un vrai runtime en préversion, avec des profils, des plugins, et une logique qui ressemble plus à une plateforme qu’à un simple wrapper autour d’un modèle.
Le package npm officiel expose plusieurs profils. Je reste prudent sur leur rôle exact, parce qu’on est encore sur une base qui bouge, mais fonctionnellement ça donne ça :
| web | Semble prévu pour lancer une interface web. |
| headless | Semble prévu pour une exécution sans interface graphique, utile côté serveur ou automation. |
| tui | Semble prévu pour une interface terminal. TUI veut dire “Terminal User Interface”. |
| rescue | Semble prévu pour récupérer ou dépanner une session quand quelque chose part mal. |
Le truc le plus intéressant, à mon avis, c’est l’option –dump-default-config. Elle permet d’afficher l’arborescence complète des plugins qui composent un profil. Et là, on comprend mieux la nature du projet. Le profil web par défaut embarque 152 plugins distincts. On y voit des éléments liés à l’approbation, aux sous-agents, à la planification, aux préréglages d’agent. C’est pas anodin. On n’est pas juste sur “j’envoie un prompt et je récupère une réponse”.
Si je devais le tester proprement en local, je ferais simple. D’abord je pars du package npm officiel, sans brancher de modèle tout de suite.
Afficher l’aide installée localement, pour vérifier les commandes réellement disponibles sur votre version :
npx dsh --helpInstaller depuis le package npm officiel, en remplaçant le nom par celui indiqué dans la documentation officielle :
npm install -g <package-npm-officiel>Tester ensuite les profils disponibles, mais uniquement avec la syntaxe confirmée par l’aide locale :
dsh --helpDumper la configuration par défaut pour regarder ce qui est chargé avant de toucher aux clés API ou aux fournisseurs de modèles :
dsh --dump-default-configÀ ce moment-là, je lis les plugins chargés, je regarde les profils, je cherche les dépendances implicites. Puis seulement après, je branche un fournisseur de modèle. C’est exactement le genre de test que je fais chez un client avant de laisser un outil agentique approcher un repo ou un système interne.
Ce test raconte quelque chose d’important. Harness n’essaie pas de cacher sa mécanique. Il expose sa structure. Pour un développeur ou une équipe platform, c’est souvent plus précieux qu’une démo brillante mais fermée.
Faut-il déjà l’utiliser en production ?
Je ne mettrais pas DeepSeek Harness directement au cœur d’un système critique aujourd’hui. Pas sans une phase de test solide, avec des scénarios réels, des logs propres, des garde-fous et quelqu’un qui sait lire ce qui se passe sous le capot. Le point important, c’est qu’on est encore sur une préversion développeur, donc un terrain d’expérimentation, pas une brique à poser tranquillement en production et à oublier.
Par contre, je le regarderais très sérieusement pour prototyper une architecture d’agents modulaire. C’est là que ça devient intéressant. On retrouve une logique proche de ce qu’on a vu avec DeepSeek-R1 : l’intérêt n’est pas seulement d’avoir un modèle de plus, ou un agent qui répond joliment dans une interface. L’intérêt, c’est d’ouvrir une couche technique accessible, inspectable et réutilisable. Avec R1, cette logique touchait surtout le modèle et le raisonnement. Avec Harness, elle touche la couche agent.
Les bons cas d’usage sont assez clairs. Je le vois bien dans un laboratoire IA interne, un POC agentique, c’est-à-dire une preuve de concept autour d’agents capables d’utiliser des outils, ou dans un benchmark de modèles pour comparer plusieurs LLM dans les mêmes conditions. Je le vois aussi pour tester une architecture multi-agents, expérimenter avec une sandbox, donc un environnement isolé qui limite les dégâts possibles, ou réfléchir sérieusement aux logs, à la traçabilité et à la gouvernance.
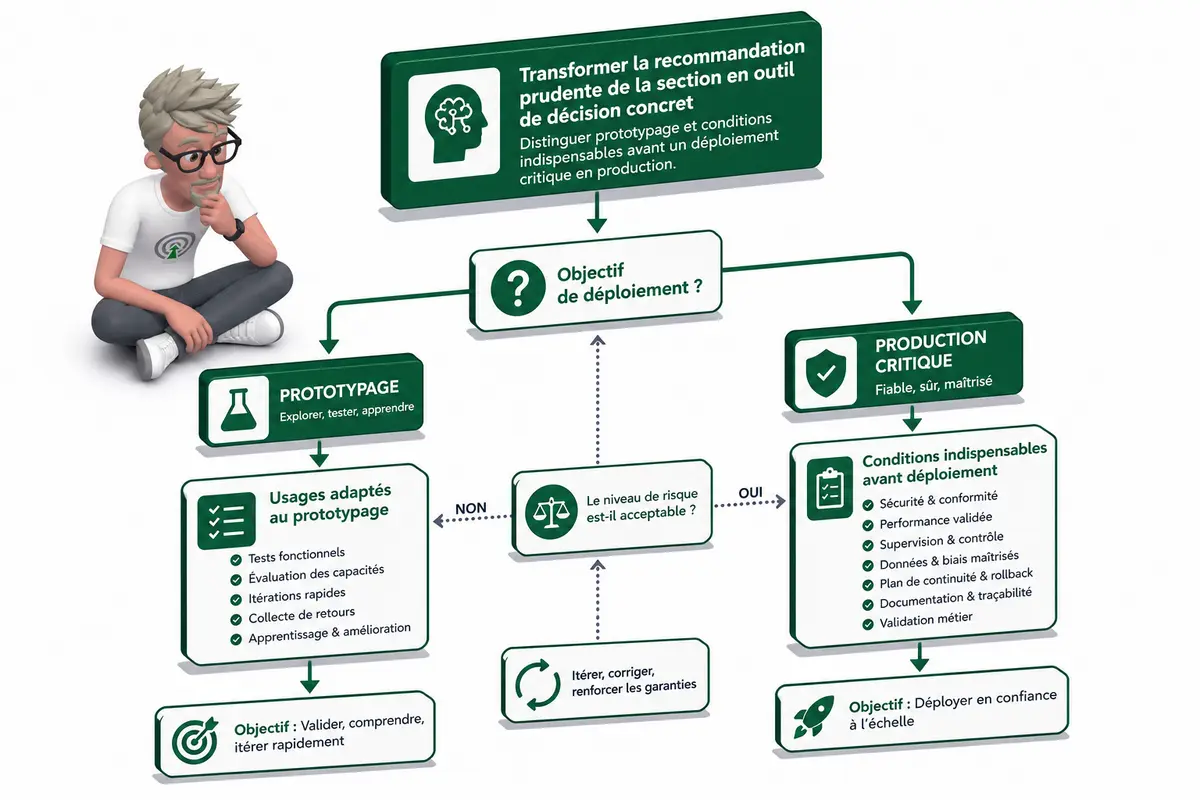
Les mauvais cas d’usage sont tout aussi clairs. Un déploiement immédiat sans contrôle, c’est non. Une automatisation sensible sans audit, comme toucher à des données clients, déclencher des paiements ou modifier un CRM en autonomie, c’est non aussi. Et si l’équipe n’a pas la capacité technique de maintenir des plugins, suivre les changements cassants, les fameux breaking changes, et corriger vite, je passerais mon tour pour l’instant.
Mon avis est simple : dans les projets business, le piège, c’est de confondre agent IA et infrastructure d’agent. Un agent qui répond dans une interface, c’est une démo. Une infrastructure qui gère les modèles, les outils, les logs, l’isolation, les droits et l’évolutivité, c’est autre chose. DeepSeek Harness semble jouer dans cette deuxième catégorie.
- Stabilité du projet : Vérifier la fréquence des mises à jour et les ruptures possibles.
- Sécurité du sandbox : Tester l’isolation avant de connecter des outils sensibles.
- Politique de logs : Définir ce qui est enregistré, où, combien de temps, et qui y accède.
- Choix des modèles : Comparer les performances, les coûts et les limites de chaque modèle.
- Gestion des plugins : Identifier qui les maintient et comment ils sont validés.
- Tests de régression : Rejouer les scénarios critiques après chaque mise à jour.
- Responsabilités internes : Nommer clairement les personnes responsables du monitoring, de la sécurité et des incidents.
DeepSeek Harness mérite-t-il une place dans votre veille IA ?
DeepSeek Harness m’intéresse parce qu’il déplace le sujet. On ne parle pas juste d’un agent qui code ou qui répond à des prompts. On parle d’un runtime d’agent, modulaire, ouvert, pensé pour brancher des modèles, des outils, des interfaces, des logs et du sandboxing. C’est plus technique, moins sexy au premier regard, mais souvent beaucoup plus utile pour construire quelque chose de durable.
Je resterais prudent sur la production, vu la préversion développeur. Par contre, pour comprendre où va l’infrastructure agentique, ça vaut clairement le test. Le bénéfice pour vous : mieux distinguer la démo IA sympa de la vraie base technique exploitable.
FAQ
- DeepSeek Harness sert à quoi exactement ?
DeepSeek Harness sert de runtime open source pour construire des agents IA. Je le vois moins comme un agent prêt à l’emploi que comme une base technique pour assembler des modèles, des outils, des logs, une interface, un sandbox et une boucle agentique. - Pourquoi son architecture plugin-first est importante ?
Parce qu’elle permet de remplacer ou d’adapter chaque couche de l’agent sans tout reconstruire. Le modèle, les outils, le sandbox, les logs ou l’interface peuvent être gérés comme des plugins. Pour une équipe technique, c’est un vrai avantage quand on veut garder de la flexibilité. - DeepSeek Harness fonctionne-t-il avec plusieurs modèles IA ?
Oui, son positionnement est model-agnostic. Il est conçu pour fonctionner avec de nombreux fournisseurs de modèles, autour d’une quarantaine selon les éléments disponibles. L’intérêt, c’est de ne pas enfermer l’agent dans un seul fournisseur. - Le sandboxing de DeepSeek Harness change quoi ?
Le sandboxing au niveau OS permet d’isoler réellement les actions de l’agent sur Linux, macOS et Windows. C’est important dès qu’un agent exécute des commandes, manipule des fichiers ou déclenche des outils. Sans isolation sérieuse, un agent devient vite risqué. - DeepSeek Harness est-il prêt pour la production ?
Je resterais prudent. Le projet est en préversion développeur, donc il peut changer vite et introduire des incompatibilités. Je le testerais volontiers pour prototyper, auditer l’architecture agentique et préparer une stratégie, mais pas sans validation solide pour un usage critique.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent passer des prototypes IA à des systèmes fiables, traçables et utiles pour le business. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez structurer vos projets data, IA ou automatisation proprement, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.