


Un workflow IA peut tourner sans planter et produire un modèle faux. Je vais droit au sujet : les erreurs Python les plus sournoises touchent le split, le prétraitement, l’inférence, la reproductibilité, PyTorch et les artefacts. C’est là que je regarde en premier chez mes clients.
Où commence la fuite de données ?
La fuite commence souvent quand je fitte un prétraitement avant de séparer les données, ou quand je refais à la main un prétraitement différent entre entraînement et inférence. Fitter, ça veut dire apprendre quelque chose depuis les données. Une moyenne pour remplacer les valeurs manquantes, une échelle pour normaliser, les meilleures variables à garder, tout ça c’est déjà de l’apprentissage.
Le piège, c’est que le modèle ne voit pas seulement les features. Il voit aussi toutes les décisions prises avant le split : sélection de variables, normalisation, imputation, encodage, réduction de dimension. Le code tourne. Les scores sont parfois très bons. Et pourtant le modèle est déjà contaminé, parce qu’une partie de l’information du test a servi à préparer les données.
Quelle mémoire IA choisir pour vos agents ?
Voici le mauvais réflexe classique, puis la correction avec Pipeline. Dans scikit-learn, un Pipeline chaîne les transformations et le modèle. Chaque pli de validation fitte son propre transformateur. Jamais un transformateur appris sur tout le dataset.
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import Pipeline

# Données volontairement bruitées : aucune vraie relation fiable
X = np.random.normal(size=(200, 10000))
y = np.random.randint(0, 2, size=200)

# Mauvais réflexe : le sélecteur apprend sur tout X et tout y avant la validation
bad_selector = SelectKBest(score_func=f_classif, k=25).fit(X, y)
X_bad = bad_selector.transform(X)

bad_score = cross_val_score(
    LogisticRegression(max_iter=1000),
    X_bad,
    y,
    cv=5
).mean()

# Bon réflexe : le sélecteur est fitté à l’intérieur de chaque pli
pipe = Pipeline([
    ('select', SelectKBest(score_func=f_classif, k=25)),
    ('model', LogisticRegression(max_iter=1000))
])

good_score = cross_val_score(pipe, X, y, cv=5).mean()

print('Score contaminé', round(bad_score, 3))
print('Score pipeline', round(good_score, 3))
Le même sujet revient en production. Si je sauvegarde seulement le modèle, je risque de refaire le prétraitement autrement dans l’API, le batch ou le notebook. C’est le fameux skew entraînement production : la donnée n’est plus préparée pareil.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
import joblib

# Le pipeline contient le prétraitement appris et le modèle
pipe.fit(X_train, y_train)
joblib.dump(pipe, 'model_pipeline.joblib')

# En production, je recharge exactement la même logique
production_pipe = joblib.load('model_pipeline.joblib')
predictions = production_pipe.predict(X_new)
Chez un client, le modèle avait de beaux scores parce que le scaler avait vu le futur, pas parce qu’il généralisait. C’est frustrant, mais c’est exactement pour ça que je préfère enfermer toute la logique dans un Pipeline.
| Erreur | Symptôme | Contrôle simple |
| Prétraitement fitté avant le split | Score anormalement élevé en validation | Vérifier que fit est dans le Pipeline |
| Transformateur réutilisé sur tous les plis | Validation croisée trop optimiste | Lancer cross_val_score sur le Pipeline complet |
| Prétraitement recréé à la main en production | Prédictions instables ou incohérentes | Sauvegarder et charger le Pipeline complet |
Votre split teste quoi exactement ?
Gemini 3.5 Transcribe ou GPT-Transcribe ?
Un split teste la vraie capacité du modèle seulement si la frontière de test ressemble à la frontière business réelle. C’est tout bête, mais j’ai vu des scores “incroyables” tomber de 0,92 à 0,63 juste parce qu’on avait séparé les lignes au hasard alors qu’elles venaient des mêmes clients.
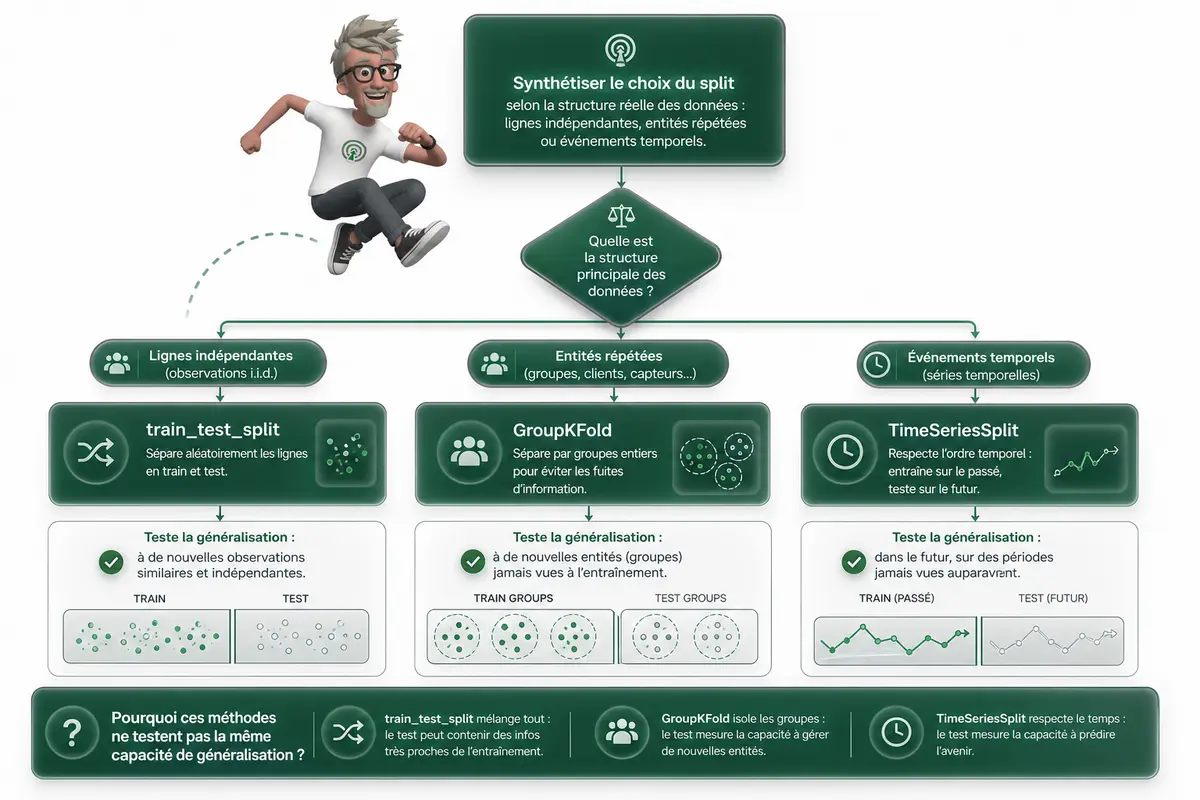
Un train_test_split aléatoire est correct uniquement quand les lignes sont indépendantes. Si plusieurs lignes appartiennent au même utilisateur, patient, appareil, magasin ou session, le modèle peut apprendre à reconnaître l’entité au lieu d’apprendre une règle généralisable. Il ne prédit plus vraiment, il se souvient. Sur des données temporelles, c’est encore plus piégeux : un mélange aléatoire peut mettre le futur dans le passé, donc votre modèle apprend avec des informations qu’il n’aura jamais en production.
Quand une même entité apparaît plusieurs fois, j’utilise GroupKFold. L’idée est simple : un groupe présent dans le test ne doit jamais être présent dans le train.
from sklearn.model_selection import GroupKFold, cross_val_score

# Exemple : plusieurs lignes appartiennent au même utilisateur
groups = df['user_id']
X = df[feature_columns]
y = df['target']

cv = GroupKFold(n_splits=5)

scores = cross_val_score(
    pipe,
    X,
    y,
    groups=groups,
    cv=cv
)

print('Score moyen avec groupes séparés', scores.mean())
Pourquoi choisir une architecture IA hybride ?
Quand les données ont un ordre naturel dans le temps, j’utilise TimeSeriesSplit. Le modèle s’entraîne sur le passé, puis il est validé sur une période future. C’est souvent beaucoup plus proche de la vraie vie.
from sklearn.model_selection import TimeSeriesSplit, cross_val_score

# Les données doivent être triées avant le split temporel
df_sorted = df.sort_values('event_date')
X_sorted = df_sorted[feature_columns]
y_sorted = df_sorted['target']

ts_cv = TimeSeriesSplit(n_splits=5)

scores = cross_val_score(
    pipe,
    X_sorted,
    y_sorted,
    cv=ts_cv
)

print('Score moyen en validation temporelle', scores.mean())
Je fais aussi un contrôle simple avant de croire un score. Ça évite les mauvaises surprises.
# Vérifier qu'aucun groupe du test n'existe dans le train
train_idx, test_idx = next(cv.split(X, y, groups=groups))

train_groups = set(groups.iloc[train_idx])
test_groups = set(groups.iloc[test_idx])

assert train_groups.isdisjoint(test_groups)

# Vérifier que chaque validation temporelle est après l'entraînement
for train_idx, val_idx in ts_cv.split(X_sorted):
    max_train_date = df_sorted.iloc[train_idx]['event_date'].max()
    min_val_date = df_sorted.iloc[val_idx]['event_date'].min()
    assert max_train_date < min_val_date
Le bon split n’est pas un détail statistique. C’est la définition exacte de ce que votre modèle devra réussir une fois branché dans le vrai système.
| Cas | Split à utiliser | Risque si on se trompe |
| Lignes indépendantes | Train_test_split aléatoire | Risque faible si l’hypothèse d’indépendance est vraie |
| Utilisateurs répétés | GroupKFold avec user_id | Le modèle reconnaît les utilisateurs au lieu de généraliser |
| Patients répétés | GroupKFold avec patient_id | Le score médical paraît meilleur qu’il ne l’est vraiment |
| Séries temporelles | TimeSeriesSplit | Le futur fuit dans le passé, le score est artificiel |
Une seed suffit vraiment ?
DeepSeek Harness est-il la base des agents IA ?
Une seed aide, oui. Mais elle ne rend pas un workflow IA reproductible à elle seule. Elle règle une partie du hasard, pas tout le système autour.
Je fais une différence simple entre répétabilité locale et reproductibilité réelle. La répétabilité locale, c’est relancer le même script sur ma machine et obtenir à peu près le même résultat. La reproductibilité réelle, c’est pouvoir expliquer un résultat dans le temps, sur une autre machine, avec les mêmes données, le même code, les mêmes dépendances et la même configuration.
Je peux fixer random, NumPy et PyTorch, puis avoir encore des écarts. Si les données ont changé. Si une dépendance a bougé. Si le code a été modifié. Si la configuration n’est pas versionnée. Si certains calculs GPU restent non déterministes. Le GPU va très vite, mais certaines opérations parallèles ne garantissent pas toujours le même ordre de calcul, donc pas toujours le même résultat au bit près.
Ce bloc sert à fixer les principales sources d’aléatoire côté Python, NumPy et PyTorch. C’est le minimum que je mets dans un projet sérieux, surtout pendant les phases de debug et de comparaison de modèles.
import random
import numpy as np
import torch

SEED = 42

random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)
torch.cuda.manual_seed_all(SEED)

# Rend certains calculs CUDA plus déterministes, avec un coût possible en performance
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False
Mais ça ne suffit pas. La reproductibilité demande un contrat complet : données, code, configuration, dépendances, artefacts, métriques et environnement d’exécution. En entreprise, c’est très concret. Quand un score change et que personne ne sait pourquoi, on perd du temps, puis on perd de la confiance. J’ai déjà vu des équipes chercher un bug modèle pendant deux jours alors que le fichier d’entraînement avait juste été régénéré silencieusement.
Ce hash permet de prouver qu’on parle bien du même dataset. Si l’empreinte change, le fichier a changé, même si son nom est identique.
import hashlib


def sha256_file(path):
    h = hashlib.sha256()
    with open(path, 'rb') as f:
        for chunk in iter(lambda: f.read(1024 * 1024), b''):
            h.update(chunk)
    return h.hexdigest()

print(sha256_file('train.parquet'))
Ma checklist courte ressemble à ça :
- Seed fixée pour Python, NumPy et le framework IA.
- Hash des données sauvegardé.
- Version du code tracée avec un commit Git.
- Versions des librairies exportées.
- Fichier de configuration versionné.
- Paramètres d’entraînement sauvegardés.
- Métriques et artefacts conservés.
Je ne cherche pas une reproductibilité parfaite partout. Je cherche d’abord à savoir ce qui a changé.
| Élément à figer | Pourquoi | Comment le contrôler |
| Seed | Réduire l’aléatoire pendant l’entraînement. | Fixer random, NumPy, PyTorch ou TensorFlow. |
| Données | Éviter de comparer deux datasets différents. | Calculer un hash SHA-256 et versionner les datasets. |
| Code | Savoir quelle logique a produit le modèle. | Utiliser un commit Git associé à chaque run. |
| Dépendances | Éviter les écarts liés aux versions de librairies. | Sauvegarder requirements.txt, poetry.lock ou conda env. |
| Configuration | Retrouver les paramètres exacts du run. | Versionner les fichiers YAML, JSON ou TOML. |
| Artefacts et métriques | Comparer proprement les résultats. | Stocker modèles, logs, scores et courbes d’entraînement. |
PyTorch évalue bien votre modèle ?
PyTorch évalue correctement seulement si je combine le bon mode du modèle, la bonne gestion des gradients et des formes cohérentes.
Le piège classique, c’est de croire que model.eval() et torch.no_grad() font la même chose. Non. model.eval() change le comportement du modèle. Des couches comme Dropout, qui coupe au hasard certains neurones pendant l’entraînement, ou BatchNorm, qui utilise des statistiques de batch, ne se comportent plus pareil en validation.
torch.no_grad(), lui, dit juste à PyTorch de ne pas construire le graphe de gradients. Ça économise de la mémoire et du calcul. C’est utile en validation ou en prédiction. Mais ça ne met pas le modèle en mode évaluation. Les deux sont nécessaires dans beaucoup de cas.
Quand je fais une vraie inférence, sans aucun besoin d’autograd, je peux aussi utiliser torch.inference_mode(). C’est plus strict et souvent plus optimisé que no_grad(). Je l’utilise surtout quand je suis sûr que je ne vais pas reprendre une opération qui dépend des gradients.
Le schéma propre ressemble à ça :
import torch

model.eval()

with torch.no_grad():
    y_pred = model(x_val)
    val_loss = criterion(y_pred, y_val)

# Si je reprends l’entraînement après l’évaluation
model.train()
J’ai déjà vu des scores de validation bouger bizarrement juste parce que model.train() n’avait jamais été remis après une évaluation. Le modèle continuait avec Dropout désactivé. Les courbes semblaient “propres”, mais l’entraînement était faux.
L’autre erreur sournoise, c’est le broadcasting. C’est la diffusion automatique des dimensions par PyTorch. Exemple simple : une prédiction en forme [batch, 1] et une cible en forme [batch]. PyTorch peut calculer une loss quand même. Elle a l’air plausible. Mais elle peut être fausse, parce que les dimensions ont été étendues automatiquement.
Je préfère être explicite avant la loss :
pred = model(x_batch)
target = y_batch

# Si la cible doit vraiment avoir la même forme que la prédiction,
# je le rends explicite au lieu de laisser PyTorch deviner.
target = target.view_as(pred)

if pred.shape != target.shape:
    raise ValueError(f'Forme prédite {pred.shape} différente de la cible {target.shape}')

loss = criterion(pred, target)
Attention quand même. view_as ne doit pas servir à cacher un problème. Je dois savoir ce que je fais : régression, classification binaire, classification multi-classes. La forme attendue dépend aussi de la fonction de perte. Une MSELoss, une BCEWithLogitsLoss et une CrossEntropyLoss n’attendent pas les mêmes tenseurs.
| Erreur | Symptôme | Contrôle à ajouter |
| eval oublié | Validation instable, Dropout ou BatchNorm actifs | Appeler model.eval() avant la validation |
| no_grad oublié | Mémoire GPU qui monte, validation lente | Encadrer l’évaluation avec torch.no_grad() |
| train non réactivé | Entraînement qui continue en mode évaluation | Appeler model.train() après la validation |
| mismatch de shape | Loss plausible mais fausse | Comparer pred.shape et target.shape avant criterion |
Vos artefacts sont-ils fiables ?
Un artefact de modèle n’est pas une donnée inerte, c’est un objet à traiter comme du code et comme une dépendance de production. Je ne le pose jamais dans un dossier en me disant “c’est juste un .joblib” ou “c’est juste un .pt”. C’est exactement comme ça qu’on introduit des bugs invisibles, ou pire.
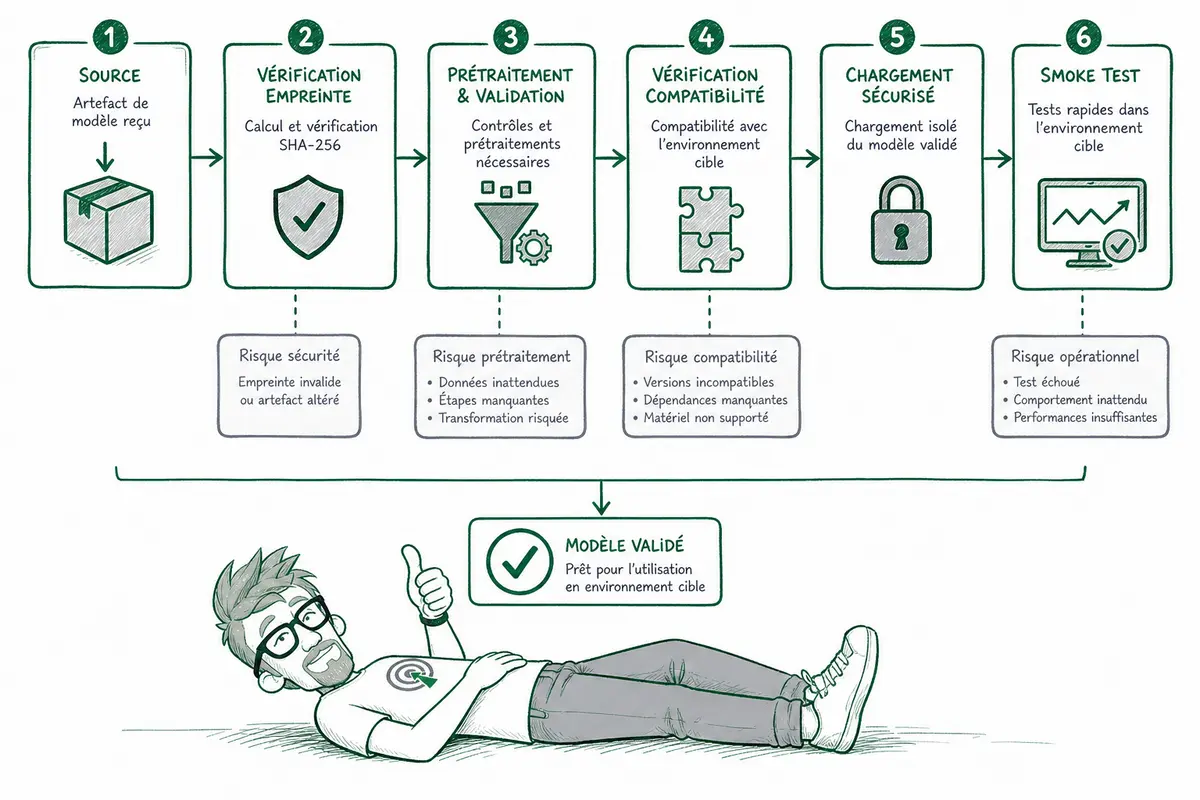
Charger un modèle sérialisé pose deux problèmes très concrets : la sécurité et la compatibilité. Côté sécurité, la documentation Python de pickle est claire : un objet pickle non fiable peut exécuter du code au moment de la désérialisation. Côté compatibilité, votre artefact peut dépendre de versions précises de Python, scikit-learn, PyTorch, NumPy, ou même d’un prétraitement maison oublié dans un notebook.
Joblib est très utilisé avec scikit-learn, et c’est pratique. Mais joblib repose sur les mêmes limites de confiance que pickle. Donc avant de charger, je contrôle au minimum l’empreinte du fichier. Ça ne rend pas le modèle “sûr”, mais ça permet de vérifier que je charge bien l’artefact attendu, pas une version modifiée ou remplacée.
from pathlib import Path
import hashlib
import joblib

TRUSTED_SHA256 = 'remplacer_par_le_hash_attendu'


def sha256_file(path):
    h = hashlib.sha256()
    with open(path, 'rb') as f:
        for chunk in iter(lambda: f.read(1024 * 1024), b''):
            h.update(chunk)
    return h.hexdigest()

artifact_path = Path('model_pipeline.joblib')

if sha256_file(artifact_path) != TRUSTED_SHA256:
    raise RuntimeError('Artefact non conforme')

pipeline = joblib.load(artifact_path)
Juste après le chargement, je fais aussi un smoke test. Un smoke test, c’est un test rapide qui vérifie que le modèle respire encore : il accepte l’entrée prévue, il renvoie une sortie cohérente, il ne plante pas bêtement au premier appel.
predictions = pipeline.predict(X_smoke_test)

assert predictions.shape[0] == X_smoke_test.shape[0]
assert predictions is not None
Pour PyTorch, je préfère sauvegarder et charger le state_dict quand c’est possible. Le state_dict contient surtout les poids du modèle, pas toute la logique Python autour. Et quand le contexte PyTorch le permet, j’utilise weights_only=True avec torch.load, parce que l’idée est de réduire ce qui est désérialisé.
import torch

state_dict = torch.load(
    'model_weights.pt',
    map_location='cpu',
    weights_only=True
)

model.load_state_dict(state_dict)
model.eval()
Avant la production, je teste toujours l’artefact dans l’environnement cible : même OS si possible, mêmes versions critiques, même format d’entrée, même pipeline de prétraitement, mêmes seuils de décision. Un bon artefact embarque ou documente les contrats de données, de forme, d’état et de version. Sinon, c’est une bombe à retardement. Je ne charge jamais un modèle inconnu juste parce qu’il a une extension rassurante.
| Risque | Exemple | Contrôle minimal |
| Sécurité | Un pickle ou joblib non fiable exécute du code au chargement | Source fiable, empreinte SHA-256, stockage contrôlé |
| Compatibilité | Modèle entraîné avec une autre version de scikit-learn ou NumPy | Versions figées, test dans l’environnement cible |
| Prétraitement | Scaler, encodage ou ordre des colonnes différent | Pipeline complet, contrat d’entrée documenté |
| Comportement | Sorties vides, mauvaise forme, seuil oublié | Smoke test, seuils versionnés, cas de référence |
Et maintenant vous vérifiez quel contrat en premier ?
Le piège avec Python dans les workflows IA, c’est que beaucoup d’erreurs ne cassent rien. Le script tourne, la loss baisse, le dashboard affiche un score propre. Puis en production, ça se dégrade. Je vérifie donc les contrats simples : split réaliste, prétraitement fitté au bon endroit, même pipeline en inférence, reproductibilité tracée, évaluation PyTorch correcte, formes validées, artefacts fiables. Ce n’est pas du perfectionnisme, c’est de l’hygiène. En ajoutant ces contrôles tôt, vous évitez les modèles flatteurs mais inutilisables, et vous gagnez du temps sur vos vrais problèmes business.
FAQ
- Pourquoi un modèle IA peut-il être faux alors que le code Python fonctionne ?
Parce que certaines erreurs ne provoquent pas d’exception. Une fuite de données, un mauvais split, un prétraitement différent en production ou une forme mal diffusée peuvent produire des métriques crédibles mais trompeuses. - Quelle est l’erreur Python la plus fréquente dans un workflow IA ?
Je vois très souvent le prétraitement fitté avant le split. Le scaler, le sélecteur de variables ou l’imputer apprend alors des informations issues du jeu de test. La correction la plus simple reste d’utiliser un Pipeline scikit-learn. - Quand faut-il éviter un train_test_split aléatoire ?
Dès que les lignes ne sont pas indépendantes. Si plusieurs lignes viennent du même utilisateur, patient, appareil ou si les données sont temporelles, je préfère un split par groupe ou par temps. - Quelle différence entre eval et no_grad dans PyTorch ?
model.eval() change le comportement de certaines couches comme Dropout et BatchNorm. torch.no_grad() désactive le calcul des gradients. En évaluation, j’utilise généralement les deux, puis je repasse en model.train() si je reprends l’entraînement. - Pourquoi faut-il se méfier des modèles sérialisés ?
Parce qu’un artefact chargé avec pickle, joblib ou certains mécanismes de sérialisation peut poser des risques de sécurité et de compatibilité. Je charge uniquement depuis une source fiable, je vérifie l’empreinte du fichier et je fais un smoke test dans l’environnement cible.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Avec mon agence webAnalyste et Formations Analytics, j’accompagne des équipes chez Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football, Texdecor et d’autres. Si vous voulez fiabiliser vos pipelines data, IA ou automatisation, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.