
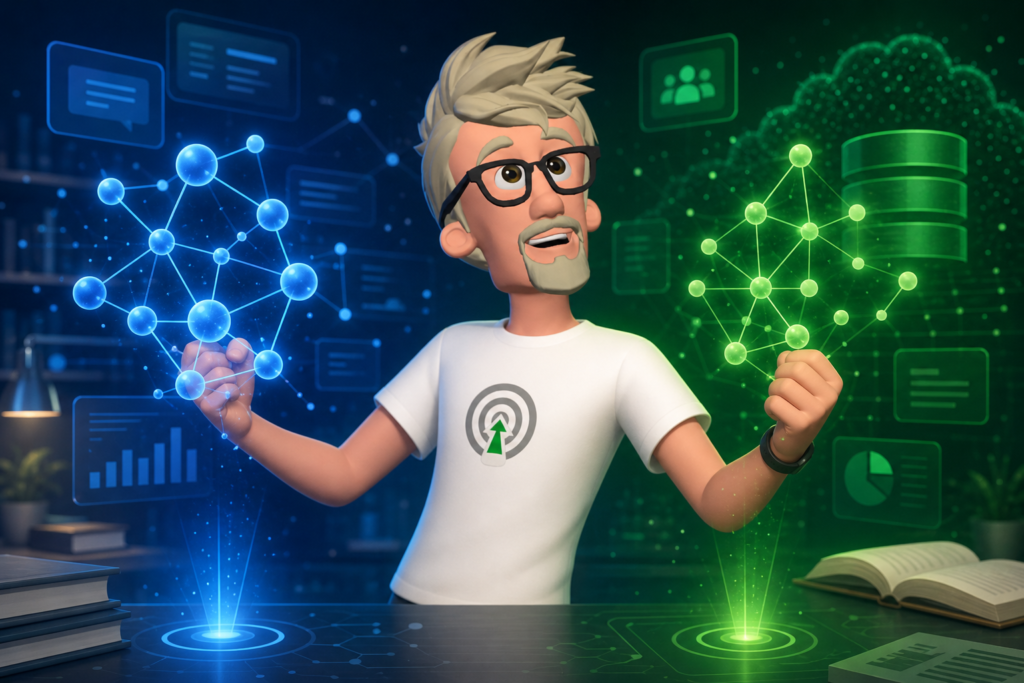
Le RAG vectoriel convient aux réponses contenues dans quelques passages ; le RAG avec graphe de connaissances relie des faits dispersés et soutient le raisonnement multi-étapes. Je détaille les différences, les coûts, la traçabilité et les critères qui permettent de choisir sans complexifier inutilement votre architecture.
Comment un graphe de connaissances ancre-t-il un LLM ?
Un graphe de connaissances ancre un LLM en lui fournissant des faits structurés qu’il peut récupérer et intégrer à son contexte avant de répondre. Je choisis un graphe quand la réponse dépend de relations explicites entre des entités, pas seulement de la similarité entre une question et un passage de texte.
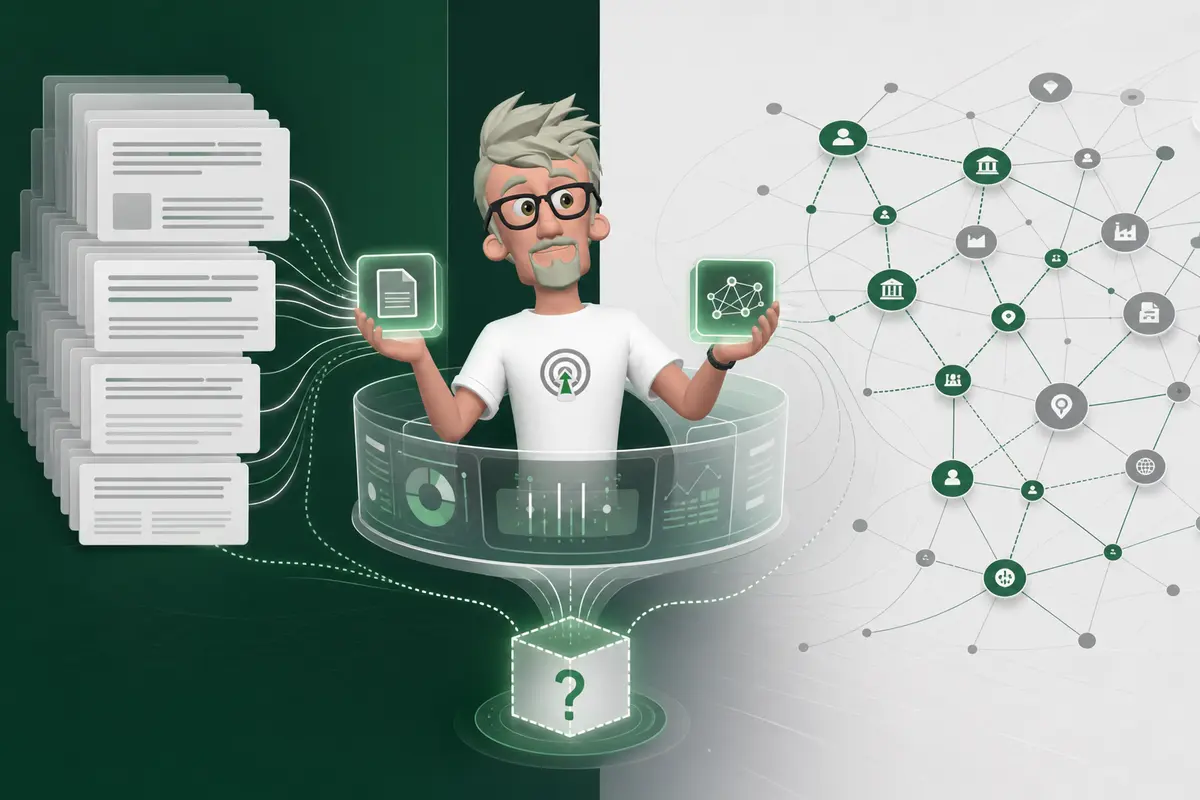
Un graphe représente des informations sous forme de nœuds et d’arêtes. Un nœud représente une entité — une personne, une entreprise, un produit ou un concept. Une arête relie deux nœuds. La relation désigne précisément le sens de ce lien : « travaille pour », « possède » ou « est situé à ». Un fait peut ainsi être représenté par un triplet sujet-prédicat-objet : « Alice » — « travaille pour » — « Acme ». La sémantique, c’est-à-dire le sens attribué aux types de nœuds et de relations, permet d’interpréter ce fait plutôt que de traiter le lien comme une simple connexion.
Comment classer des textes en few-shot avec Scikit-LLM ?
Le modèle conserve ses connaissances préentraînées, acquises pendant son entraînement. Le graphe apporte des informations externes, explicites et consultables au moment de la réponse. Le LLM peut alors s’appuyer sur les faits récupérés, par exemple pour suivre plusieurs relations et répondre à une question qui nécessite un raisonnement sur des entités liées.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Cette distinction aide à choisir le bon mécanisme de RAG (Retrieval-Augmented Generation, ou génération augmentée par récupération) :
| RAG vectoriel | À privilégier pour retrouver des passages pertinents dans des documents selon leur sens, même si les mots diffèrent. |
| RAG sur graphe | À privilégier quand il faut interroger des relations précises, appliquer des contraintes ou suivre plusieurs liens entre entités. |
| Approche hybride | À retenir quand les documents apportent le contexte et que le graphe fournit les relations structurées. |
Le contexte externe peut réduire les hallucinations, car le modèle dispose de faits vérifiables au lieu de s’appuyer uniquement sur ses paramètres. Ce n’est pas une garantie. J’ai déjà vu un graphe produire une réponse nette mais fausse parce qu’une relation avait été mal modélisée. L’exactitude dépend de la qualité des données, de la construction du graphe et de la récupération des bons faits.
Quand le RAG vectoriel suffit-il ?
Comment utiliser Gemini 4 Argon dans n8n ?
Le RAG vectoriel suffit généralement lorsque la réponse se trouve dans un passage, ou dans quelques passages sémantiquement proches de la question. Le système transforme la question et les documents en représentations numériques, puis récupère les passages dont les vecteurs sont les plus similaires à celui de la question. Le modèle génère sa réponse à partir de ces extraits.
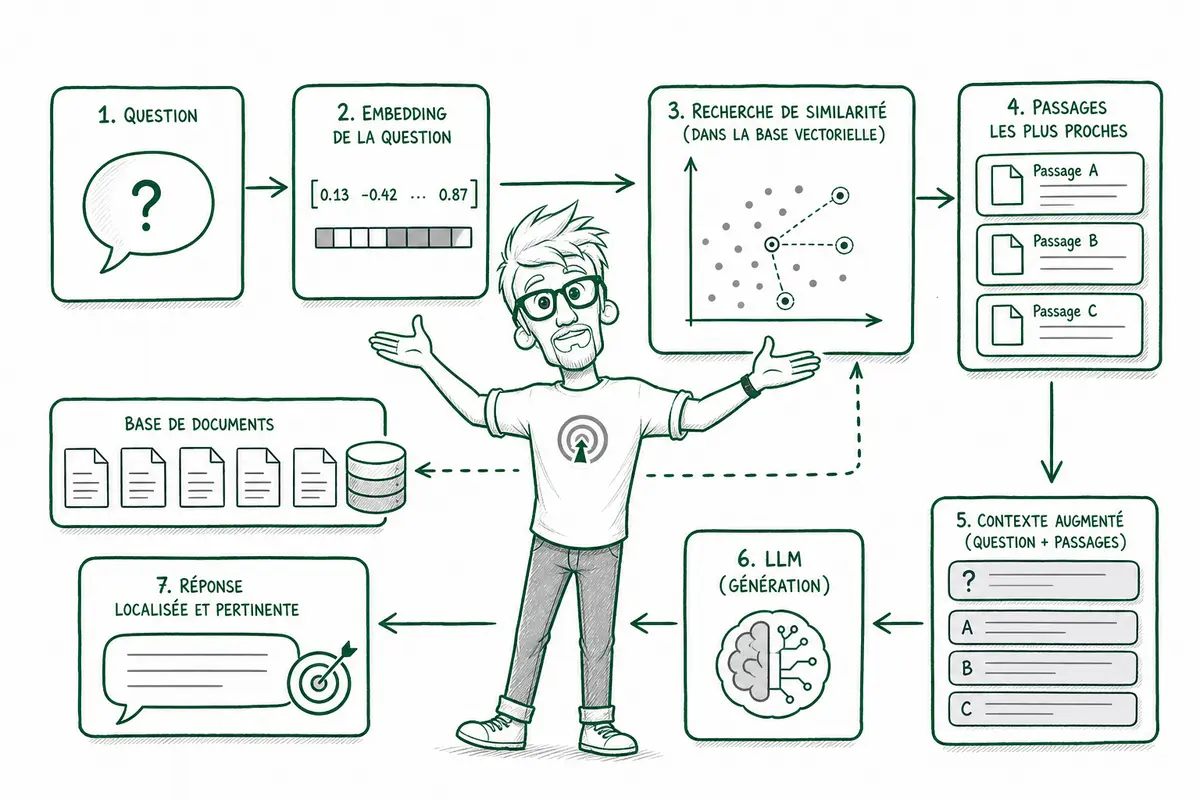
Les vecteurs denses capturent la proximité de sens, même si la question et le document n’emploient pas les mêmes termes. Ils sont utiles pour retrouver, par exemple, un passage sur la résiliation d’un contrat à partir d’une question parlant de « mettre fin à l’accord ». Les vecteurs clairsemés représentent plutôt les mots présents dans les textes. Ils renforcent la recherche de termes précis, comme un nom de produit, une référence ou un identifiant. En pratique, combiner les deux permet de couvrir à la fois la recherche sémantique et la correspondance lexicale.
Cette approche est souvent plus simple à construire et à maintenir qu’un système fondé sur un graphe : on indexe les documents, on récupère les passages pertinents, puis on les transmet au modèle. C’est un bon choix pour une base documentaire où chaque réponse est principalement localisée dans un extrait identifiable.
Comment passer un prototype IA en production SaaS ?
La limite apparaît quand les éléments utiles sont répartis dans plusieurs documents et doivent être reliés. Une question sur l’évolution d’un indicateur, par exemple, peut nécessiter de rapprocher une définition, une valeur historique et une règle métier. La similarité vectorielle peut retrouver ces passages, mais elle ne modélise pas explicitement les relations entre les entités ni le chemin logique qui les relie.
Ça ne signifie pas qu’un RAG vectoriel ne peut pas traiter des questions complexes. Il peut nécessiter des mécanismes supplémentaires : recherche itérative, reformulation de la question, récupération de plusieurs ensembles de passages ou reranking — le reclassement des résultats selon leur pertinence. Quand ces liens sont nombreux, structurés et récurrents, un graphe devient plus adapté pour représenter et parcourir explicitement les relations.
Quand un graphe devient-il préférable ?
Un graphe devient préférable lorsque la réponse exige de relier des faits répartis entre plusieurs sources ou de suivre plusieurs étapes de raisonnement. Une recherche vectorielle retrouve des passages proches d’une question par leur sens. Elle est efficace quand la réponse se trouve dans un passage identifiable, moins quand elle dépend de relations indirectes entre plusieurs faits.
Que faut-il savoir sur IQuest-Q1, le modèle MoE ?
Le graphe représente les entités — personnes, organisations, produits, événements — et les relations qui les relient. L’extraction identifie ces éléments dans les documents, puis les relie à leurs sources. À la question « Quels fournisseurs sont liés à une entreprise impliquée dans une fraude ? », le système peut parcourir plusieurs relations, récupérer les faits pertinents et assembler ce contexte pour le LLM, le modèle de langage qui rédige la réponse.
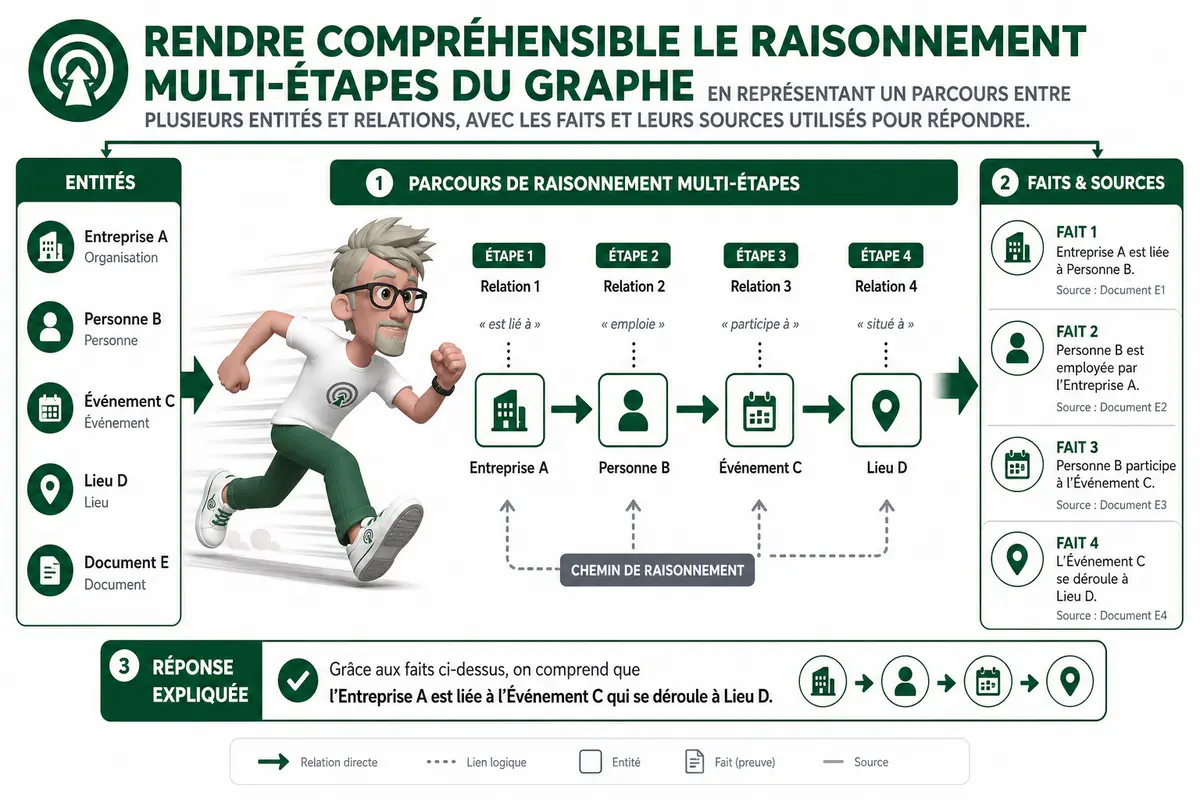
Les chemins parcourus rendent aussi les réponses plus traçables : on peut montrer quels faits et quelles relations les étayent. C’est utile dans les secteurs réglementés, où une réponse doit être vérifiable, pas seulement plausible. Le graphe peut réduire le contexte non pertinent transmis au modèle et donc le nombre de jetons consommés. Mais ce gain dépend de la qualité du graphe et doit être comparé au coût d’extraction, de validation et de maintenance. Un graphe incomplet ou obsolète dégrade les résultats.
Je privilégie le graphe quand les relations entre les données portent l’essentiel de la réponse, notamment pour :
- La détection de fraude, afin de repérer des liens indirects entre comptes, transactions et entités.
- Les recommandations, lorsqu’elles dépendent de relations entre profils, produits et usages.
- La recherche biomédicale, pour relier gènes, maladies, traitements et publications.
Si vos questions portent surtout sur la similarité sémantique de documents, le RAG vectoriel reste souvent plus simple à exploiter. Quand les questions demandent plusieurs sauts dans les données, le graphe prend l’avantage. Dans certains systèmes, les deux approches se complètent : le vecteur repère les passages, le graphe explicite les relations.
Comment construire un graphe à partir de texte ?
Un LLM peut transformer un texte non structuré en entités, relations et triplets, puis enregistrer ces faits dans un graphe. Le modèle facilite l’extraction, mais ne garantit ni l’exactitude des faits ni la cohérence du graphe.
Le flux conceptuel suit quatre étapes :
- Segmenter le texte en passages assez courts pour être analysés sans perdre le contexte utile.
- Repérer les entités mentionnées : personnes, organisations, produits, lieux ou concepts. Les mentions désignant la même entité doivent ensuite être rapprochées.
- Extraire les relations sous forme de triplets sujet-prédicat-objet. Par exemple, « Amina dirige l’équipe Data » devient « Amina — dirige — équipe Data ».
- Enregistrer les faits dans le graphe, en conservant si possible la source du passage. Cette provenance permet de vérifier pourquoi une relation a été créée.
Un schéma prédéfini impose les types d’entités et de relations autorisés. C’est adapté quand le domaine est stable et que les données doivent rester homogènes. Une structure plus évolutive accepte de nouveaux types au fil des textes ; elle est utile quand le vocabulaire ou le domaine change, mais demande davantage de contrôles. Le choix dépend du besoin métier, de la variabilité des sources et des requêtes attendues.
Cette méthode se situe entre les règles codées en dur et les modèles spécialisés. Les règles sont prévisibles, mais fragiles face aux formulations inattendues. Un modèle spécialisé peut être plus régulier sur un domaine précis, au prix de données d’entraînement et de maintenance. Le LLM est plus souple, mais ses extractions doivent être contrôlées.
La construction conditionne directement la fiabilité des réponses. Une relation mal extraite, une entité dupliquée ou un fait sorti de son contexte peut fausser tout le graphe. Je valide donc les types, les relations, les doublons et les sources sur un échantillon représentatif avant d’élargir le traitement. Sans cette étape, le graphe peut sembler cohérent tout en portant des erreurs difficiles à repérer.
Quels critères guident le choix de l’architecture ?
Je choisis selon quatre éléments : la complexité des questions, la dispersion des faits, le niveau de traçabilité attendu et le coût acceptable de construction et de maintenance. Si la réponse se trouve dans quelques passages, un RAG vectoriel suffit souvent. Si elle exige de relier des informations réparties entre plusieurs sources, le graphe devient plus pertinent.
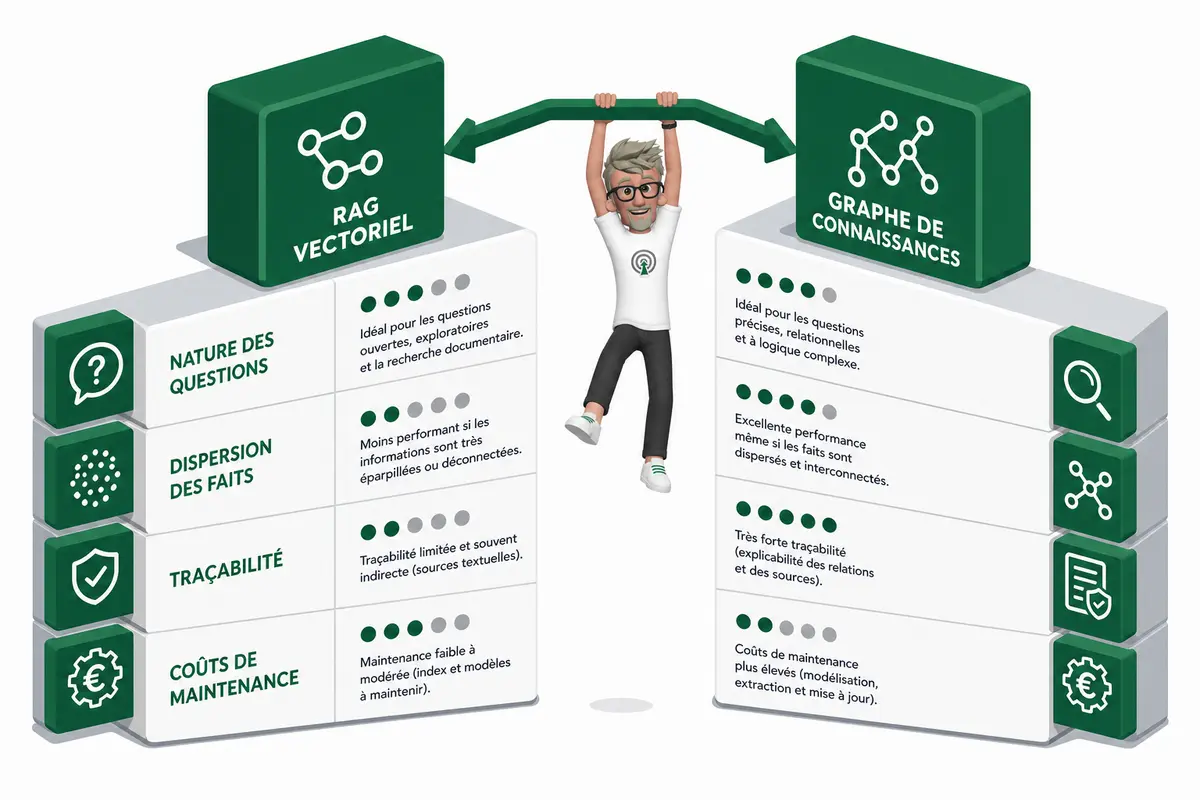
Le RAG vectoriel retrouve des passages proches de la question et les transmet au modèle. C’est une architecture plus simple à construire quand les faits utiles sont déjà regroupés dans les documents. Elle convient aux questions directes, dont la réponse tient dans un ou quelques extraits. Le modèle reçoit ces passages comme contexte : leur longueur et leur nombre influencent le volume de jetons, c’est-à-dire les unités de texte traitées par le modèle.
Un graphe représente les entités et les relations entre elles. Il est utile quand une réponse dépend d’un raisonnement en plusieurs étapes, par exemple pour relier un produit, un fournisseur et une contrainte décrits dans des sources différentes. Les liens du graphe rendent le chemin suivi plus explicite, ce qui peut faciliter la traçabilité. Mais il faut construire et maintenir cette représentation. Le contexte transmis au modèle peut être plus ciblé, sans être automatiquement plus court : les entités et les relations retenues doivent aussi être fournies au modèle.
En pratique, je privilégie le vectoriel pour limiter la complexité quand les réponses sont localisées. Je choisis le graphe quand les relations entre sources sont indispensables à la réponse et que leur coût de modélisation est acceptable. La traçabilité attendue peut aussi faire pencher la décision vers un graphe, sans rendre le RAG vectoriel inutilisable : les passages récupérés peuvent rester identifiables.
| Critère | RAG vectoriel | Graphe de connaissances |
| Nature des questions | Questions répondues dans quelques passages. | Questions nécessitant un raisonnement multi-étapes. |
| Relation entre sources | Faits plutôt localisés dans les documents. | Faits à relier entre plusieurs sources. |
| Traçabilité | Retour aux passages récupérés. | Relations et chemin de raisonnement plus explicites. |
| Coûts | Construction et maintenance généralement plus simples. | Construction et maintenance plus coûteuses. |
Quelle architecture sert vraiment vos usages ?
Le RAG vectoriel est le choix naturel quand quelques passages suffisent à répondre. Un graphe de connaissances prend l’avantage quand il faut relier des faits répartis entre plusieurs documents, suivre un raisonnement multi-étapes ou retracer les éléments utilisés. Ce choix implique un arbitrage concret : simplicité de mise en œuvre et de maintenance d’un côté, structuration, traçabilité et coût de construction du graphe de l’autre. Dans les deux cas, l’ancrage ne garantit pas l’exactitude : la qualité des données et de la récupération reste déterminante. Évaluez vos questions réelles avant de choisir. Vous éviterez une architecture trop lourde et transmettrez au modèle un contexte plus pertinent.
FAQ
- Quelle est la différence entre un RAG vectoriel et un GraphRAG ?
Le RAG vectoriel récupère des passages sémantiquement proches d’une question. Le GraphRAG s’appuie sur des entités et des relations structurées pour relier des faits et parcourir plusieurs sources. - Le RAG vectoriel peut-il répondre à une question complexe ?
Il fonctionne bien si la réponse est contenue dans quelques passages. Si les éléments sont dispersés entre plusieurs documents, des mécanismes supplémentaires peuvent être nécessaires pour les relier. - Un graphe de connaissances élimine-t-il les hallucinations ?
Non. Les informations externes fournissent un contexte stable et peuvent réduire les hallucinations, mais la fiabilité dépend de la qualité des données, de la construction du graphe et de la récupération. - Pourquoi utiliser un graphe pour le raisonnement multi-étapes ?
Les relations entre entités permettent de parcourir des faits connectés et de rapprocher des informations issues de plusieurs sources pour construire le contexte nécessaire à la réponse. - Quel type de RAG coûte le moins cher à maintenir ?
Le RAG vectoriel est souvent plus simple à construire et à maintenir. Un graphe peut mieux répondre aux besoins de raisonnement et de traçabilité, mais sa création et sa maintenance coûtent généralement davantage.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans la conception d’architectures data et de systèmes RAG adaptés à leurs données, à leurs besoins de traçabilité et à leurs contraintes de maintenance.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.