
IQuest-Q1 est un modèle open-weight de 320 milliards de paramètres conçu pour le codage agentique, dont environ 15 milliards sont activés par jeton. Architecture MoE, génération accélérée, intégration aux outils et limites : voici les points à évaluer avant de l’utiliser.
Qu’est-ce qu’IQuest-Q1 ?
IQuest-Q1 est un modèle open-weight conçu par IQuest pour le codage agentique, le raisonnement et l’utilisation d’outils en plusieurs étapes. Il compte environ 320 milliards de paramètres au total, dont environ 15 milliards sont activés pour chaque jeton traité. Sa fenêtre de contexte atteint 512 000 jetons, ce qui lui permet de traiter de très longs échanges ou des bases de code étendues dans un même contexte.
Son architecture à mélange d’experts, ou MoE pour « Mixture of Experts », répartit le traitement entre plusieurs sous-réseaux spécialisés. Pour chaque jeton, seule une partie de ces paramètres est activée. Le nombre total de paramètres décrit donc la capacité globale du modèle, tandis que les quelque 15 milliards activés par jeton indiquent la part mobilisée pour un traitement donné. Ces chiffres ne suffisent pas, à eux seuls, à décrire les performances ou les coûts réels d’utilisation.
Comment classer des textes en few-shot avec Scikit-LLM ?
IQuest-Q1 est compatible avec Claude Code et Codex CLI, deux outils en ligne de commande utilisés pour piloter des agents de développement. Cette compatibilité permet de l’intégrer à des workflows de programmation agentique, où le modèle peut contribuer à des tâches impliquant du code, du raisonnement et des appels d’outils successifs.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
IQuest présente également des évaluations comparatives de ses modèles, notamment IQuest-CLIBench. Ces évaluations donnent un cadre pour examiner leurs capacités sur des tâches liées au code et à l’usage d’outils. Les résultats chiffrés ne sont pas détaillés ici : leur interprétation dépend des tâches, des protocoles et des modèles comparés.
Pour comprendre ce que ces caractéristiques impliquent en pratique, il faut regarder les choix d’architecture qui structurent IQuest-Q1 : le fonctionnement du mélange d’experts, la gestion du contexte et la manière dont le modèle s’insère dans un flux agentique.
Comment son architecture MoE fonctionne-t-elle ?
Comment utiliser Gemini 4 Argon dans n8n ?
IQuest-Q1 répartit le calcul entre 256 experts, dont 8 sont activés à chaque passage. Son architecture combine ce mécanisme MoE — « Mixture of Experts », ou mélange d’experts — avec 88 couches de transformeurs, une dimension cachée de 3 072 et une attention groupée.
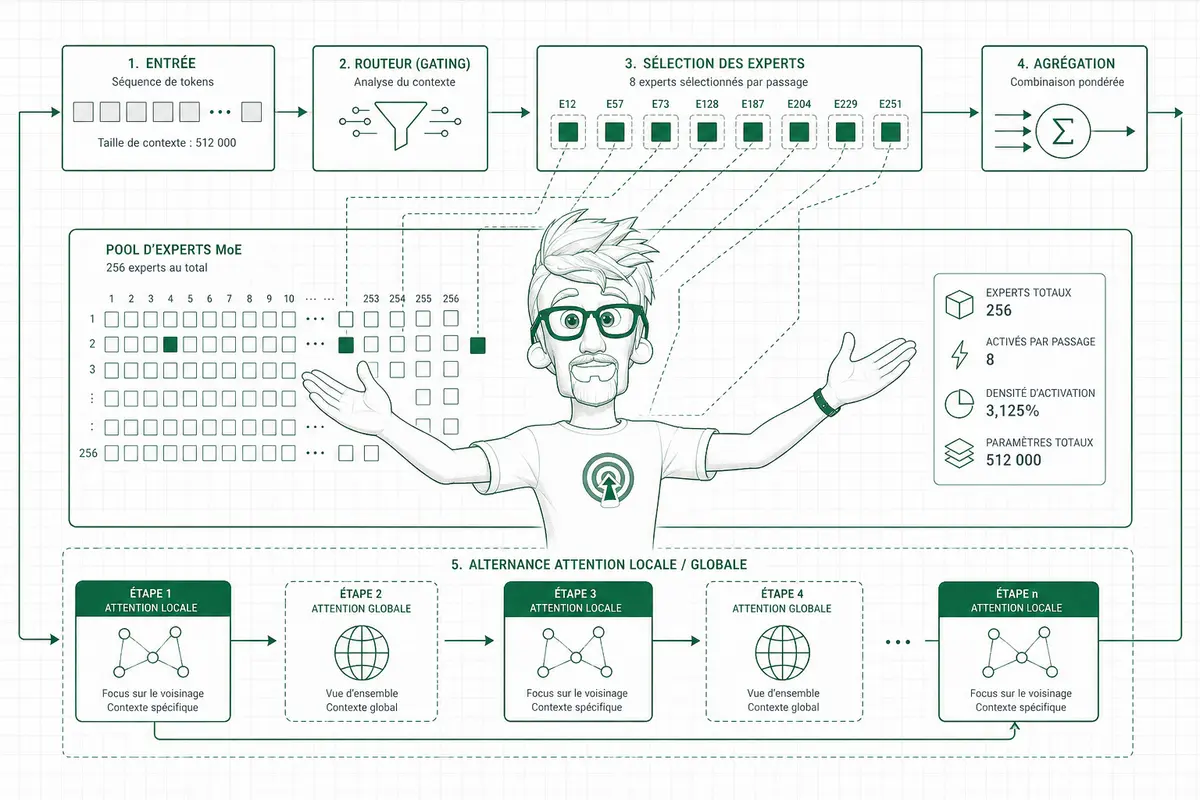
Les experts sont des composants spécialisés du modèle. À chaque passage, IQuest-Q1 en mobilise 8 parmi les 256 disponibles, plutôt que d’activer l’ensemble des experts. Le calcul est ainsi réparti sur une partie de l’architecture. Cette activation partielle réduit le calcul par rapport à l’activation de tous les paramètres, sans modifier le nombre total d’experts disponibles.
L’attention alterne entre trois couches à fenêtre glissante, puis une couche d’attention complète. Les couches à fenêtre glissante examinent une zone locale de 4 096 jetons. La couche complète traite, elle, le contexte global, dans la limite de contexte annoncée de 512 000 jetons. Cette alternance combine donc un traitement local répété et des accès au contexte global à intervalles réguliers.
Comment passer un prototype IA en production SaaS ?
Le modèle utilise aussi des embeddings positionnels rotatifs partiels. Ces représentations encodent l’ordre des jetons dans la séquence, mais ne s’appliquent qu’à 32 dimensions de chaque tête d’attention. Elles coexistent avec l’attention groupée et les différentes tailles de contexte traitées par les couches.
Lors de la génération, les couches transforment les représentations des jetons en tenant compte de l’attention locale ou globale, tandis que les experts activés contribuent au calcul. L’architecture produit ainsi les informations utilisées pour générer les jetons suivants. La fenêtre de 4 096 jetons définit la portée locale des couches glissantes ; les couches complètes peuvent exploiter le contexte global jusqu’à la limite annoncée de 512 000 jetons.
Comment la prédiction multi-jetons accélère-t-elle la génération ?
La prédiction multi-jetons vise à accélérer le décodage en anticipant plusieurs jetons futurs, plutôt qu’en produisant uniquement le jeton suivant à chaque étape. Son fonctionnement diffère entre l’entraînement et l’inférence.
Quand choisir un RAG vectoriel ou un graphe ?
À l’entraînement, IQuest-Q1 utilise deux couches indépendantes de prédiction multi-jetons, ou MTP pour Multi-Token Prediction. Chacune apprend à prédire des jetons situés plus loin dans la séquence. Cette supervision enrichit l’apprentissage du modèle, mais ne signifie pas que l’inférence génère directement plusieurs jetons sans vérification.
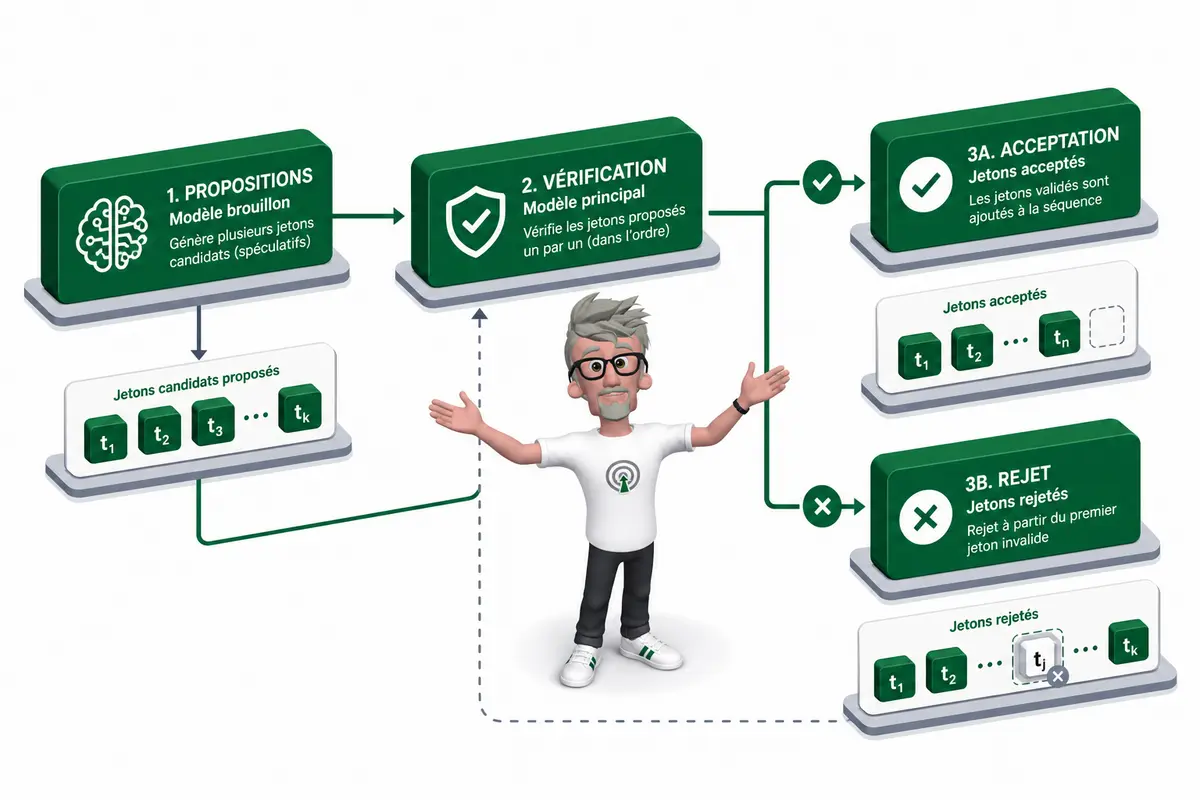
À l’inférence, la configuration récursive x8 exploite ces prédictions pour proposer des séquences de jetons candidates. Le processus s’appuie sur une fenêtre glissante de 512 jetons pour la décodification spéculative : le modèle brouillon produit des propositions, puis le modèle principal les vérifie. Cette vérification évite de sacrifier la cohérence du résultat à la vitesse.
Les configurations de déploiement pour SGLang et vLLM suivent une approche de type EAGLE. Elles associent un modèle brouillon MTP à un échantillonnage par rejet : les jetons proposés sont comparés aux sorties validées par le modèle principal, puis acceptés ou rejetés selon cette vérification. Le nombre de jetons effectivement conservés dépend du résultat de cette étape. Aucun facteur d’accélération chiffré n’est fourni ; je ne peux donc pas annoncer de gain garanti.
IQuest-Q1 peut être déployé avec SGLang et vLLM. Le choix de l’environnement et de sa configuration compte, notamment pour intégrer le décodage spéculatif à votre pile d’inférence.
La prédiction multi-jetons constitue donc un mécanisme d’optimisation, pas une garantie de débit. Pour évaluer son intérêt, il faut regarder les usages visés, les performances observées dans votre environnement et les limites du modèle.
Quels sont ses usages et ses limites ?
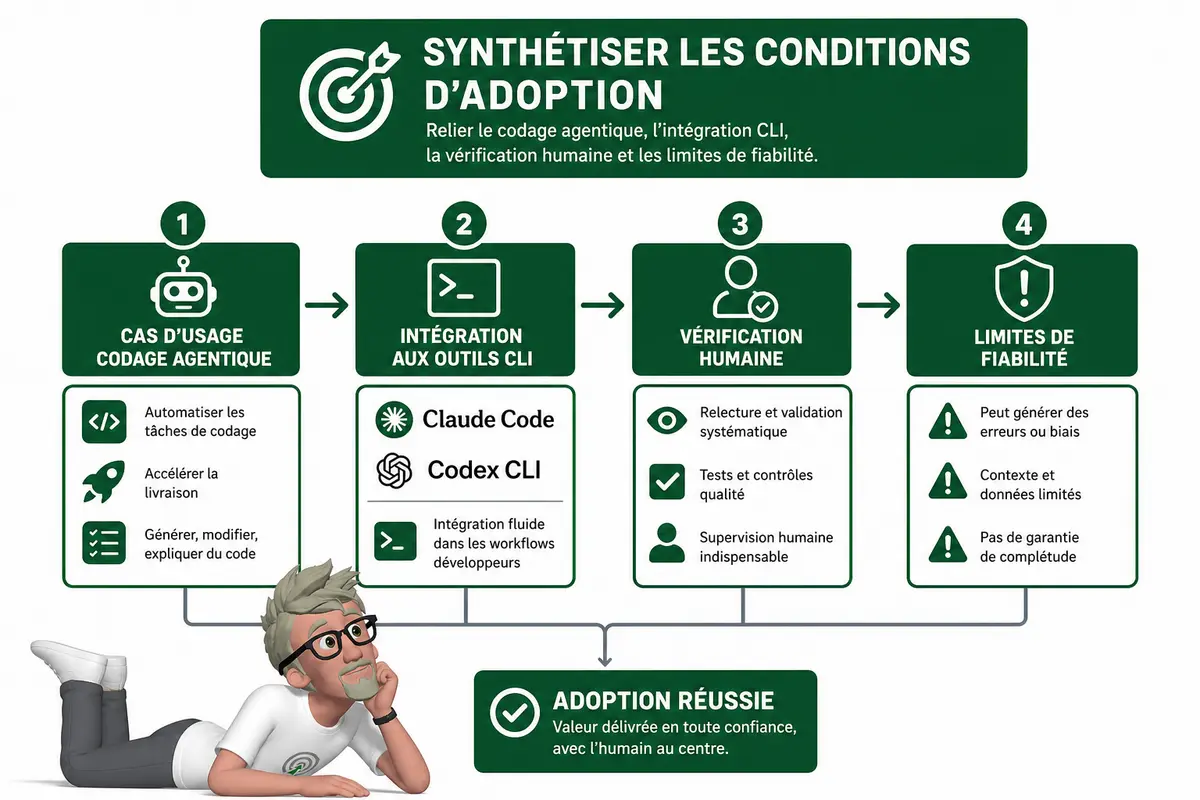
IQuest-Q1 cible le codage agentique et peut s’intégrer à Claude Code et Codex CLI. Son utilisation demande toutefois une supervision humaine : je ne le traiterais pas comme un agent autonome auquel confier des tâches sans contrôle.
IQuest présente plusieurs évaluations comparatives. Elles couvrent le codage agentique, Humanity’s Last Exam sans utilisation d’outils, ainsi qu’IQuest-CLIBench, son benchmark interne consacré à l’expérience des interfaces en ligne de commande (CLI). Les comparaisons incluent DeepSeek-V4-Flash, DeepSeek-V4-Pro et d’autres modèles orientés codage. Les résultats chiffrés ne sont pas disponibles ici ; je ne peux donc en déduire ni classement ni score.
Les limites à prendre en compte sont concrètes. Le modèle accepte exclusivement des entrées textuelles. Sur des tâches CLI réelles, ses résultats peuvent manquer de fiabilité, ce qui impose de vérifier les commandes et leurs effets. La supervision humaine reste nécessaire, notamment avant toute action susceptible de modifier un environnement ou des données.
Je le retiendrais selon quatre critères :
- Votre usage porte-t-il réellement sur le codage agentique, plutôt que sur une assistance générale au développement ?
- Son intégration à Claude Code ou Codex CLI correspond-elle à vos outils et à votre environnement ?
- Votre workflow dépend-il d’un contexte long ? Les éléments disponibles ici ne précisent pas la capacité de contexte à retenir.
- Votre équipe peut-elle contrôler les propositions et les résultats, au lieu d’attendre une exécution fiable sans intervention ?
Si le codage agentique et l’intégration aux outils sont prioritaires, IQuest-Q1 mérite une évaluation dans votre propre environnement. Si vous exigez des résultats CLI fiables sans contrôle humain, les limites signalées constituent un frein.
Que retenir avant de l’adopter ?
IQuest-Q1 combine une architecture MoE de 320 milliards de paramètres, dont environ 15 milliards sont activés par jeton, avec 512 000 jetons de contexte et une conception orientée codage agentique. Son attention hybride et sa prédiction multi-jetons structurent le modèle, tandis que SGLang et vLLM offrent des options de déploiement. Il s’intègre aussi à Claude Code et Codex CLI. Les évaluations couvrent plusieurs usages, mais les résultats chiffrés ne permettent pas ici d’établir un classement. Enfin, ses entrées exclusivement textuelles et la fiabilité parfois limitée sur des tâches CLI réelles imposent une supervision humaine. Évaluez-le sur vos tâches concrètes : vous pourrez mesurer son adéquation sans confondre capacité annoncée et résultat opérationnel.
FAQ
-
Qu’est-ce qu’IQuest-Q1 ?
IQuest-Q1 est un modèle open-weight conçu pour le codage agentique, le raisonnement et l’utilisation d’outils en plusieurs étapes. Il compte environ 320 milliards de paramètres, dont environ 15 milliards sont activés par jeton. -
Quelle est la fenêtre de contexte d’IQuest-Q1 ?
Sa fenêtre de contexte atteint 512 000 jetons. -
Combien d’experts sont activés par jeton ?
L’architecture comporte 256 experts et en active 8 à chaque passage. -
Avec quels outils IQuest-Q1 peut-il être utilisé ?
Il peut s’intégrer à Claude Code et Codex CLI. Pour le déploiement, les configurations mentionnées incluent SGLang et vLLM. -
Quelles limites faut-il prendre en compte ?
Les entrées sont exclusivement textuelles, les résultats peuvent être peu fiables sur des tâches CLI réelles et une supervision humaine est recommandée.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans l’évaluation et la mise en œuvre de solutions data et IA, avec une attention particulière portée à leur intégration dans les workflows et à la fiabilité des résultats.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.