


La bonne alternative dépend surtout de votre usage : chat simple, documents, agents ou déploiement d’équipe. Je vous montre comment choisir une IA locale open source, quoi installer, et où Open WebUI, Jan, AnythingLLM, LibreChat ou llama.cpp font vraiment la différence.
Pourquoi lancer ChatGPT en local ?
Réponse directe : Je lance une IA en local quand je veux garder la main sur mes données, mon coût, mes modèles et mes intégrations.
Le vrai intérêt, ce n’est pas de “faire comme ChatGPT sans Internet”. C’est surtout de décider où passent les données, qui voit les logs, quel modèle répond, et comment l’outil s’intègre à votre système interne.
Comment créer un agent IA Python sans tout réécrire ?
Une IA locale peut tourner sur votre machine, sur un serveur privé, ou dans votre cloud interne. Vous gagnez en confidentialité, en contrôle de l’infrastructure, et vous évitez une dépendance totale à un fournisseur unique. Selon la configuration, vous pouvez aussi travailler hors ligne. Pratique pour certains contextes sensibles, industriels, juridiques, santé, ou juste pour des équipes qui ne veulent pas envoyer leurs documents partout.
Je nuance quand même. Une IA locale n’est pas automatiquement meilleure qu’un service cloud. La qualité dépend du modèle, du matériel, de la mémoire disponible, de la quantification, c’est-à-dire la compression du modèle pour le faire tourner plus léger, et de l’interface utilisée. Un petit modèle local peut être rapide mais moins bon en raisonnement. Un gros modèle peut être meilleur mais lent si la machine ne suit pas.
Les briques à connaître sont assez simples :
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
- Les modèles GGUF sont des fichiers optimisés pour faire tourner des LLM en local.
- Le moteur llama.cpp exécute ces modèles sur CPU ou GPU, sans usine à gaz.
- Ollama simplifie le téléchargement, le lancement et l’exposition des modèles en API locale.
- Docker aide à déployer des interfaces comme Open WebUI ou LibreChat proprement.
- Les API compatibles OpenAI permettent de brancher vos outils sur un backend local sans tout réécrire.
Comment créer un AI Data Analyst fiable en Python ?
J’ai souvent vu chez des clients une confusion entre IA locale et IA privée. Si votre interface “locale” appelle une API cloud derrière, vos données quittent quand même votre environnement. C’est le premier point que je vérifie.
Pour tester vite, Ollama suffit. Ces commandes installent l’outil, téléchargent un modèle léger, le lancent, puis testent l’API HTTP locale.
curl -fsSL https://ollama.com/install.sh | sh

ollama pull llama3.2

ollama run llama3.2

curl http://localhost:11434/api/generate
  -d '{"model":"llama3.2","prompt":"Explique Docker en une phrase","stream":false}'
Le dernier appel envoie un petit JSON à Ollama. Le principe est simple : on indique le modèle, le prompt, et si on veut une réponse en flux ou non.
| Usage | Outil utile | Niveau technique | Point de vigilance |
| Chat local simple | Ollama | Faible | Choisir un modèle adapté à la machine |
| Documents internes | Open WebUI | Moyen | Vérifier où sont stockés les fichiers |
| Agents | LibreChat | Moyen à élevé | Limiter les actions autorisées |
| Équipe | Docker | Moyen | Gérer les accès et les logs |
| Interface légère sur serveur existant | llama.cpp | Moyen | Surveiller CPU, RAM et latence |
Quel outil choisir pour chatter en local ?
Comment utiliser le reflection pattern en production ?
Réponse directe : Pour chatter en local sans me compliquer la vie, je regarde d’abord Open WebUI, Jan, llama.cpp WebUI et LobeHub. Ce ne sont pas exactement les mêmes outils. Certains remplacent presque ChatGPT côté interface, d’autres servent surtout à lancer vite un modèle local et discuter avec.
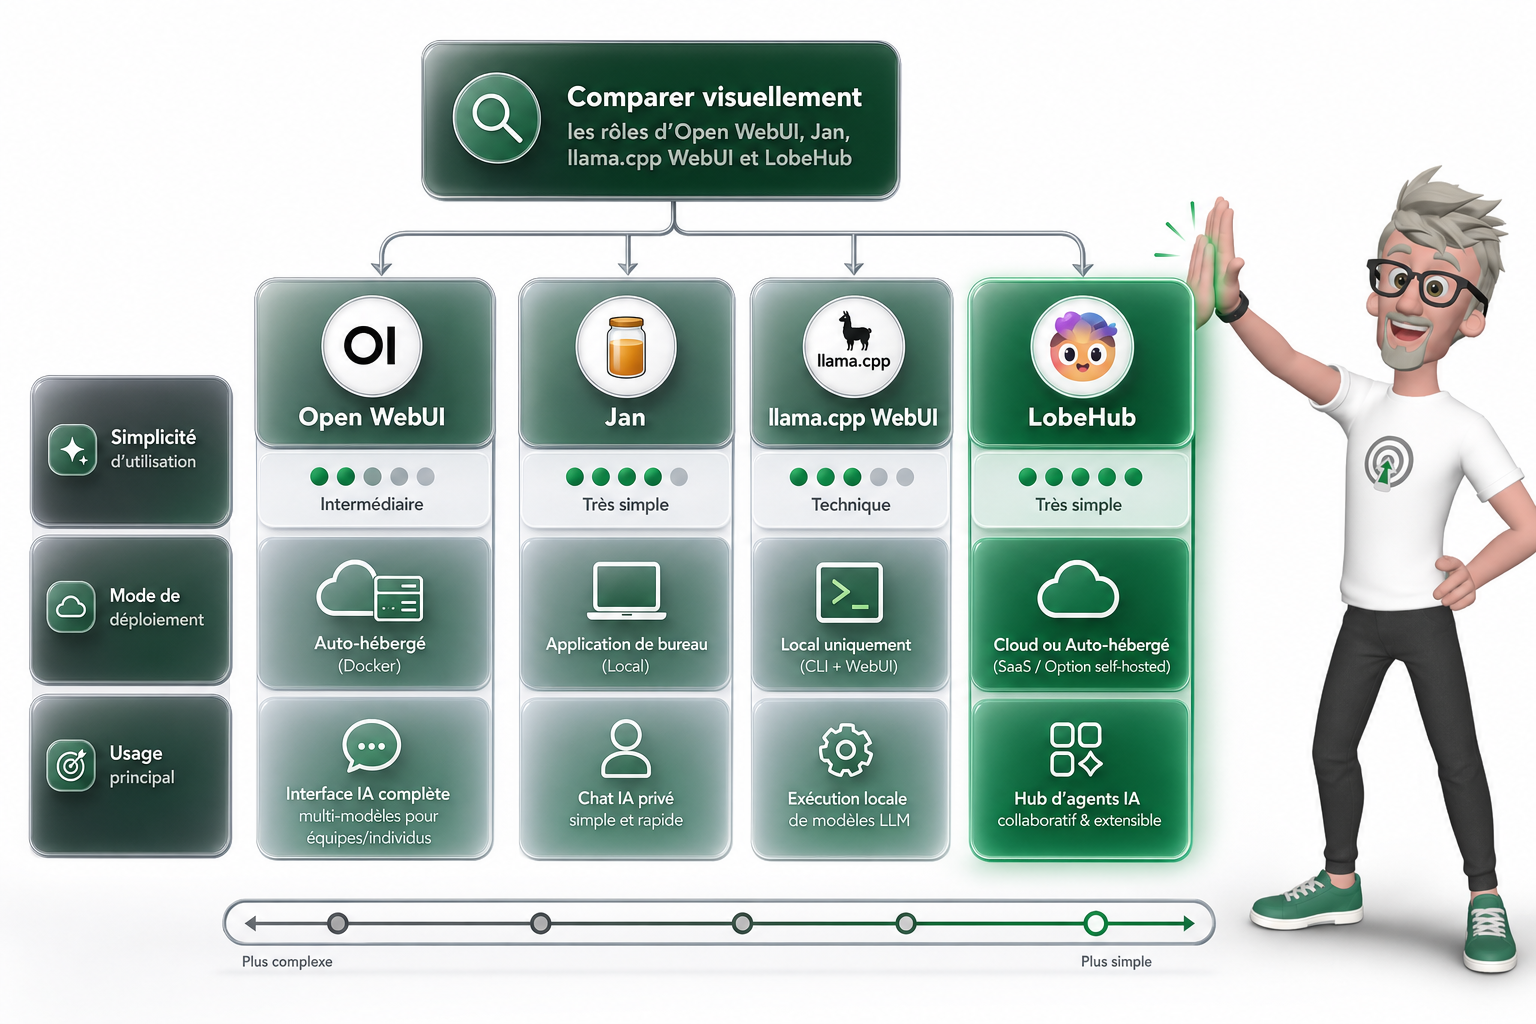
Open WebUI, c’est souvent mon premier choix quand je veux quelque chose de propre. L’interface ressemble à ce qu’on attend aujourd’hui : conversations, plusieurs modèles, gestion des utilisateurs, réglages, logique d’administration. On peut l’installer avec Docker ou Python, et le connecter à Ollama, llama.cpp, ou à une API compatible OpenAI. Une API compatible OpenAI, ça veut juste dire qu’un outil expose les mêmes routes que l’API d’OpenAI, donc beaucoup d’interfaces savent lui parler sans adaptation lourde.
Jan, je le vois comme l’option desktop la plus simple. Vous installez l’app, vous choisissez un modèle, vous testez. Pas besoin de monter une stack Docker, pas besoin d’être dev. Ça parle bien aux indépendants, consultants, équipes produit, ou aux gens curieux qui veulent garder une partie du traitement sur leur machine. J’ai vu des clients l’adopter juste pour valider un usage interne avant de parler infrastructure.
Comment créer un workflow multi-agent avec Copilot Studio ?
Llama.cpp WebUI est plus léger. Il colle directement à llama.cpp, le moteur C/C++ très populaire pour exécuter des modèles locaux au format GGUF. GGUF, c’est un format de fichier optimisé pour faire tourner des modèles sur votre machine. Vous chargez un modèle, vous discutez dans le navigateur. Les points forts sont clairs : peu de couches, streaming, historique, réglages du modèle, parfois pièces jointes selon la configuration. La limite aussi : c’est moins un vrai espace de travail IA qu’un Open WebUI ou LibreChat.
LobeHub est plus soigné côté expérience. Son intérêt, pour moi, c’est la création d’assistants spécialisés et la personnalisation. On peut construire quelque chose de plus agréable qu’un simple chat brut, avec une logique qui peut évoluer vers un espace de travail IA plus riche. Je reste prudent : je ne le choisirais pas juste parce que c’est joli, mais quand l’expérience utilisateur compte, il mérite d’être testé.
Pour lancer Open WebUI avec Ollama déjà installé sur votre machine, je garde Ollama actif sur le port 11434, puis je démarre Open WebUI en Docker sur le port 3000.
Commande : docker run -d -p 3000:8080 -e OLLAMA_BASE_URL=http://host.docker.internal:11434 -v open-webui:/app/backend/data –name open-webui –restart always ghcr.io/open-webui/open-webui:main
Sur Linux, host.docker.internal peut ne pas exister selon votre environnement Docker. Dans ce cas, j’ajoute une option add-host pour pointer vers la machine hôte.
Variante Linux : docker run -d -p 3000:8080 –add-host=host.docker.internal:host-gateway -e OLLAMA_BASE_URL=http://host.docker.internal:11434 -v open-webui:/app/backend/data –name open-webui –restart always ghcr.io/open-webui/open-webui:main
| Outil | Meilleur usage | Installation | Backend supporté | Mon avis rapide |
| Open WebUI | Alternative locale proche de ChatGPT | Docker ou Python | Ollama, llama.cpp, API compatible OpenAI | Mon choix par défaut si je veux du solide |
| Jan | Démarrer vite en desktop | Application locale | Modèles locaux selon configuration | Très bon pour tester sans friction |
| llama.cpp WebUI | Chat léger avec modèles GGUF | Léger, lié à llama.cpp | llama.cpp | Efficace, mais moins workspace complet |
| LobeHub | Assistants personnalisés et UX propre | Variable selon déploiement | Selon configuration et providers | Intéressant si l’expérience compte |
Quel outil utiliser avec vos documents ?
Réponse directe : Pour interroger des documents, je pars plutôt sur AnythingLLM, et je vérifie toujours la chaîne d’ingestion avant de parler de RAG ou d’agent. Le RAG, c’est juste une méthode pour retrouver les bons passages dans vos documents, puis les donner au modèle pour qu’il réponde avec ce contexte. Ce n’est pas magique.
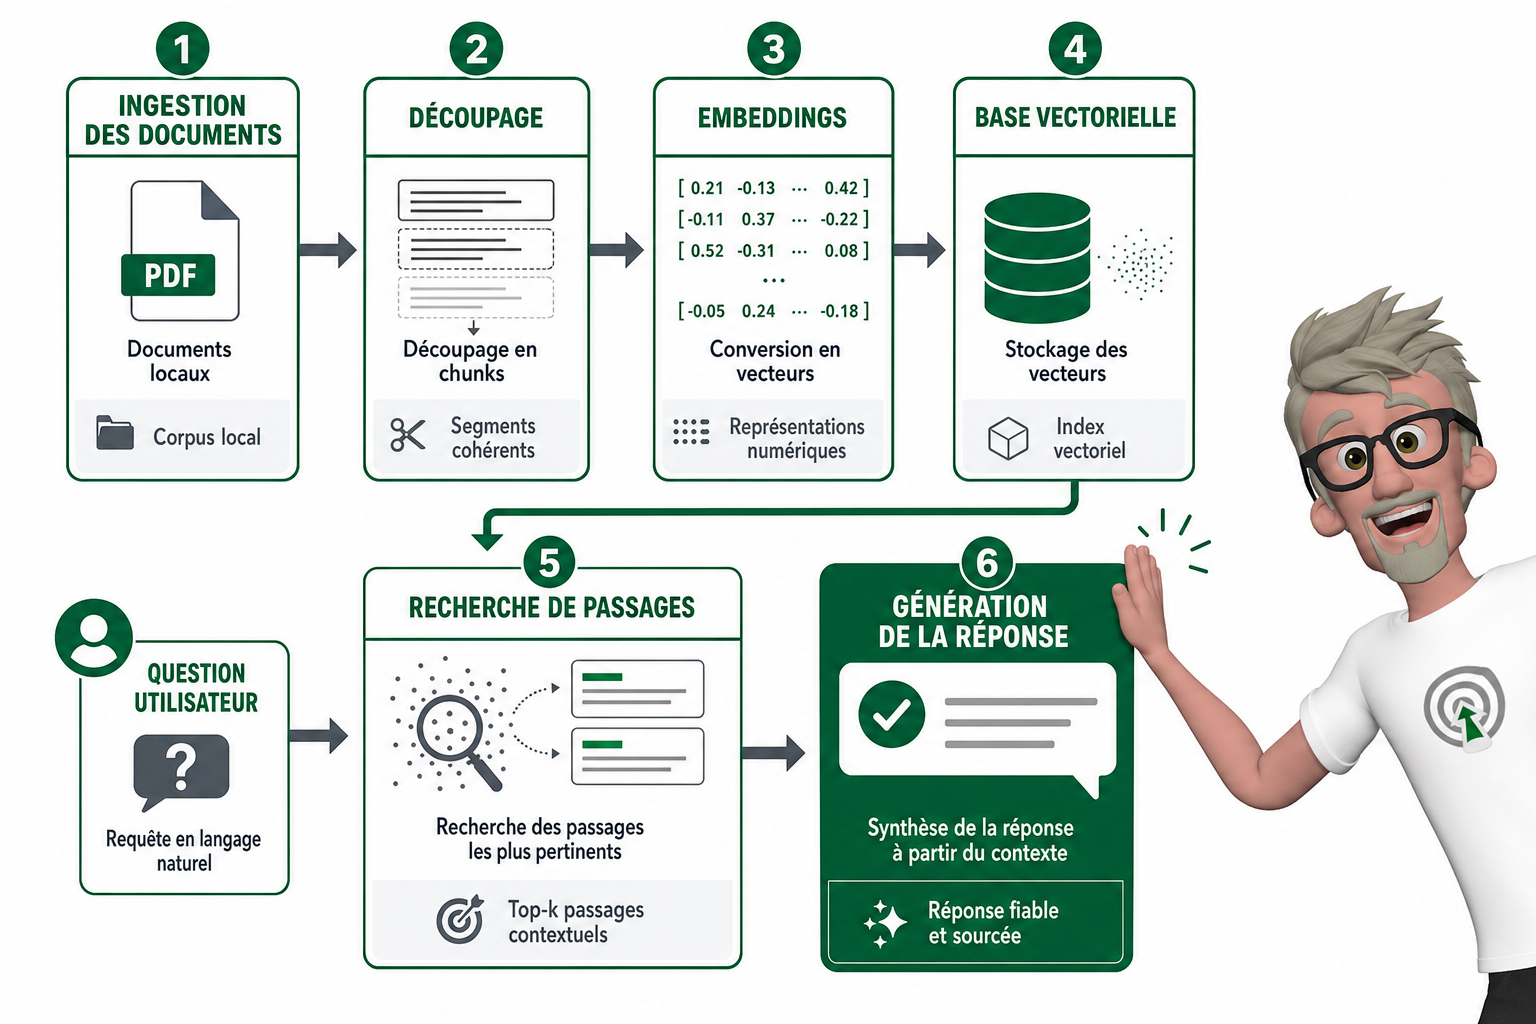
Ce qu’on cherche vraiment, c’est simple : vous déposez ou connectez des fichiers, l’outil les découpe en morceaux, crée des embeddings, c’est-à-dire des représentations numériques du sens du texte, puis stocke tout ça dans une base vectorielle. Ensuite, quand vous posez une question, l’outil retrouve les morceaux les plus proches et les injecte dans la réponse.
AnythingLLM est bien adapté à ça parce qu’il pense “base documentaire” avant de penser “simple chat”. Vous pouvez créer des workspaces, séparer les documents par équipe, client ou projet, gérer l’ingestion, connecter une base vectorielle, brancher Ollama, ajouter des agents et garder un contexte propre par espace. En entreprise, c’est important. Sinon, tout finit dans un grand sac, et personne ne sait pourquoi le modèle mélange le contrat d’un client avec la procédure RH.
Chez un client, le problème n’était pas le modèle. C’était les PDF mal structurés, les doublons, les versions contradictoires et des droits d’accès flous. Le modèle répondait “mal” parce qu’on lui donnait une base sale. Ça arrive souvent.
| Besoin | Outil adapté |
| Quelques fichiers dans une conversation | Open WebUI ou LobeHub suffisent souvent |
| Base documentaire durable | AnythingLLM est plus cohérent |
| Séparation par équipe ou client | Workspaces AnythingLLM |
Voici un exemple local minimal. Ollama fait tourner le modèle, AnythingLLM sert d’interface et orchestre les documents. La base vectorielle peut être intégrée ou configurée selon votre déploiement. Les variables changent parfois selon les versions, donc je vérifie toujours la documentation officielle avant une mise en production.
version: "3.9"

services:
  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    volumes:
      - ollama_data:/root/.ollama
    ports:
      - "11434:11434"

  anythingllm:
    image: mintplexlabs/anythingllm:latest
    container_name: anythingllm
    depends_on:
      - ollama
    ports:
      - "3001:3001"
    volumes:
      - anythingllm_data:/app/server/storage
    environment:
      # A vérifier dans la documentation officielle selon la version
      - LLM_PROVIDER=ollama
      - OLLAMA_BASE_PATH=http://ollama:11434

volumes:
  ollama_data:
  anythingllm_data:
Avant de mettre ça entre les mains d’une équipe, je contrôle toujours quelques points très terre à terre :
- Nettoyer les documents, supprimer les doublons et les versions obsolètes.
- Définir une convention de nommage claire.
- Séparer les workspaces par équipe, client ou projet.
- Tester les réponses avec citations ou contexte source.
- Contrôler les droits d’accès avant l’ingestion.
- Surveiller les coûts si un modèle cloud est branché.
- Sauvegarder les volumes persistants.
Quel outil choisir pour les agents et équipes ?
Réponse directe : Pour des agents, des équipes et des workflows plus avancés, LibreChat devient très intéressant. Je le vois comme une vraie alternative open source à ChatGPT quand on veut centraliser l’accès aux modèles, connecter plusieurs fournisseurs, garder une interface commune et commencer à brancher des actions métier.
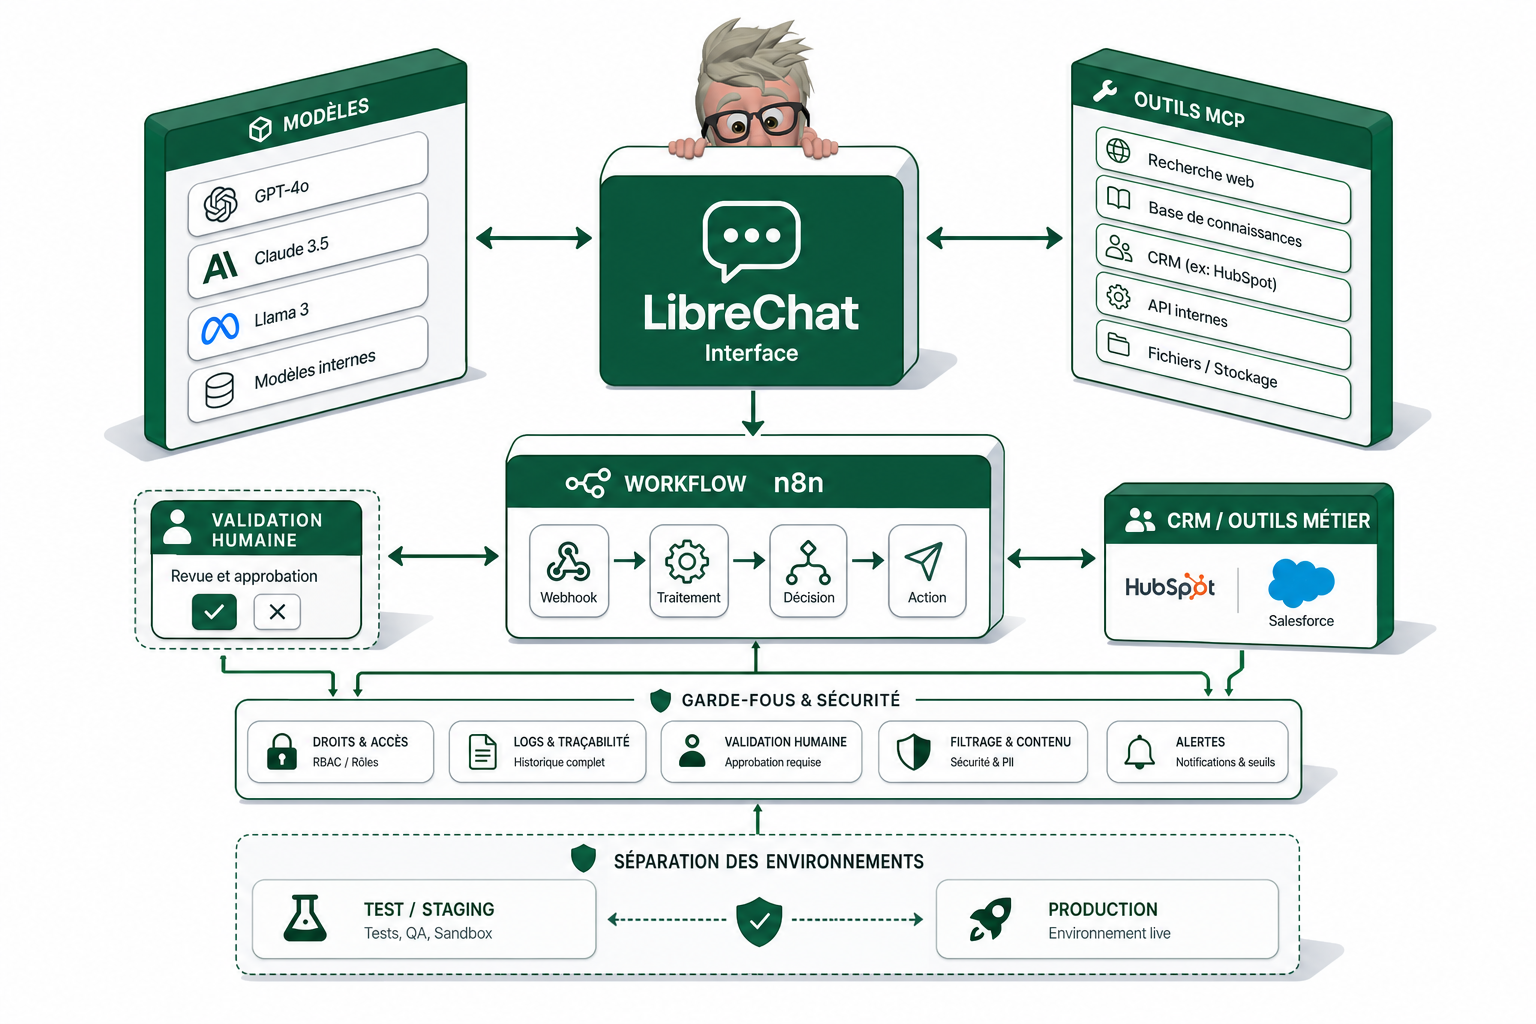
LibreChat va plus loin qu’une simple app desktop. On retrouve les conversations, la recherche, les agents, les actions personnalisées, parfois l’exécution de code selon la configuration, le support de plusieurs fournisseurs de modèles, et la compatibilité avec des API de type OpenAI. Ça veut dire qu’on peut connecter OpenAI, Azure OpenAI, Anthropic, des modèles locaux exposés via une API compatible, ou d’autres providers selon le setup.
Il peut aussi s’intégrer à des approches plus avancées comme MCP, quand l’environnement le permet. MCP, pour faire simple, c’est un protocole qui aide un assistant IA à se connecter à des outils, des fichiers, des bases de données ou des contextes externes de manière plus standardisée. C’est puissant, mais ce n’est pas un bouton magique. Il faut de la gouvernance, des droits bien posés, et des tests sérieux.
Je choisirais LibreChat dans ces cas-là :
- Vous avez une équipe qui veut accéder aux modèles depuis un point central.
- Vous voulez tester plusieurs providers sans changer d’interface toutes les semaines.
- Vous voulez créer des assistants internes avec des rôles précis.
- Vous avez besoin d’un historique exploitable et partagé selon les droits.
- Vous voulez connecter des actions business via API, webhook ou actions personnalisées.
La contrepartie est simple. C’est plus lourd à installer et à maintenir qu’un Jan ou qu’un llama.cpp WebUI. Il faut penser serveur, configuration, clés API, mises à jour, logs, sécurité. Pour un usage perso, c’est parfois trop. Pour une équipe, ça commence à avoir beaucoup de sens.
Côté automatisation low code, le scénario classique c’est une interface IA qui appelle un workflow n8n via webhook. Par exemple, un agent reçoit une question, qualifie l’intention, appelle n8n, récupère une réponse structurée, puis répond à l’utilisateur.
Voici un payload JSON simple que l’agent pourrait envoyer à n8n pour résumer un ticket ou enrichir une fiche CRM :
{
  "user_id": "u_123",
  "intent": "summarize_ticket",
  "ticket_id": "TCK-4582",
  "message": "Le client demande un suivi sur sa facture et signale une erreur de montant.",
  "priority": "normal"
}
Et côté n8n, on peut imaginer une route webhook comme celle-ci, appelée par l’action personnalisée ou par une API intermédiaire :
POST https://automation.votre-domaine.com/webhook/ai-agent-ticketN8n peut ensuite lire le ticket, appeler le CRM, vérifier une règle interne, générer une réponse structurée, puis renvoyer quelque chose comme un résumé, une catégorie, une priorité et une proposition de réponse.
Dernier point, et il est important. Agents ne veut pas dire autonomie totale. Il faut journaliser les appels, limiter les droits, tester les actions, prévoir une validation humaine pour les opérations sensibles, et séparer clairement l’environnement de test de la production. J’ai vu des équipes gagner beaucoup de temps avec ça, mais seulement quand les garde-fous étaient posés dès le départ.
Comment faire le bon choix ?
Réponse directe : Je choisis l’outil selon le cas d’usage, pas selon la popularité GitHub ou la dernière démo qui tourne sur LinkedIn. C’est souvent là que les mauvais choix commencent.
Si je résume simplement, Open WebUI est mon choix pour une expérience ChatGPT locale solide, surtout avec Ollama ou un backend compatible OpenAI. La complexité est moyenne, le vrai point d’attention c’est l’exploitation serveur et les accès utilisateurs.
Jan est parfait pour tester vite sur desktop. C’est simple, propre, rassurant. Par contre, dès qu’on veut industrialiser ou partager avec une équipe, on atteint vite ses limites.
Llama.cpp WebUI sert quand je veux charger directement des modèles GGUF avec peu de couches autour. GGUF, c’est un format optimisé pour faire tourner des modèles localement, souvent quantifiés, donc plus légers. C’est très contrôlable, mais plus technique.
LobeHub est très bon pour créer des assistants propres, bien organisés, avec une belle expérience utilisateur. AnythingLLM est le choix naturel quand le besoin principal est d’interroger des documents, avec du RAG, c’est-à-dire de la recherche dans vos fichiers avant génération de réponse. LibreChat vise plutôt la plateforme d’équipe avancée, multi-modèles, plus proche d’un vrai produit interne. Hugging Face Chat UI, lui, est une interface légère et propre. Je le prends surtout si j’ai déjà un serveur d’inférence local ou une API compatible OpenAI. Sans backend déjà prêt, ce n’est pas le plus simple pour débuter.
| Besoin | Recommandation | Pourquoi | Attention |
| Tester vite | Jan | Installation simple, usage desktop immédiat | Moins adapté à une équipe |
| Expérience ChatGPT locale | Open WebUI | Très bon équilibre entre confort et contrôle | Demande un minimum d’admin serveur |
| Charger du GGUF directement | Llama.cpp WebUI | Peu de couches, bon contrôle local | Plus technique |
| Créer des assistants propres | LobeHub | Interface soignée, logique d’agents claire | Attention aux dépendances API |
| Interroger des documents | AnythingLLM | Bon pour le RAG et les bases documentaires | La qualité dépend des documents et du découpage |
| Plateforme d’équipe avancée | LibreChat | Multi-utilisateurs, multi-modèles, plus complet | Plus lourd à maintenir |
| Backend d’inférence déjà prêt | Hugging Face Chat UI | Interface fine au-dessus d’une infra existante | Pas idéal sans backend |
Le compromis est toujours le même. Simplicité contre contrôle. Local pur contre API externe. Desktop contre serveur. Chat simple contre base documentaire. Prototype contre production. Chez un client, on avait commencé avec un outil trop complet. On est revenus à Jan pour cadrer l’usage, puis Open WebUI quand le besoin équipe est devenu réel.
Côté matériel, je reste prudent. Un petit modèle quantifié peut tourner sur une machine modeste. Les gros modèles demandent plus de RAM ou de VRAM, la mémoire de la carte graphique. Je conseille de commencer petit, mesurer la latence, puis changer de modèle ou de machine seulement si le cas d’usage le justifie.
Alors, vous partez sur quel setup local ?
Je ne cherche pas la meilleure alternative open source à ChatGPT dans l’absolu. Je cherche celle qui colle à votre usage. Pour discuter vite, Jan ou Open WebUI font très bien le job. Pour du GGUF léger, llama.cpp WebUI reste très direct. Pour les documents, AnythingLLM est plus logique. Pour une équipe avec agents, fournisseurs multiples et actions, LibreChat devient sérieux. Hugging Face Chat UI est intéressant si vous avez déjà une infra d’inférence. Le vrai bénéfice pour vous, c’est simple : garder plus de contrôle sur vos données, vos coûts et vos workflows IA.
FAQ
- Quelle est la meilleure alternative open source à ChatGPT en local ?
Pour un usage général, je commencerais par Open WebUI avec Ollama. C’est propre, assez simple à déployer, et proche de l’expérience ChatGPT. Si vous voulez juste tester sans toucher à Docker, Jan est souvent plus rapide. - Est-ce qu’une IA locale garantit la confidentialité ?
Pas automatiquement. Si le modèle tourne vraiment sur votre machine ou votre serveur, vous gardez plus de contrôle. Si l’interface locale appelle une API cloud, vos données peuvent sortir. C’est le premier point à vérifier. - Quel outil utiliser pour interroger des PDF et documents internes ?
AnythingLLM est un très bon candidat pour ça. Il est pensé pour les bases de connaissances, l’ingestion documentaire, les espaces de travail et les usages RAG. Mais la qualité dépend beaucoup de vos documents et de leur structuration. - Faut-il un gros GPU pour faire tourner une IA en local ?
Pas forcément pour démarrer. Des modèles quantifiés plus petits peuvent tourner sur des machines modestes, parfois même sur CPU. Pour des modèles plus gros et une meilleure vitesse, la RAM et surtout la VRAM deviennent vite importantes. - LibreChat est-il adapté à une entreprise ?
Oui, surtout si vous voulez une interface multi-modèles, des agents, des actions personnalisées et un usage plus avancé en équipe. Il demande plus de mise en place qu’une application desktop, mais il est plus cohérent pour un déploiement structuré.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent passer de la démo IA sympa à des systèmes vraiment utilisables, gouvernés et connectés au business. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer ou déployer une stack IA locale, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.