


Cinq conteneurs Docker donnent accès en local à des outils pour inspecter des données, les transformer, convertir des fichiers, tester des API et générer des diagrammes. Je détaille leur usage, leur intérêt pour garder les données sur votre machine et les précautions à prendre avant de les intégrer à votre environnement.
À quoi servent ces cinq conteneurs Docker ?
Ces cinq conteneurs hébergent localement des outils de développement pour inspecter des données, enchaîner des transformations, convertir des fichiers, tester des API et produire des diagrammes : IT-Tools, CyberChef, ConvertX, Hoppscotch CE et Kroki. Leur intérêt commun est de limiter l’envoi de vos données vers des sites tiers, à condition d’utiliser votre instance locale et de vérifier où les traitements sont réellement exécutés.
IT-Tools rassemble des utilitaires courants pour manipuler ou examiner des données. CyberChef permet d’enchaîner des opérations sur du texte ou des données, sous forme de recettes. ConvertX sert à convertir des fichiers entre différents formats. Hoppscotch CE permet de préparer et d’exécuter des requêtes vers des API. Kroki génère des diagrammes à partir de descriptions textuelles.
Comment les tests de contrat d’API évitent-ils les pannes ?
Héberger ces outils chez vous améliore la maîtrise de l’emplacement des traitements. Ça ne garantit pas, à lui seul, la confidentialité ni la sécurité des données. Une instance mal protégée peut être accessible à d’autres personnes. Un fichier importé peut contenir un logiciel malveillant ou exploiter une faille dans un composant qui le traite. Et une requête envoyée depuis Hoppscotch peut toujours viser un service externe. Le traitement local réduit certains transferts ; il ne rend pas fiables les fichiers, les textes ou les destinations manipulés.
| Outil | Usage | Avantage local | Précaution principale |
| IT-Tools | Utilitaires pour inspecter et manipuler des données. | Éviter de confier les valeurs saisies à un site tiers. | Ne collez pas de secrets sans vérifier les accès à l’instance. |
| CyberChef | Enchaîner des transformations sur des données. | Traiter localement des contenus sensibles. | Vérifiez les recettes et ne considérez pas le résultat comme sûr par défaut. |
| ConvertX | Convertir des fichiers. | Garder les fichiers sur votre propre infrastructure. | Les fichiers restent des entrées non fiables à traiter. |
| Hoppscotch CE | Tester des API avec des requêtes. | Maîtriser où sont saisis les paramètres et identifiants. | Vérifiez la destination des requêtes et protégez les jetons d’accès. |
| Kroki | Générer des diagrammes depuis du texte. | Éviter d’envoyer des descriptions d’architecture à un service tiers. | Évitez d’y inclure des informations sensibles si l’instance est partagée. |
Quand utiliser IT-Tools ?
IT-Tools regroupe des utilitaires pratiques pour les opérations de dépannage du quotidien. En local, je l’ajoute comme boîte à outils complémentaire à l’environnement Docker, sans le confondre avec un service nécessaire au fonctionnement de l’application.
Sa place est à côté des conteneurs dédiés à l’exécution de l’application ou à ses dépendances. Ceux-ci répondent à un besoin précis de la stack ; IT-Tools sert plutôt de point d’appui ponctuel quand une opération courante demande un utilitaire. Je le démarre si cet usage est utile à l’équipe, et je l’écarte si le poste n’en a pas besoin. Ce n’est pas une brique applicative à intégrer par défaut.
Quels assistants de programmation IA choisir ?
Je garde aussi une frontière nette sur les usages sensibles. IT-Tools ne doit pas servir de coffre-fort pour des secrets : mots de passe, clés API et jetons d’accès doivent rester dans un gestionnaire adapté ou dans le mécanisme de gestion des secrets prévu par l’environnement. Ce n’est pas non plus une suite de tests. La validation du code et des comportements doit rester dans les outils et processus de test du projet.
En pratique, je le considère comme un conteneur d’appoint, pas comme une dépendance critique. Cette distinction évite de lui confier des données sensibles ou des responsabilités qu’il n’a pas vocation à porter.
- Usages adaptés : accéder à des utilitaires pratiques lors d’opérations de dépannage courantes en environnement local.
- Usages à éviter : stocker des secrets, exécuter ou remplacer une suite de tests, ou en faire une dépendance obligatoire de l’application.
Comment exploiter les recettes CyberChef ?
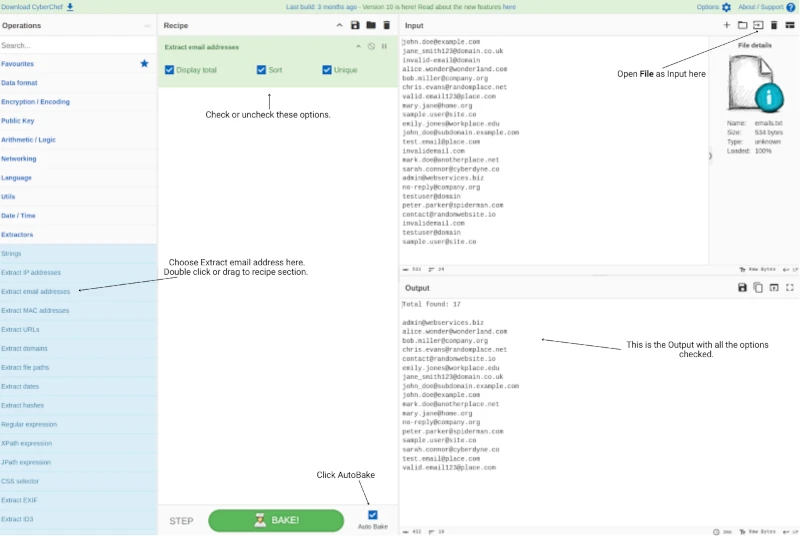
CyberChef permet d’enchaîner des opérations de décodage et de transformation dans des recettes réutilisables. Dans une instance exécutée localement, je peux examiner des données et les convertir sans les transmettre à un service externe, selon la configuration retenue.
Quels scripts Python pour automatiser vos CSV ?
Une recette formalise un traitement : plusieurs étapes s’appliquent dans un ordre défini, puis peuvent être réutilisées sur d’autres données. C’est pratique pour analyser des contenus encodés, normaliser des formats ou préparer des données avant leur examen. La recette rend le traitement visible et reproductible, ce qui facilite aussi la comparaison entre l’entrée et le résultat.
Je garde toutefois une distinction nette entre transformation et validation. Un contenu lisible après décodage n’est pas pour autant authentique, fiable ou inoffensif. Le décodage révèle une représentation différente ; il ne prouve ni l’origine des données, ni leur intégrité, ni l’absence de comportement malveillant. Un résultat doit donc être interprété dans son contexte et vérifié avec des contrôles adaptés.
Pour limiter les erreurs, je conserve les données d’origine, je documente les recettes utilisées et je traite les résultats comme des données non fiables tant qu’ils n’ont pas été vérifiés. C’est particulièrement important lorsque le contenu provient d’une source inconnue ou doit ensuite être exécuté par un autre outil.
| Usage pertinent | Enchaîner des transformations, examiner des données et répéter un traitement avec une recette documentée. |
| Précaution | Un décodage ne valide ni la sécurité, ni l’authenticité, ni la fiabilité du contenu obtenu. |
Quels fichiers convertir avec ConvertX ?
Claude Sonnet 5.5 vaut-il le coup pour coder ?
ConvertX centralise la conversion de nombreux formats dans un service local. Il regroupe des outils associés comme FFmpeg, ImageMagick, LibreOffice, Pandoc, Calibre et Inkscape. L’intérêt est de disposer d’un point d’accès unique pour convertir des fichiers sans les envoyer vers un service de conversion hébergé sur Internet.
Garder les fichiers sur votre machine peut réduire leur exposition à des services tiers. C’est utile pour des documents internes, des données personnelles ou des fichiers soumis à des exigences de confidentialité. Ça ne remplace toutefois pas une vérification de sécurité : un fichier non fiable reste non fiable après conversion. La conversion ne garantit ni que son contenu est sûr, ni qu’il peut être ouvert sans risque dans un autre outil.
Le premier compte doit être réservé sans délai. Dans un service où le premier utilisateur obtient un rôle privilégié, laisser cette étape à plus tard peut permettre à quelqu’un d’autre de prendre cette place. Je ne pars pas du principe qu’un compte, un réglage ou un mode de déploiement précis existe ici : vérifiez les informations propres à votre installation avant de traiter des fichiers sensibles.
ConvertX est donc pertinent si vous voulez centraliser des conversions tout en gardant les fichiers dans un environnement local. Le choix du fichier et de sa provenance reste déterminant. Pour un usage professionnel, traitez les fichiers reçus comme non fiables, même après conversion, et appliquez vos contrôles habituels avant de les exploiter.
- Bénéfice : Conversion de nombreux formats dans un service local.
- Bénéfice : Fichiers conservés sur la machine plutôt qu’envoyés à un service externe.
- Précaution : Réserver le premier compte sans délai.
- Précaution : Ne pas considérer la conversion comme une mesure de sécurité.
Comment tester une API avec Hoppscotch CE ?
Hoppscotch CE sert à tester des requêtes API et à conserver des collections, des environnements et un historique. C’est utile pour vérifier un endpoint pendant le développement, comparer des réponses et partager un jeu de requêtes avec l’équipe.
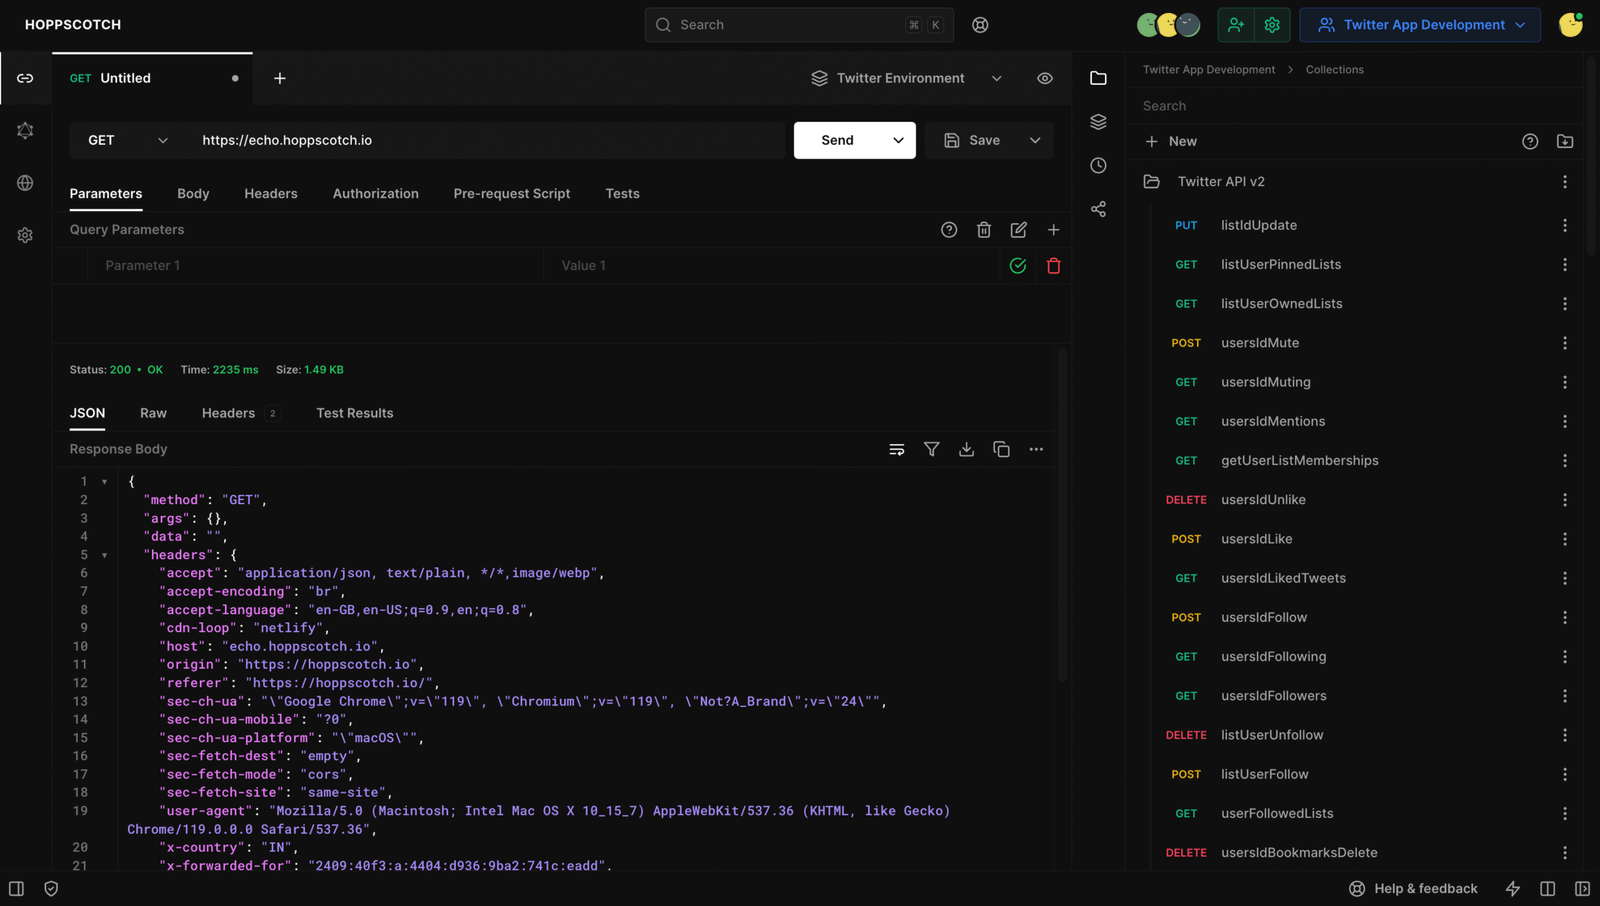
Dans une requête, vous configurez la méthode HTTP, l’URL, les en-têtes, l’authentification et le corps. La réponse affiche notamment le code de statut, les en-têtes, le contenu retourné et le temps de réponse. Les collections regroupent les requêtes par API ou par cas d’usage. Les environnements stockent les variables propres à chaque contexte, comme une URL de base ou un jeton d’accès. L’historique aide à retrouver les appels récents, mais peut aussi conserver des données sensibles.
Une installation auto-hébergée s’appuie généralement sur trois services applicatifs — l’interface principale, l’interface d’administration et le backend — ainsi que sur Postgres, la base de données relationnelle qui conserve les données de l’application. Les noms et le découpage exacts peuvent varier selon la version et le mode de déploiement. Postgres doit être traité comme un composant persistant : prévoyez son stockage et sa sauvegarde.
Les fichiers .env peuvent contenir des mots de passe, des clés ou des paramètres de connexion. Les requêtes enregistrées et l’historique peuvent aussi inclure des jetons, des données personnelles ou des réponses internes. Traitez ces éléments comme des données sensibles : limitez les accès, évitez de versionner les secrets et purgez les données de test qui ne doivent pas être conservées.
| Composants à prévoir | Interface principale, interface d’administration, backend, Postgres et stockage persistant pour la base. |
| Éléments à protéger | Fichiers .env, mots de passe, clés, jetons, collections, environnements, historique et données de réponse. |
Comment générer des diagrammes avec Kroki ?
Kroki génère localement des diagrammes à partir de texte. Un conteneur Kroki permet de convertir des descriptions textuelles en images, sans envoyer leur contenu à un service tiers. C’est utile quand les diagrammes décrivent une architecture interne, des flux sensibles ou des composants non publiés.
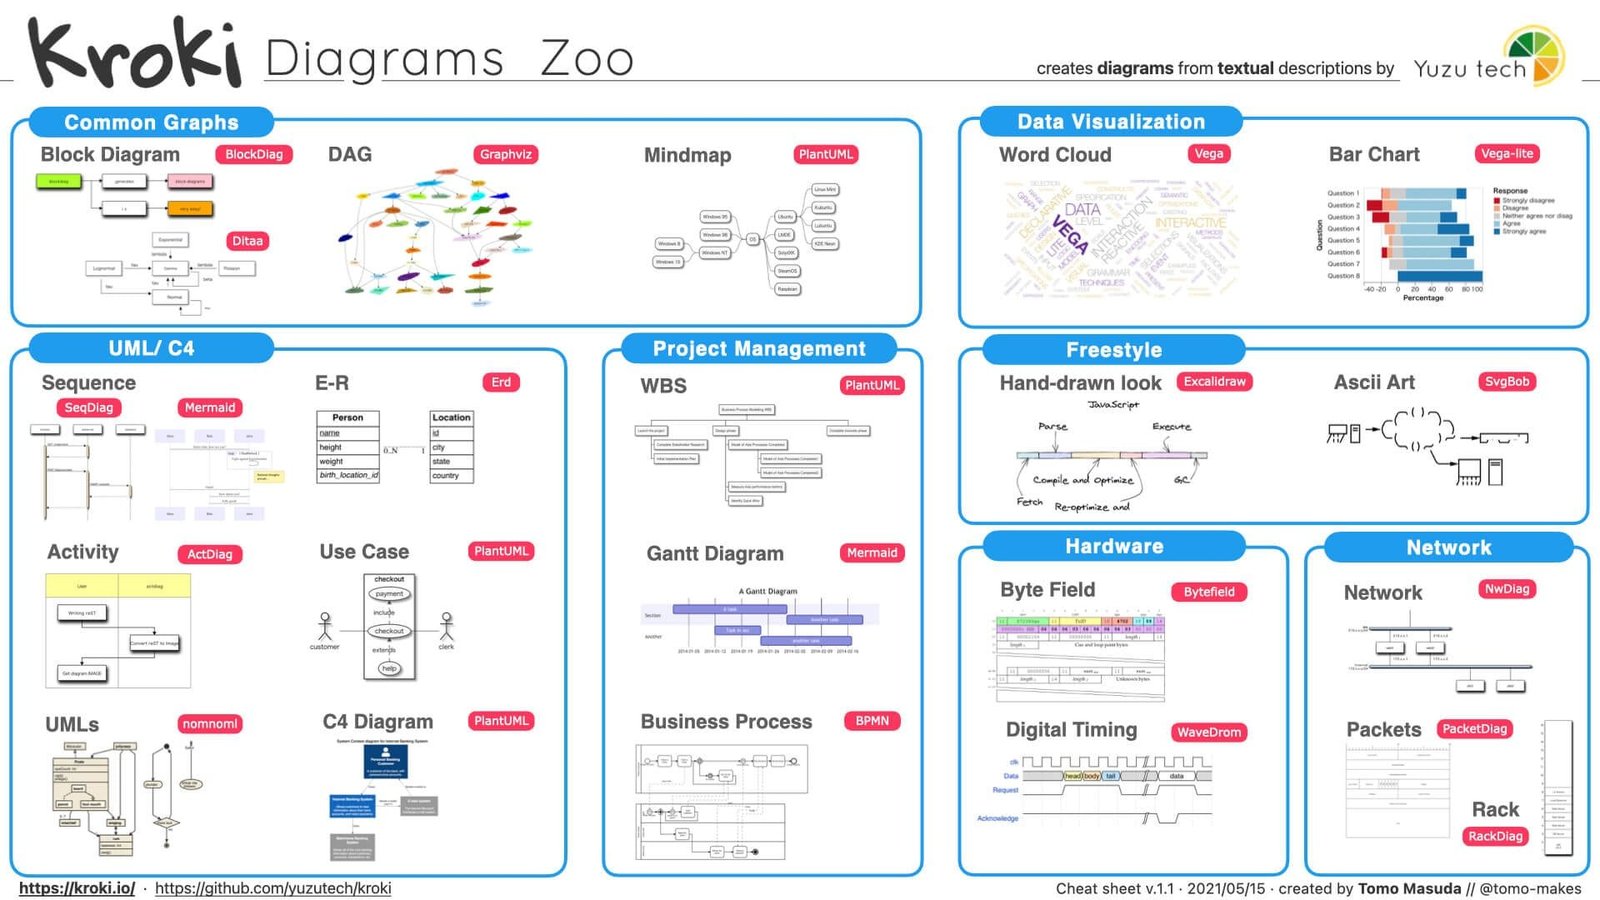
Kroki prend en charge plusieurs syntaxes. PlantUML décrit des diagrammes UML, des séquences ou des composants. GraphViz représente des graphes et des relations, avec le langage DOT. D2 sert à produire des diagrammes d’architecture à partir d’une syntaxe concise. Structurizr permet de modéliser des systèmes selon le modèle C4, qui représente l’architecture à plusieurs niveaux de détail.
Le choix dépend surtout de vos usages et des conventions déjà présentes dans le projet. Si vos équipes écrivent en PlantUML, Kroki évite d’ajouter un service externe au processus de génération. Si vous n’utilisez qu’une seule syntaxe, inutile d’installer les outils complémentaires associés aux autres formats. Dans les projets clients, le point sensible n’est généralement pas le rendu, mais la cohérence entre la syntaxe choisie, les fichiers versionnés et les outils que l’équipe sait maintenir.
Gardez la configuration minimale. Ajoutez uniquement les images complémentaires correspondant aux syntaxes réellement utilisées par le projet, plutôt que d’activer toutes les possibilités par défaut. Vous réduisez ainsi les dépendances et les composants à maintenir, sans perdre de fonctionnalité utile.
- PlantUML convient aux diagrammes UML, aux séquences et aux composants.
- GraphViz convient aux graphes décrits avec DOT.
- D2 convient aux diagrammes d’architecture écrits dans une syntaxe concise.
- Structurizr convient aux vues d’architecture basées sur le modèle C4.
- Le principe de configuration minimale est de ne garder que Kroki et les images complémentaires nécessaires aux syntaxes effectivement utilisées.
Quel conteneur Docker choisir pour votre besoin ?
Ces cinq conteneurs couvrent des besoins distincts : IT-Tools pour le dépannage courant, CyberChef pour les transformations, ConvertX pour les conversions, Hoppscotch CE pour les tests d’API et Kroki pour les diagrammes. Leur intérêt commun est de fournir des outils en local, sans envoyer les données vers des sites tiers. Ça ne dispense pas de gérer les risques : un contenu décodé n’est pas nécessairement sûr, un fichier non fiable le reste après conversion, et secrets ou historiques doivent être protégés. Choisissez selon vos usages, limitez les composants à ceux dont votre projet a besoin et gardez les données sensibles sous contrôle. Vous gagnez ainsi un environnement de travail plus pratique, tout en réduisant les transferts inutiles de données.
FAQ
-
Quels sont les cinq conteneurs Docker présentés ?
IT-Tools, CyberChef, ConvertX, Hoppscotch CE et Kroki. Ils répondent respectivement à des besoins de dépannage, de transformation de données, de conversion de fichiers, de tests d’API et de génération de diagrammes. -
Les données restent-elles sur la machine avec ces outils ?
Leur intérêt est de fournir des outils en local, sans envoyer les données vers des sites tiers. Cela ne signifie pas que les données manipulées sont automatiquement sûres ou que les secrets stockés localement sont protégés. -
CyberChef garantit-il qu’une donnée décodée est sûre ?
Non. CyberChef enchaîne des opérations de décodage et de transformation, mais le décodage ne garantit ni la fiabilité ni la sécurité du contenu obtenu. -
Quelle précaution prendre avec ConvertX ?
Réservez le premier compte sans délai. Gardez aussi à l’esprit qu’un fichier non fiable le reste après sa conversion, même si le traitement est local. -
Quels éléments protéger avec Hoppscotch CE ?
Les fichiers .env et l’historique peuvent contenir des secrets. Hoppscotch CE mobilise aussi trois services et Postgres, éléments à prendre en compte dans son installation. -
Quelles syntaxes Kroki peut-il utiliser ?
Kroki génère notamment des diagrammes à partir de PlantUML, GraphViz, D2 et Structurizr. Il est recommandé de n’ajouter des images complémentaires que pour les syntaxes utilisées par le projet.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. Je conçois des environnements et des workflows qui facilitent le traitement local des données et leur intégration dans des applications métier intelligentes.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.