


Les bons scripts Python pour automatiser vos CSV sont ceux qui contrôlent, comparent, nettoient, transforment et dédupliquent vos fichiers sans dépendances externes. Je vous montre comment structurer ces automatisations proprement, avec la bibliothèque standard Python, pour éviter les erreurs silencieuses dans vos workflows data.
Comment valider un CSV ?
Un CSV, ça a l’air simple. Mais dans la vraie vie, c’est souvent là que les ennuis commencent. Une colonne renommée, un champ vide, un prix qui arrive avec une virgule au lieu d’un point, et votre reporting casse, votre scénario n8n part en erreur, votre CRM importe n’importe quoi ou votre traitement IA avale des données sales sans broncher.
Je mets presque toujours ce garde-fou au début d’un pipeline. Le principe est simple : je compare chaque ligne du CSV à un schéma attendu. Ce schéma dit quelles colonnes doivent exister, quel type de donnée on attend, si le champ est obligatoire, et parfois quel motif il doit respecter avec une regex, c’est-à-dire une règle de recherche de texte.
Claude Sonnet 5.5 vaut-il le coup pour coder ?
Voici un script complet nommé validate_csv_schema.py. Il utilise uniquement des modules standards de Python pour lire le CSV, charger le schéma JSON, valider les lignes et produire un rapport d’erreurs exploitable.
import argparse
import csv
import json
import re
from datetime import datetime
from pathlib import Path


def parse_value(value, expected_type):
    # On considère les valeurs déjà nettoyées avec strip().
    if expected_type == "string":
        return True, value

    if expected_type == "int":
        try:
            return True, int(value)
        except ValueError:
            return False, "Valeur entière invalide"

    if expected_type == "float":
        try:
            return True, float(value)
        except ValueError:
            return False, "Valeur décimale invalide"

    if expected_type == "bool":
        if value.lower() in ("true", "false", "1", "0", "yes", "no"):
            return True, value.lower() in ("true", "1", "yes")
        return False, "Booléen invalide"

    if expected_type == "date":
        try:
            return True, datetime.strptime(value, "%Y-%m-%d").date()
        except ValueError:
            return False, "Date invalide, format attendu YYYY-MM-DD"

    return False, f"Type inconnu: {expected_type}"


def validate_row(row, schema_columns, row_number):
    errors = []

    for rule in schema_columns:
        column = rule["name"]
        expected_type = rule.get("type", "string")
        required = rule.get("required", False)
        regex = rule.get("regex")

        raw_value = row.get(column, "")
        value = raw_value.strip() if raw_value is not None else ""

        if required and value == "":
            errors.append({
                "row_number": row_number,
                "column": column,
                "error": "Champ obligatoire vide",
                "value": raw_value
            })
            continue

        if value == "":
            continue

        ok, parsed_or_error = parse_value(value, expected_type)
        if not ok:
            errors.append({
                "row_number": row_number,
                "column": column,
                "error": parsed_or_error,
                "value": raw_value
            })
            continue

        if regex and not re.fullmatch(regex, value):
            errors.append({
                "row_number": row_number,
                "column": column,
                "error": f"Regex non respectée: {regex}",
                "value": raw_value
            })

    return errors


def main():
    parser = argparse.ArgumentParser(description="Valide un CSV avec un schéma JSON.")
    parser.add_argument("--csv", required=True, help="Chemin du fichier CSV à valider")
    parser.add_argument("--schema", required=True, help="Chemin du fichier schema.json")
    parser.add_argument("--errors", required=True, help="Chemin du rapport CSV d'erreurs")
    args = parser.parse_args()

    csv_path = Path(args.csv)
    schema_path = Path(args.schema)
    errors_path = Path(args.errors)

    schema = json.loads(schema_path.read_text(encoding="utf-8"))
    schema_columns = schema["columns"]
    expected_columns = [column["name"] for column in schema_columns]

    all_errors = []

    with csv_path.open("r", encoding="utf-8-sig", newline="") as file:
        reader = csv.DictReader(file)

        missing_columns = [column for column in expected_columns if column not in reader.fieldnames]

        if missing_columns:
            for column in missing_columns:
                all_errors.append({
                    "row_number": 0,
                    "column": column,
                    "error": "Colonne manquante dans l'en-tête",
                    "value": ""
                })
        else:
            for row_number, row in enumerate(reader, start=2):
                all_errors.extend(validate_row(row, schema_columns, row_number))

    with errors_path.open("w", encoding="utf-8", newline="") as file:
        fieldnames = ["row_number", "column", "error", "value"]
        writer = csv.DictWriter(file, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(all_errors)

    if all_errors:
        print(f"Validation terminée avec {len(all_errors)} erreur(s).")
        raise SystemExit(1)

    print("Validation OK. Aucune erreur détectée.")


if __name__ == "__main__":
    main()
Le fichier schema.json peut ressembler à ça. Ici, je valide un export client avant import dans une base ou dans un CRM.
{
  "columns": [
    {
      "name": "email",
      "type": "string",
      "required": true,
      "regex": "^[^@\s]+@[^@\s]+\.[^@\s]+$"
    },
    {
      "name": "age",
      "type": "int",
      "required": false
    },
    {
      "name": "created_at",
      "type": "date",
      "required": true
    },
    {
      "name": "is_active",
      "type": "bool",
      "required": true
    }
  ]
}
La commande est volontairement simple, pour pouvoir la lancer en local, dans un cron, dans un workflow n8n ou juste avant une transformation automatisée.
python validate_csv_schema.py --csv clients.csv --schema schema.json --errors errors.csv
Comment gérer l’API rate limiting sans casse ?
Dans un pipeline, je bloque l’étape suivante si le script retourne une erreur. C’est bête, mais ça évite beaucoup de dégâts. Un client avait un import CRM qui créait des fiches sans email depuis trois semaines. Un validateur comme celui-ci aurait stoppé le fichier dès la première ligne invalide.
| Contrôle | Utilité | Erreur évitée |
| Colonnes obligatoires | Vérifier la structure du fichier | Import cassé ou mapping décalé |
| Types | Forcer int, float, bool ou date | Calculs faux ou base rejetée |
| Champs requis | Empêcher les valeurs critiques vides | Fiches incomplètes |
| Regex | Contrôler un format précis | Email, code ou identifiant invalide |
Comment comparer deux CSV ?
Comparer deux CSV ligne par ligne, c’est souvent une mauvaise idée. L’ordre change, l’export CRM trie autrement, un fichier produit est régénéré dans un ordre différent… et vous obtenez un faux rapport de différences. Je l’ai vu plein de fois chez des clients. Le bon réflexe, c’est de comparer avec une clé, c’est-à-dire une colonne stable qui identifie une ligne. Par exemple email, sku, id_client. Parfois, il faut une clé composite, comme pays + email.
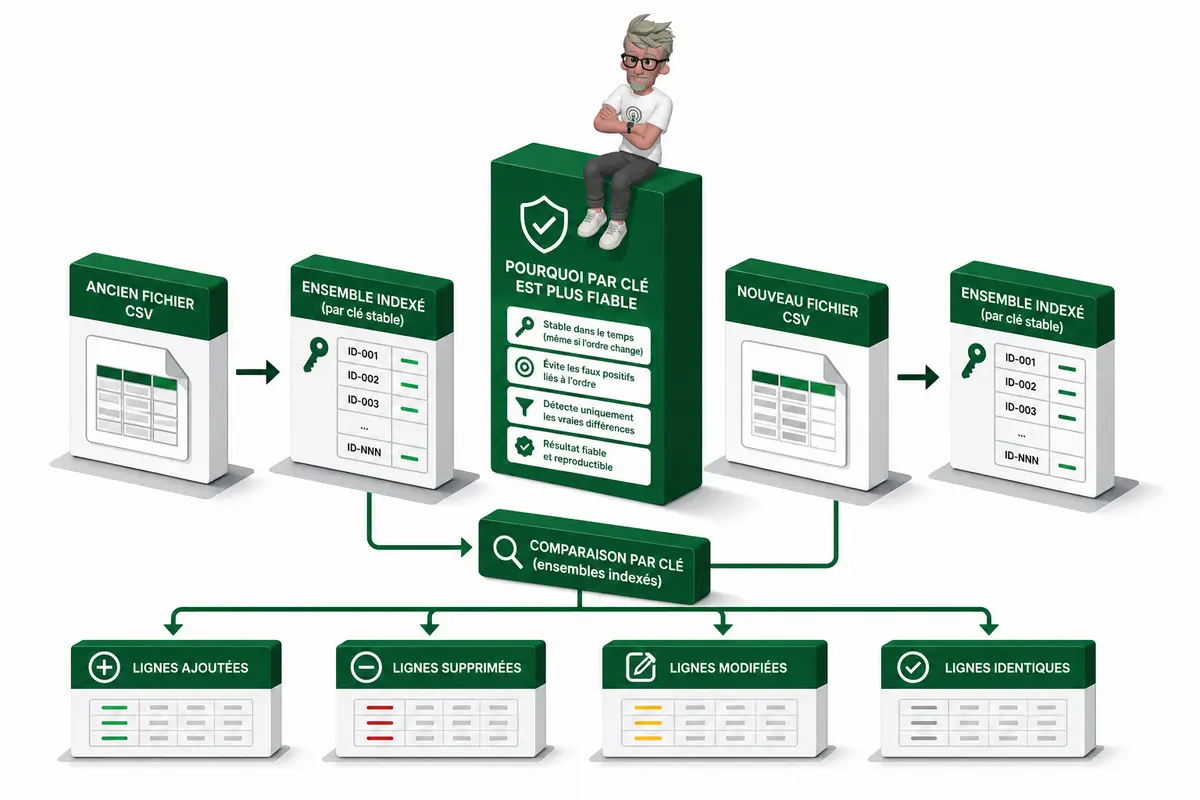
Un bon comparateur doit repérer seulement ce qui compte :
- Les lignes ajoutées.
- Les lignes supprimées.
- Les champs modifiés.
- Les lignes identiques, on les ignore.
Quelles commandes Git faut-il vraiment connaître ?
Ce script utilise csv.DictReader, qui lit chaque ligne comme un dictionnaire Python. C’est pratique parce qu’on manipule les colonnes par leur nom, pas par leur position.
Voici le fichier compare_csv.py. Il accepte deux CSV, une option –key avec une ou plusieurs colonnes séparées par des virgules, puis génère un rapport CSV.
import argparse
import csv
import json
import sys

def build_key(row, key_columns):
    values = []
    for col in key_columns:
        value = row.get(col, "")
        values.append(value.strip())
    return " | ".join(values)

def load_csv(path, key_columns):
    rows = {}

    with open(path, newline="", encoding="utf-8-sig") as f:
        reader = csv.DictReader(f)

        if not reader.fieldnames:
            raise ValueError(f"Le fichier {path} est vide ou invalide.")

        missing = [col for col in key_columns if col not in reader.fieldnames]
        if missing:
            raise ValueError(f"Clé absente dans {path}: {', '.join(missing)}")

        for line_number, row in enumerate(reader, start=2):
            key = build_key(row, key_columns)

            if not key.strip(" |"):
                raise ValueError(f"Clé vide dans {path}, ligne {line_number}")

            if key in rows:
                raise ValueError(f"Clé dupliquée dans {path}: {key}")

            rows[key] = row

    return rows

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("old_csv")
    parser.add_argument("new_csv")
    parser.add_argument("--key", required=True)
    parser.add_argument("--output", default="diff_report.csv")
    args = parser.parse_args()

    key_columns = [col.strip() for col in args.key.split(",") if col.strip()]

    old_rows = load_csv(args.old_csv, key_columns)
    new_rows = load_csv(args.new_csv, key_columns)

    all_columns = sorted(
        set().union(
            *(row.keys() for row in old_rows.values()),
            *(row.keys() for row in new_rows.values())
        )
    )

    with open(args.output, "w", newline="", encoding="utf-8") as f:
        fieldnames = ["change_type", "key", "column", "old_value", "new_value"]
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()

        for key in sorted(new_rows.keys() - old_rows.keys()):
            writer.writerow({
                "change_type": "added",
                "key": key,
                "column": "*",
                "old_value": "",
                "new_value": json.dumps(new_rows[key], ensure_ascii=False)
            })

        for key in sorted(old_rows.keys() - new_rows.keys()):
            writer.writerow({
                "change_type": "deleted",
                "key": key,
                "column": "*",
                "old_value": json.dumps(old_rows[key], ensure_ascii=False),
                "new_value": ""
            })

        for key in sorted(old_rows.keys() & new_rows.keys()):
            old_row = old_rows[key]
            new_row = new_rows[key]

            for col in all_columns:
                old_value = old_row.get(col, "")
                new_value = new_row.get(col, "")

                if old_value != new_value:
                    writer.writerow({
                        "change_type": "modified",
                        "key": key,
                        "column": col,
                        "old_value": old_value,
                        "new_value": new_value
                    })

if __name__ == "__main__":
    try:
        main()
    except Exception as e:
        print(f"Erreur: {e}", file=sys.stderr)
        sys.exit(1)
Avec clients_old.csv et clients_new.csv, si l’email identifie vraiment un client, je lance :
python compare_csv.py clients_old.csv clients_new.csv --key email --output rapport_clients.csv
Le vibe coding est-il fiable pour coder plus vite ?
Si le même email peut exister dans plusieurs pays, je prends une clé composite :
python compare_csv.py clients_old.csv clients_new.csv --key pays,email --output rapport_clients.csvLa clé est le point critique. Si elle n’est pas stable, le rapport ne vaut rien. Un email modifié peut ressembler à une suppression puis un ajout. Un SKU réutilisé peut masquer un vrai changement produit. C’est là que je passe le plus de temps en projet, pas sur le code.
| Cas | Interprétation business |
| added | Une nouvelle ligne existe dans le nouveau fichier. |
| deleted | Une ligne présente avant a disparu. |
| modified | La ligne existe toujours, mais au moins un champ a changé. |
Comment nettoyer encodage et séparateur ?
Je vois souvent des bugs CSV qui n’ont rien à voir avec les données. Le fichier est bon, mais il arrive avec un BOM invisible, un point-virgule “à la française”, une tabulation, des fins de ligne Windows, ou des accents explosés. Le plus simple, c’est de normaliser tout ça dès l’entrée.
Le module csv de Python aide déjà pas mal. Il fournit Sniffer, qui tente de détecter le dialecte CSV, donc le séparateur, les guillemets, etc. Et la doc Python recommande d’ouvrir les fichiers CSV avec newline= », pour laisser csv gérer correctement les fins de ligne.
Voici un script complet normalize_csv.py. Il teste plusieurs encodages courants, détecte le séparateur sur un échantillon, puis réécrit un CSV propre en UTF-8 sans BOM, séparé par des virgules.
import argparse
import csv
import sys


ENCODINGS = ["utf-8-sig", "utf-8", "cp1252", "latin-1"]


def detect_encoding(path):
    with open(path, "rb") as f:
        raw = f.read()

    for encoding in ENCODINGS:
        try:
            text = raw.decode(encoding)

            # Utf-8-sig retire le BOM si le fichier commence par cette marque invisible.
            # C'est fréquent avec certains exports Excel ou outils Windows.
            if encoding == "latin-1":
                # Latin-1 est très permissif car il décode presque tous les octets.
                # Ce n'est pas une preuve que l'encodage est correct, juste un fallback utile.
                pass

            return encoding, text
        except UnicodeDecodeError:
            continue

    raise UnicodeDecodeError("unknown", b"", 0, 1, "Aucun encodage compatible trouvé")


def detect_dialect(sample):
    sniffer = csv.Sniffer()

    try:
        return sniffer.sniff(sample, delimiters=[",", ";", "t", "|"])
    except csv.Error:
        dialect = csv.excel
        dialect.delimiter = ","
        return dialect


def normalize_csv(input_path, output_path):
    encoding, text = detect_encoding(input_path)
    sample = text[:8192]
    dialect = detect_dialect(sample)

    print(f"Encodage détecté: {encoding}", file=sys.stderr)
    print(f"Séparateur détecté: {repr(dialect.delimiter)}", file=sys.stderr)

    # newline='' laisse le module csv gérer les fins de ligne correctement.
    with open(input_path, "r", encoding=encoding, newline="") as src:
        reader = csv.reader(src, dialect)

        # encoding='utf-8' écrit de l'UTF-8 sans BOM.
        # lineterminator='n' normalise les retours à la ligne.
        with open(output_path, "w", encoding="utf-8", newline="") as dst:
            writer = csv.writer(
                dst,
                delimiter=",",
                quotechar='"',
                quoting=csv.QUOTE_MINIMAL,
                lineterminator="n"
            )

            for row in reader:
                writer.writerow(row)


def main():
    parser = argparse.ArgumentParser(description="Normalise un CSV en UTF-8 avec virgule.")
    parser.add_argument("input", help="Chemin du CSV source")
    parser.add_argument("output", help="Chemin du CSV normalisé")
    args = parser.parse_args()

    normalize_csv(args.input, args.output)


if __name__ == "__main__":
    main()
Je garde toujours les logs de détection. La détection automatique n’est jamais magique. Sur un fichier court, ou mal formé, csv.Sniffer peut se tromper. Mais au moins, vous savez ce que le script a supposé, et vous pouvez corriger vite.
| Problème | Symptôme | Correction appliquée |
| BOM UTF-8 | Première colonne bizarre, parfois “id” | Lecture avec utf-8-sig |
| Point-virgule | Toute la ligne arrive dans une seule colonne | Détection avec csv.Sniffer |
| Accents cassés | “é” à la place de “é” | Test de plusieurs encodages |
| Fins de ligne Windows | Lignes vides ou retours incohérents | Ouverture avec newline= » et sortie en n |
| Guillemets dans les champs | Colonnes décalées | Réécriture avec csv.writer |
Comment transformer les colonnes ?
Les colonnes, c’est souvent là que je gagne le plus de temps sur un CSV. Pas avec du code compliqué, plutôt avec une config claire. Je renomme, je supprime, je réordonne, je crée deux ou trois colonnes utiles, et je garde le même script. Le métier change la demande ? Je touche au JSON, pas au Python.
Voilà un script complet nommé transform_csv_columns.py. Il applique des règles simples et sûres. Pas de eval, donc pas d’exécution de code caché dans la config. Les dérivations sont limitées à concat, lower, upper et constant.
import argparse
import csv
import json
from pathlib import Path


def load_config(path):
    with path.open("r", encoding="utf-8") as f:
        config = json.load(f)

    for key in ["rename", "drop", "order", "derive"]:
        if key not in config:
            config[key] = {} if key in ["rename", "derive"] else []

    if not isinstance(config["rename"], dict):
        raise ValueError("La clé rename doit être un objet JSON.")
    if not isinstance(config["derive"], dict):
        raise ValueError("La clé derive doit être un objet JSON.")
    if not isinstance(config["drop"], list):
        raise ValueError("La clé drop doit être une liste.")
    if not isinstance(config["order"], list):
        raise ValueError("La clé order doit être une liste.")

    return config


def require_columns(existing, needed, context):
    missing = [col for col in needed if col not in existing]
    if missing:
        raise ValueError(f"Colonnes manquantes pour {context}: {missing}")


def transform(input_path, output_path, config_path):
    config = load_config(config_path)

    with input_path.open("r", encoding="utf-8", newline="") as f:
        reader = csv.DictReader(f)
        rows = list(reader)
        columns = reader.fieldnames or []

    rename = config["rename"]
    drop = config["drop"]
    derive = config["derive"]
    order = config["order"]

    require_columns(columns, rename.keys(), "rename")

    renamed_columns = [rename.get(col, col) for col in columns]
    if len(renamed_columns) != len(set(renamed_columns)):
        raise ValueError("Le renommage crée des colonnes en double.")

    new_rows = []
    for row in rows:
        new_row = {}
        for old_col in columns:
            new_row[rename.get(old_col, old_col)] = row.get(old_col, "")
        new_rows.append(new_row)

    columns = renamed_columns

    for target, rule in derive.items():
        if target in columns:
            raise ValueError(f"La colonne dérivée existe déjà: {target}")

        op = rule.get("op")

        if op == "concat":
            sources = rule.get("sources", [])
            sep = rule.get("sep", "")
            require_columns(columns, sources, f"derive.{target}")
            for row in new_rows:
                row[target] = sep.join(row.get(src, "") for src in sources)

        elif op in ["lower", "upper"]:
            source = rule.get("source")
            require_columns(columns, [source], f"derive.{target}")
            for row in new_rows:
                value = row.get(source, "")
                row[target] = value.lower() if op == "lower" else value.upper()

        elif op == "constant":
            value = str(rule.get("value", ""))
            for row in new_rows:
                row[target] = value

        else:
            raise ValueError(f"Opération de dérivation non supportée: {op}")

        columns.append(target)

    require_columns(columns, drop, "drop")
    columns = [col for col in columns if col not in drop]
    for row in new_rows:
        for col in drop:
            row.pop(col, None)

    if order:
        require_columns(columns, order, "order")
        extra = [col for col in columns if col not in order]
        if extra:
            raise ValueError(f"Colonnes absentes de order: {extra}")
        columns = order

    output_path.parent.mkdir(parents=True, exist_ok=True)
    with output_path.open("w", encoding="utf-8", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=columns)
        writer.writeheader()
        writer.writerows([{col: row.get(col, "") for col in columns} for row in new_rows])


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", required=True)
    parser.add_argument("--output", required=True)
    parser.add_argument("--config", required=True)
    args = parser.parse_args()

    transform(Path(args.input), Path(args.output), Path(args.config))


if __name__ == "__main__":
    main()
Sur un export client, je peux garder une config comme celle-ci. C’est lisible, vérifiable, et franchement plus simple à faire relire à une équipe métier qu’un script Python.
{
  "rename": {
    "first_name": "prenom",
    "last_name": "nom"
  },
  "drop": ["internal_id"],
  "derive": {
    "full_name": {
      "op": "concat",
      "sources": ["prenom", "nom"],
      "sep": " "
    }
  },
  "order": ["prenom", "nom", "full_name", "email"]
}
Je lance ensuite le script comme ça.
python transform_csv_columns.py --input clients.csv --output clients_clean.csv --config rules.jsonDans les workflows récurrents, cette approche évite les petites retouches permanentes. Un client m’avait demandé trois variantes du même export selon les équipes. Avant, chaque variante devenait un script. Avec une config par usage, on a gardé un seul moteur.
| Action | Usage |
| rename | Renommer les colonnes techniques avec des noms métier. |
| drop | Supprimer les colonnes inutiles ou internes. |
| derive | Créer des champs simples comme full_name, une valeur fixe ou une casse normalisée. |
| order | Imposer la structure finale du fichier livré. |
Comment dédupliquer un CSV ?
Un CSV ne se déduplique pas “juste” en supprimant les lignes qui se ressemblent. C’est souvent comme ça qu’on perd de l’info. J’ai déjà vu un fichier contacts où deux lignes avaient le même email, mais une seule avait le téléphone, et l’autre seule avait la société. Si on garde bêtement la première ligne, on jette la moitié de la donnée.
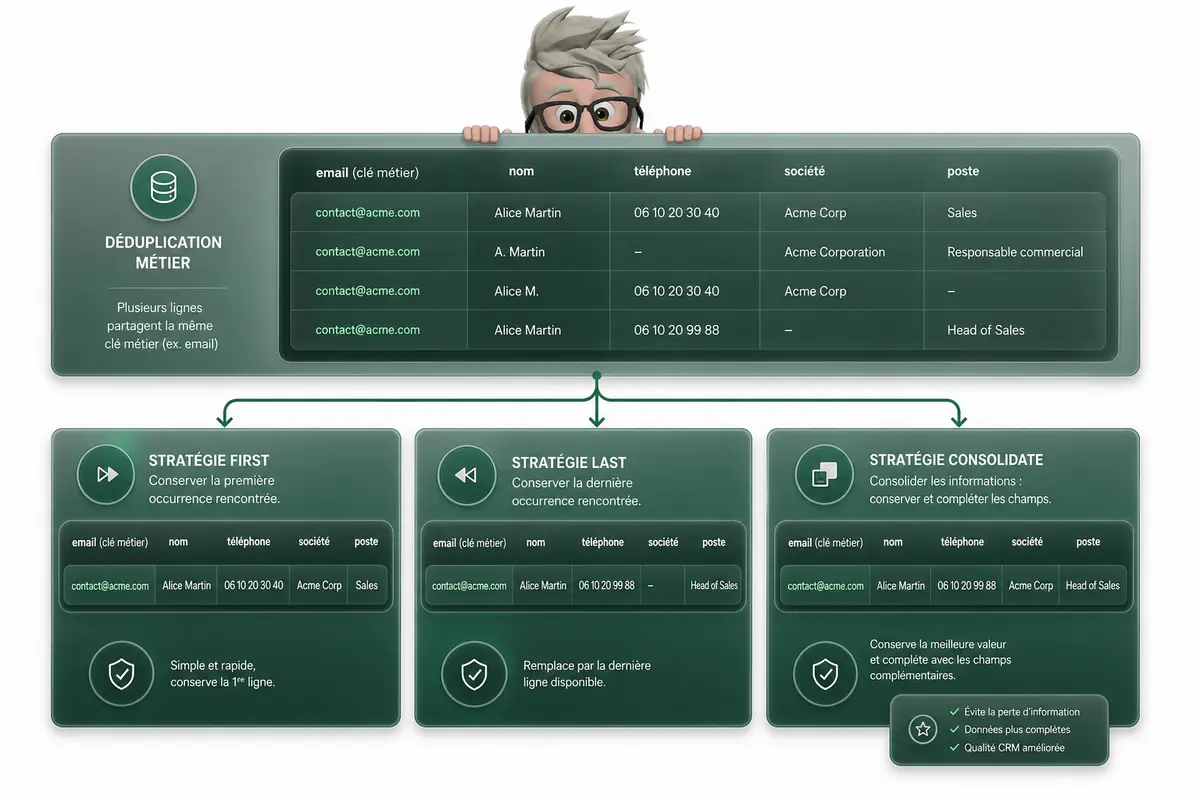
La vraie question, c’est la règle métier. Pour des contacts, l’email peut être une bonne clé. Pour des commandes, ce sera plutôt un numéro de commande. Pour des événements analytics, deux lignes identiques peuvent parfois être deux événements réels, donc là, attention à la fusion abusive.
Voici un script complet à mettre dans dedupe_consolidate_csv.py. Il accepte une clé simple ou composite avec –key email ou –key email,source. La stratégie first garde la première ligne, last garde la dernière, et consolidate complète les champs vides avec les valeurs trouvées dans les autres lignes du même groupe, sans écraser une valeur déjà présente.
from pathlib import Path
import argparse
import csv

def is_empty(value):
    return value is None or value.strip() == ""

def build_key(row, keys):
    return tuple((row.get(key) or "").strip() for key in keys)

def consolidate_rows(rows, fieldnames):
    result = dict(rows[0])

    for row in rows[1:]:
        for field in fieldnames:
            if is_empty(result.get(field)) and not is_empty(row.get(field)):
                result[field] = row.get(field, "")

    return result

def parse_args():
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", required=True)
    parser.add_argument("--output", required=True)
    parser.add_argument("--duplicates-report", required=True)
    parser.add_argument("--key", required=True, help="Exemple: email ou email,source")
    parser.add_argument("--strategy", required=True, choices=["first", "last", "consolidate"])
    return parser.parse_args()

def main():
    args = parse_args()

    input_path = Path(args.input)
    output_path = Path(args.output)
    report_path = Path(args.duplicates_report)

    keys = [key.strip() for key in args.key.split(",") if key.strip()]

    with input_path.open("r", newline="", encoding="utf-8-sig") as file:
        reader = csv.DictReader(file)
        fieldnames = reader.fieldnames or []

        missing_keys = [key for key in keys if key not in fieldnames]
        if missing_keys:
            raise ValueError(f"Colonnes absentes: {', '.join(missing_keys)}")

        groups = {}
        order = []
        row_numbers = {}

        for row_number, row in enumerate(reader, start=2):
            group_key = build_key(row, keys)

            if group_key not in groups:
                groups[group_key] = []
                row_numbers[group_key] = []
                order.append(group_key)

            groups[group_key].append(row)
            row_numbers[group_key].append(row_number)

    final_rows = []

    for group_key in order:
        rows = groups[group_key]

        if args.strategy == "first":
            final_rows.append(rows[0])
        elif args.strategy == "last":
            final_rows.append(rows[-1])
        else:
            final_rows.append(consolidate_rows(rows, fieldnames))

    with output_path.open("w", newline="", encoding="utf-8") as file:
        writer = csv.DictWriter(file, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(final_rows)

    report_fields = ["_duplicate_group_key", "_duplicate_count", "_source_row_number"] + fieldnames

    with report_path.open("w", newline="", encoding="utf-8") as file:
        writer = csv.DictWriter(file, fieldnames=report_fields)
        writer.writeheader()

        for group_key in order:
            rows = groups[group_key]

            if len(rows) <= 1:
                continue

            for index, row in enumerate(rows):
                report_row = {
                    "_duplicate_group_key": "|".join(group_key),
                    "_duplicate_count": len(rows),
                    "_source_row_number": row_numbers[group_key][index],
                }
                report_row.update(row)
                writer.writerow(report_row)

if __name__ == "__main__":
    main()
Sur un fichier de contacts, ça donne par exemple deux lignes avec email=lea@demo.fr. La première a le téléphone, mais pas la société. La seconde a la société, mais pas le téléphone. Avec consolidate, je garde une seule ligne et je récupère les deux infos. Avec first, je perds la société. Avec last, je peux perdre le téléphone.
La mauvaise clé est le risque numéro un. Dédupliquer sur le prénom et le nom peut fusionner deux homonymes. Dédupliquer sur l’email peut être faux si plusieurs personnes partagent une boîte générique comme contact@entreprise.com. Et sur des commandes, fusionner deux lignes avec le même client serait carrément une erreur métier.
| Stratégie | Comportement | Cas d’usage adapté |
| first | Garde la première ligne trouvée. | Import stable, source déjà triée par priorité. |
| last | Garde la dernière ligne trouvée. | Données mises à jour chronologiquement, dernière version fiable. |
| consolidate | Complète les champs vides sans écraser les valeurs existantes. | Contacts, leads, fichiers enrichis depuis plusieurs sources. |
On automatise vos CSV proprement maintenant ?
Automatiser les CSV avec Python, ce n’est pas juste gagner quelques minutes sur un export. C’est surtout éviter les erreurs invisibles qui polluent les analyses, les imports et les décisions. Avec un validateur, un comparateur, un normalisateur, un transformateur configurable et un outil de déduplication, on couvre déjà une grosse partie des problèmes récurrents. J’aime bien cette approche parce qu’elle reste simple : bibliothèque standard, scripts autonomes, logs lisibles, contrôles clairs. Vous gardez la main sur vos données, sans empiler des dépendances inutiles. Le vrai bénéfice pour vous, c’est un workflow CSV plus fiable, plus rapide et plus facile à maintenir.
FAQ
- Pourquoi automatiser le traitement des CSV avec Python ?
Parce que les mêmes problèmes reviennent tout le temps : colonnes qui changent, séparateurs différents, encodage cassé, doublons, exports modifiés. Python permet de contrôler tout ça avec des scripts simples, reproductibles et faciles à intégrer dans un workflow data. - Peut-on traiter des CSV sans installer de librairie externe ?
Oui. La bibliothèque standard Python suffit pour beaucoup de cas. Le module csv gère la lecture, l’écriture, les dialectes et une partie de la détection. Les modules json, re, argparse et pathlib couvrent la configuration, les validations, la ligne de commande et les chemins de fichiers. - Quel script CSV faut-il créer en premier ?
Je commencerais par le validateur de schéma. C’est celui qui évite le plus d’erreurs silencieuses. Avant de transformer ou d’importer un fichier, on vérifie qu’il contient les bonnes colonnes, les bons types et les champs vraiment obligatoires. - Comment comparer deux fichiers CSV efficacement ?
Il faut utiliser une clé stable, simple ou composite. Comparer deux fichiers ligne par ligne fonctionne mal si l’ordre change. Avec une clé, on peut détecter proprement les lignes ajoutées, supprimées et modifiées, puis générer un rapport centré sur les différences utiles. - Quels sont les risques avec la déduplication CSV ?
Le principal risque, c’est de supprimer ou fusionner des lignes qui ne devraient pas l’être. La clé de déduplication doit être choisie avec soin. Et la stratégie doit être claire : garder la première ligne, la dernière, ou consolider les champs incomplets sans écraser les données utiles.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’aide les entreprises sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA, le SEO et le GEO. J’ai accompagné des équipes chez Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Les sujets CSV, pipelines data, qualité de données et automatisation, je les croise tout le temps sur le terrain. Si vous voulez fiabiliser vos workflows data ou automatiser vos traitements, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.