
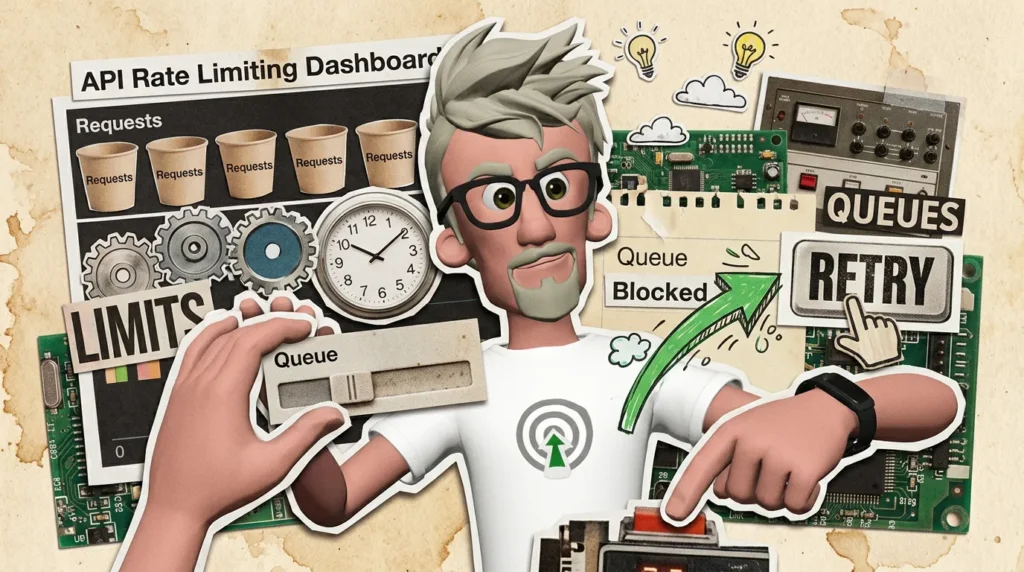


L’API rate limiting se gère en lisant les limites, en ralentissant les appels et en reprenant proprement après un 429. Le vrai sujet, c’est pas l’erreur. C’est votre workflow qui doit rester fiable quand le volume monte.
À quoi sert l’API rate limiting ?
Une API rate limit fixe le nombre maximal de requêtes autorisées sur une période donnée. Dit plus simplement, l’API vous dit jusqu’où vous pouvez pousser avant qu’elle commence à refuser, ralentir ou bloquer vos appels.
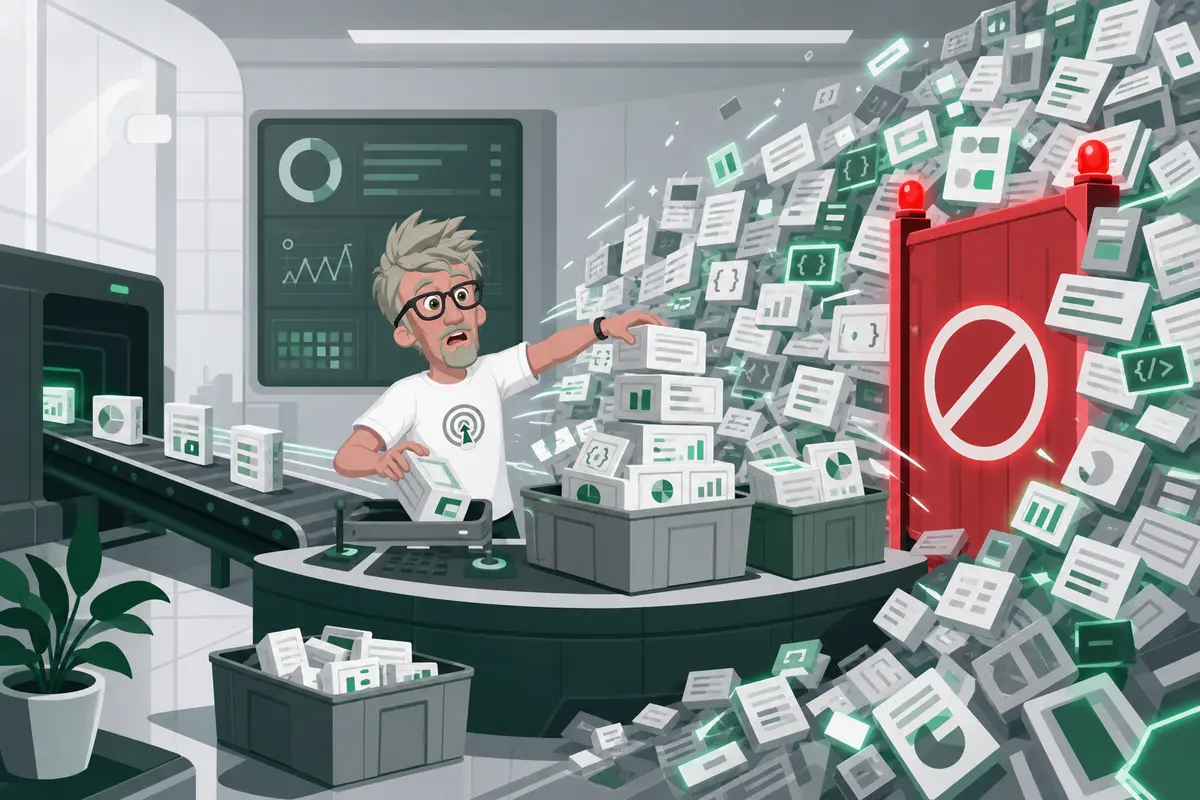
C’est un sujet qu’on sous-estime souvent, surtout en automatisation Low code. Un workflow qui passe très bien sur 50 lignes peut casser sur 50 000 si chaque ligne déclenche 3, 5 ou 10 appels API. Là, on ne parle plus d’un petit test propre. On parle d’un vrai volume business, avec des imports CRM, des synchronisations e-commerce, des scripts d’intégration, des enrichissements de données, des mises à jour de commandes ou de contacts.
Quels scripts Python pour automatiser vos CSV ?
Les limites peuvent prendre plusieurs formes. Il faut surtout connaître les classiques, parce que ce sont elles qui font tomber les scénarios en production.
- Limite par minute : Pratique pour contrôler le débit immédiat.
- Limite par heure : Fréquente sur les API SaaS, CRM ou marketing.
- Limite par jour : Souvent liée au plan tarifaire ou au compte client.
- Limite par endpoint : Certaines routes sont plus sensibles que d’autres, par exemple la recherche ou l’export.
- Limite par client, clé API ou type d’opération : L’éditeur peut distinguer lecture, écriture, suppression ou enrichissement.
Les éditeurs imposent ces limites pour protéger leur infrastructure, éviter les abus et répartir les ressources entre tous les clients. Une API, ce n’est pas une autoroute infinie. Si tout le monde envoie 100 000 requêtes d’un coup, le service tombe ou devient lent pour tout le monde.
Il y a aussi une nuance importante. Certaines API acceptent des pics temporaires, par exemple 500 requêtes très vite puis une pause. D’autres attendent un débit stable, comme 10 requêtes par seconde sans variation brutale. Ça change complètement la façon de construire votre workflow.
Claude Sonnet 5.5 vaut-il le coup pour coder ?
Sur le terrain, j’ai souvent vu des workflows n8n ou Make très propres en test, puis instables dès qu’on branche un vrai volume business. Le problème n’est pas forcément l’outil. C’est souvent l’absence de stratégie de rythme.
| Type de limite | Exemple | Impact sur le workflow |
| Par minute | 60 requêtes par minute | Le scénario doit ralentir ou attendre entre les lots. |
| Par heure | 5 000 appels par heure | Un gros import peut devoir être découpé. |
| Par jour | 100 000 appels par jour | Le traitement peut dépasser le quota avant la fin. |
| Par endpoint | Recherche limitée à 10 appels par seconde | Une étape précise devient le goulot d’étranglement. |
| Par clé API | Quota partagé entre plusieurs automatisations | Un workflow peut bloquer les autres sans prévenir. |
Quels algorithmes faut-il connaître ?
Les quatre mécanismes les plus utiles à comprendre sont token bucket, leaky bucket, fixed window et sliding window. Je les vois comme quatre façons différentes de répondre à la même question : “Est-ce que j’ai le droit d’envoyer cet appel API maintenant, ou est-ce que j’attends ?”
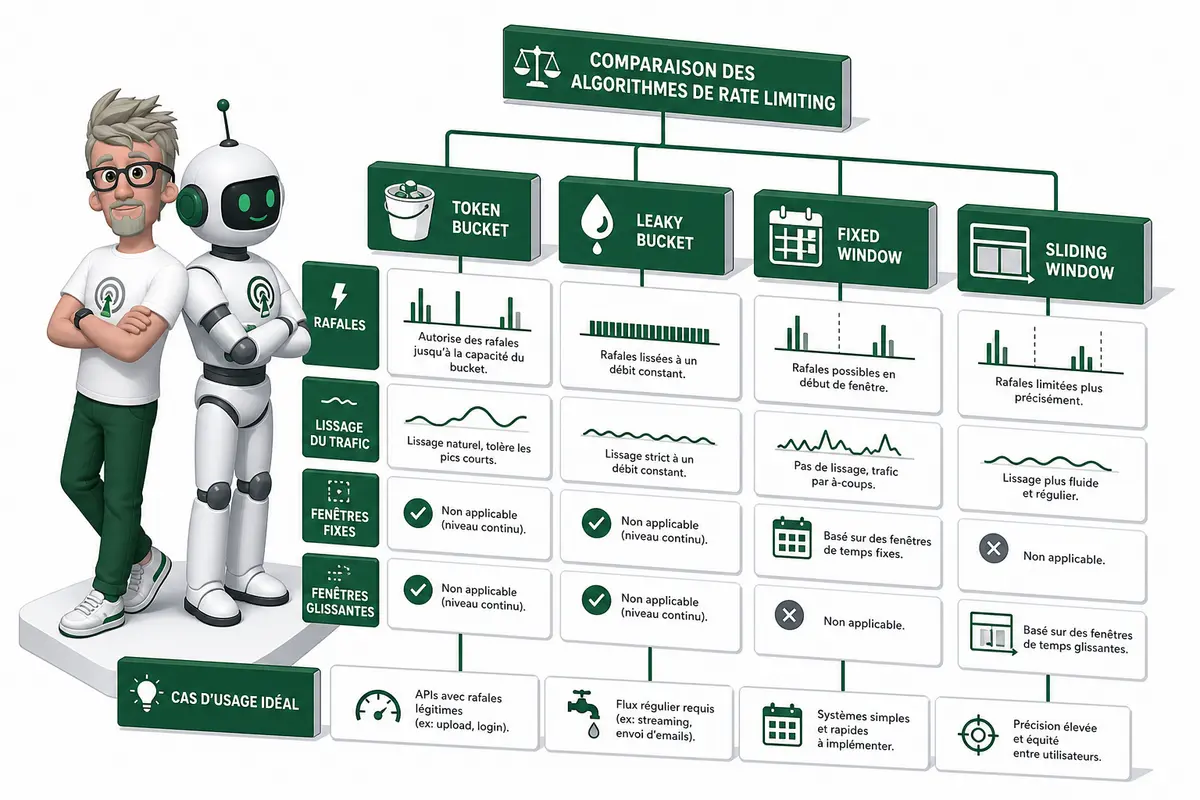
- Token bucket fonctionne avec des jetons. Le seau se remplit dans le temps, par exemple 5 jetons par seconde, et chaque requête consomme un jeton. Si le seau est plein, on peut envoyer une petite rafale. C’est pratique dans un workflow d’enrichissement CRM où vous envoyez parfois 20 contacts d’un coup, mais où vous voulez rester dans une limite propre.
- Leaky bucket ressemble à un seau qui fuit à débit constant. Les requêtes entrent, mais elles sortent toujours au même rythme. C’est très utile pour lisser les pics, par exemple quand un formulaire génère beaucoup de webhooks en quelques secondes.
- Fixed window utilise un compteur remis à zéro à intervalle fixe. Simple à comprendre : 100 appels par minute, puis reset. Le souci, c’est la frontière. Vous pouvez envoyer 100 appels à 10:00:59 puis 100 à 10:01:00. C’est brutal.
- Sliding window regarde une période glissante, par exemple les 60 dernières secondes réelles. C’est plus juste, ça évite les pics artificiels, mais ça demande plus de mémoire et de logique. Je l’utilise plutôt quand la précision compte, comme sur une API facturée à l’usage.
Voici un exemple simple de token bucket côté client. C’est utile quand je veux calmer mes propres workflows avant même que l’API me réponde avec une erreur 429.
const queue = [];
const capacity = 10; // Nombre maximum de jetons disponibles
let tokens = capacity;
const refillRate = 2; // Nombre de jetons ajoutés par seconde

setInterval(() => {
  tokens = Math.min(capacity, tokens + refillRate);
  runQueue();
}, 1000);

function addTask(task) {
  queue.push(task);
  runQueue();
}

async function runQueue() {
  while (tokens > 0 && queue.length > 0) {
    tokens--;
    const task = queue.shift();

    try {
      await task();
    } catch (error) {
      console.error("Erreur pendant l'appel API", error);
    }
  }
}

// Exemple d'usage
addTask(() => fetch("https://api.exemple.com/contacts"));
addTask(() => fetch("https://api.exemple.com/deals"));| Algorithme | Avantage | Limite | Bon usage |
| Token bucket | Autorise les rafales contrôlées | Demande une gestion des jetons | Synchronisation CRM, enrichissement de données |
| Leaky bucket | Lisse très bien les pics | Peut ralentir même quand l’API est disponible | Webhooks, files d’attente, automatisations instables |
| Fixed window | Très simple à implémenter | Effet brutal aux frontières | Limites simples par minute ou par heure |
| Sliding window | Plus précis et plus équitable | Plus complexe à suivre | APIs critiques, quotas payants, gros volumes |
Comment réagir à une réponse 429 ?
Quelles commandes Git faut-il vraiment connaître ?
Un 429 Too Many Requests, je le traite comme une consigne de pause, pas comme un échec définitif. Ce statut HTTP existe pour dire qu’un client a envoyé trop de requêtes dans un temps donné. L’API ne dit pas “jamais”, elle dit “pas maintenant”.
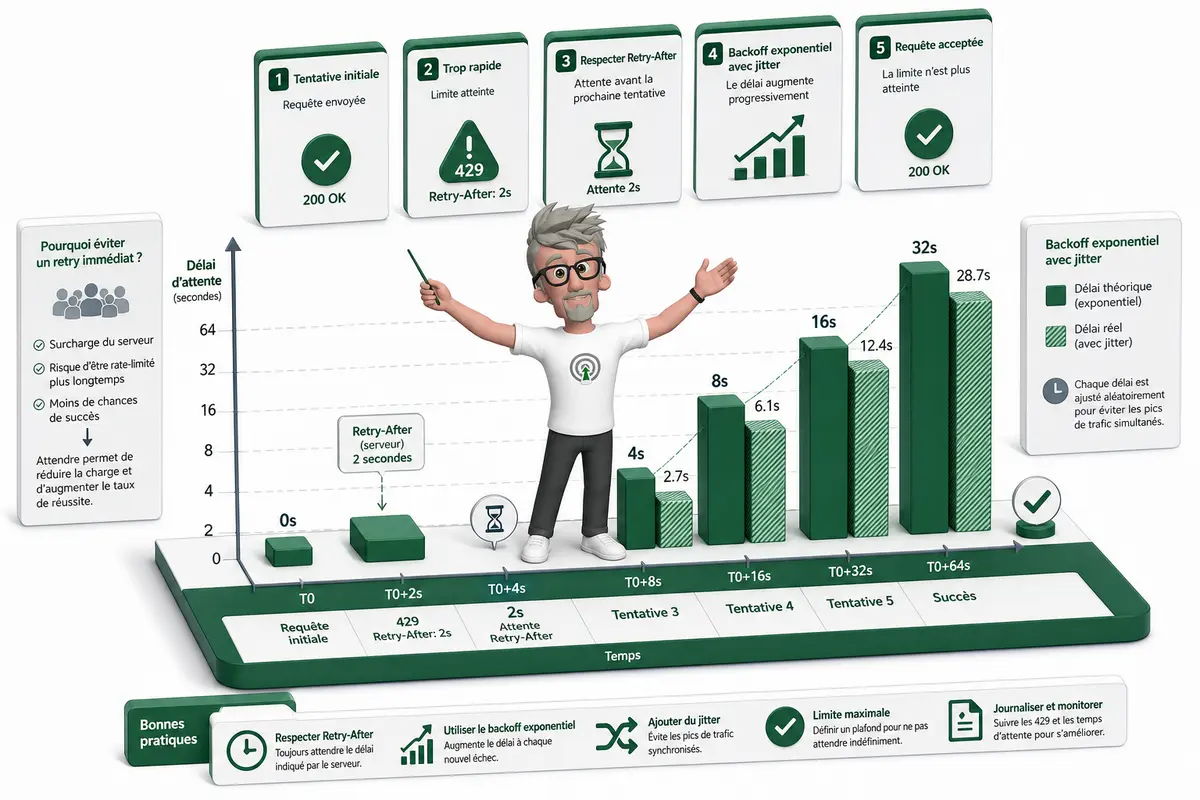
Le header le plus important, quand il est présent, c’est Retry-After. Il indique combien de temps attendre avant de retenter. Il peut contenir un nombre de secondes, ou une date HTTP complète. Le workflow doit lire ce signal, attendre, puis relancer proprement.
| Header | Rôle |
| RateLimit-Limit | Nombre total de requêtes autorisées sur la fenêtre |
| RateLimit-Remaining | Nombre de requêtes restantes |
| RateLimit-Reset | Moment où le quota se réinitialise |
| X-RateLimit-Limit, X-RateLimit-Remaining, X-RateLimit-Reset | Variantes historiques encore très fréquentes |
Le point important est simple. Votre workflow doit lire ces signaux et adapter son rythme automatiquement. Sinon, il tape dans le mur en boucle.
Le vibe coding est-il fiable pour coder plus vite ?
Voici une fonction JavaScript que j’utilise comme base. Elle gère le 429, lit Retry-After, attend le bon délai, limite les tentatives, et utilise un backoff exponentiel avec jitter quand l’API ne donne pas de délai précis. Le jitter, c’est une petite part d’aléatoire pour éviter que tous les workers retentent exactement au même moment.
const sleep = (ms) => new Promise((resolve) => setTimeout(resolve, ms));

function parseRetryAfter(value) {
  // Gère un délai en secondes.
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) {
    return Math.max(0, seconds * 1000);
  }

  // Gère une date HTTP, par exemple Wed, 21 Oct 2015 07:28:00 GMT.
  const dateMs = Date.parse(value);
  if (!Number.isNaN(dateMs)) {
    return Math.max(0, dateMs - Date.now());
  }

  return null;
}

function pickQuotaHeaders(headers) {
  const names = [
    "Retry-After",
    "RateLimit-Limit",
    "RateLimit-Remaining",
    "RateLimit-Reset",
    "X-RateLimit-Limit",
    "X-RateLimit-Remaining",
    "X-RateLimit-Reset"
  ];

  const result = {};
  for (const name of names) {
    const value = headers.get(name);
    if (value) result[name] = value;
  }

  return result;
}

async function fetchWithRateLimit(url, options = {}, config = {}) {
  const maxRetries = config.maxRetries ?? 5;
  const baseDelayMs = config.baseDelayMs ?? 500;

  for (let attempt = 0; attempt <= maxRetries; attempt++) {
    const response = await fetch(url, options);
    const quotaHeaders = pickQuotaHeaders(response.headers);

    // Log utile pour comprendre ce qui se passe en prod.
    console.log({
      url,
      status: response.status,
      attempt: attempt + 1,
      quotaHeaders
    });

    if (response.status !== 429) {
      return response;
    }

    if (attempt === maxRetries) {
      throw new Error(`Rate limit atteint après ${maxRetries + 1} tentatives pour ${url}`);
    }

    const retryAfterMs = parseRetryAfter(response.headers.get("Retry-After"));

    // Si Retry-After est absent, on ralentit progressivement.
    const exponentialDelayMs = baseDelayMs * 2 ** attempt;
    const jitterMs = Math.floor(Math.random() * baseDelayMs);
    const delayMs = retryAfterMs ?? exponentialDelayMs + jitterMs;

    await sleep(delayMs);
  }
}
Je préfère logger systématiquement l’URL, le statut, les headers de quota utiles et le numéro de tentative. Sans logs, on devine. Avec des logs, on corrige. J’ai vu des batchs “instables” redevenir parfaitement propres juste en ajoutant ces signaux et une vraie pause.
- Éviter le retry immédiat après un 429.
- Éviter la boucle infinie sans limite de tentatives.
- Éviter le traitement parallèle trop agressif.
- Éviter d’abandonner tout le batch après un seul 429.
Quelle stratégie choisir pour son workflow ?
La bonne stratégie dépend toujours du trafic, du coût des endpoints et de votre tolérance aux pics. Il n’existe pas un algorithme universel meilleur que les autres. Le bon choix vient du comportement attendu par l’API, mais aussi du niveau de fiabilité nécessaire côté business. Si une commande client échoue, ce n’est pas la même douleur qu’un export reporting repoussé de 2 minutes.
Dans mes workflows, je raisonne souvent comme ça. Si l’API accepte les rafales, token bucket est confortable. On accumule des “jetons”, chaque requête en consomme un, et on peut absorber un pic court sans bloquer tout le système. Si l’API veut un flux régulier, leaky bucket est plus sûr. Les requêtes sortent à rythme stable, comme un robinet qu’on contrôle.
Si on cherche une mise en place simple, et qu’un peu d’imprécision est acceptable, fixed window peut suffire. On compte les requêtes sur une fenêtre fixe, par exemple une minute. C’est simple, mais parfois brutal au changement de minute. Si on veut un contrôle plus fin sur une période mobile, sliding window devient pertinent. On regarde les requêtes sur les 60 dernières secondes réelles, pas juste sur la minute calendrier.
Une architecture fiable reste assez simple à visualiser. Une file d’attente reçoit les tâches. Un contrôleur de débit décide quand envoyer. Un wrapper HTTP gère les erreurs 429, c’est-à-dire “trop de requêtes”. Un logger conserve les signaux utiles. Un mécanisme de reprise relance uniquement les items échoués. Dans n8n, Make ou autre outil low code, ça revient souvent à séparer l’entrée des données, la cadence d’appel, la gestion d’erreur et la reprise. J’ai vu trop de workflows casser parce que tout était mélangé dans un seul bloc.
Cette configuration sert à éviter le hardcoding. Les limites ne sont pas enterrées dans le workflow, donc je peux ajuster les seuils sans tout réécrire.
{
  "contactsSearch": {
    "requestsPerMinute": 120,
    "burst": 30,
    "maxRetries": 3,
    "priority": "medium"
  },
  "ordersCreate": {
    "requestsPerMinute": 60,
    "burst": 10,
    "maxRetries": 5,
    "priority": "high"
  },
  "reportsExport": {
    "requestsPerMinute": 20,
    "burst": 5,
    "maxRetries": 2,
    "priority": "low"
  }
}| Situation | Stratégie conseillée | Pourquoi |
| API qui accepte les pics courts | Token bucket | Permet d’absorber une rafale sans dépasser la limite globale. |
| API fragile ou très stricte | Leaky bucket | Produit un flux régulier et prévisible. |
| Workflow simple avec faible risque | Fixed window | Facile à mettre en place, même si moins précis. |
| Besoin de contrôle fin | Sliding window | Mesure l’usage sur une période réellement glissante. |
Comment tenir la charge à l’échelle ?
Pour tenir la charge, je traite les quotas comme une contrainte de conception, pas comme un détail technique. Plus le volume augmente, plus les petites approximations deviennent visibles. Trop de parallélisme, des retries mal contrôlés, ou des endpoints coûteux appelés sans filtre, et une automatisation qui marchait très bien en test peut tomber en production.
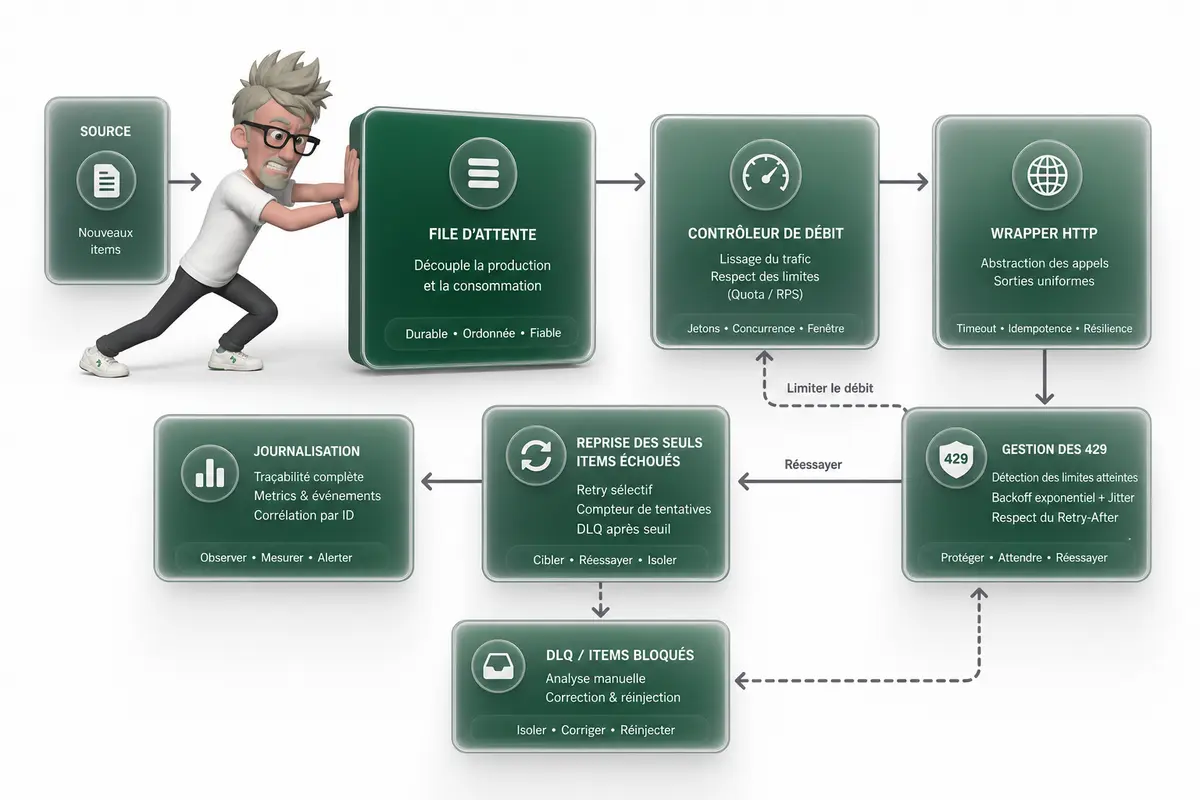
Je préfère poser quelques règles simples dès le départ. Les limites doivent être adaptées selon les clients et les endpoints, parce qu’une requête de lecture simple ne coûte pas pareil qu’une exportation massive. Les limites connues doivent être documentées dans le projet. Les appels API doivent passer par un wrapper commun, pas être dispersés partout dans le code. Quand l’API renvoie des headers de quota, je les lis. Par exemple, X-RateLimit-Remaining indique souvent le quota restant, et Retry-After indique combien de temps attendre avant de réessayer.
Le modèle le plus robuste reste souvent une file d’attente avec concurrence limitée. Ça évite d’envoyer 500 requêtes d’un coup juste parce qu’un tableau contient 500 lignes.
// File de traitement avec concurrence limitée.
// Utile dans Node.js, ou comme base pour un workflow d'automatisation.

async function processWithLimitedConcurrency(items, maxConcurrent) {
  const results = [];
  const errors = [];
  let index = 0;

  async function worker() {
    while (index < items.length) {
      const currentIndex = index;
      const item = items[currentIndex];
      index++;

      try {
        // fetchWithRateLimit centralise les retries, les pauses et la lecture des headers.
        const response = await fetchWithRateLimit(item);

        results.push({
          index: currentIndex,
          item,
          response
        });
      } catch (error) {
        errors.push({
          index: currentIndex,
          item,
          message: error.message
        });
      }
    }
  }

  const workers = Array.from(
    { length: Math.min(maxConcurrent, items.length) },
    () => worker()
  );

  await Promise.all(workers);

  return {
    total: items.length,
    successCount: results.length,
    errorCount: errors.length,
    results,
    errors
  };
}
Je journalise aussi les tentatives, les pauses, les erreurs, et le quota restant quand il est disponible. Et je mets une alerte quand le quota approche d’un seuil critique. Pas quand tout est déjà bloqué. Dans beaucoup de projets, le vrai gain vient moins d’un algorithme sophistiqué que d’une hygiène simple. Moins d’appels inutiles, des retries propres, une bonne file d’attente, et on élimine déjà une grosse partie des incidents.
Checklist avant mise en production :
- Les quotas connus sont documentés dans le projet.
- Les appels API passent par un wrapper commun.
- Les headers de quota sont lus quand ils existent.
- La concurrence maximale est limitée.
- Les retries sont contrôlés avec attente progressive.
- Les erreurs sont journalisées avec le contexte utile.
- Une alerte prévient avant d’atteindre le seuil critique.
Et maintenant vos workflows tiennent la charge ?
Le rate limiting n’est pas un détail à corriger après coup. C’est une règle du jeu à intégrer dès qu’un workflow commence à appeler une API sérieusement. J’ai besoin de connaître les limites, de lire les headers, de gérer les 429 proprement, de contrôler les retries et de choisir une stratégie adaptée au trafic réel. Token bucket, leaky bucket, fixed window ou sliding window, peu importe le nom si le workflow reste stable. Le bénéfice est très concret pour vous. Moins d’échecs silencieux, moins de traitements à relancer à la main, et des automatisations qui encaissent vraiment la charge.
FAQ
- Qu’est-ce que l’API rate limiting ?
L’API rate limiting définit combien de requêtes un client peut envoyer sur une période donnée. Ça peut être par minute, par heure, par jour ou par endpoint. Le but est de protéger l’API, éviter les abus et garder un service stable pour tout le monde. - Pourquoi mon workflow échoue quand le volume augmente ?
Parce qu’un workflow qui fonctionne sur quelques enregistrements peut dépasser les quotas API dès qu’il traite un gros volume. Si chaque ligne déclenche plusieurs appels, le nombre de requêtes explose vite. Sans pause, file d’attente ou retry propre, les erreurs 429 arrivent. - Que signifie l’erreur 429 Too Many Requests ?
Elle signifie que trop de requêtes ont été envoyées dans un délai trop court. Ce n’est pas forcément une erreur définitive. Il faut lire les informations de réponse, notamment Retry-After quand il existe, attendre le bon délai, puis relancer proprement. - Quel algorithme de rate limiting choisir ?
Token bucket convient bien si l’API tolère des pics. Leaky bucket est préférable pour lisser strictement le trafic. Fixed window est simple mais moins précis aux frontières de période. Sliding window donne un contrôle plus fin, avec plus de complexité. - Comment rendre une automatisation API plus fiable ?
Je centralise les appels API, je limite le parallélisme, je lis les headers de quota, je gère les 429 avec attente et retry, je journalise les tentatives et je reprends uniquement les items échoués. C’est souvent ça qui transforme un workflow fragile en système fiable.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui doivent fiabiliser leurs flux data, leurs API et leurs automatisations business, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez rendre vos workflows plus robustes, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.