


Gemini 3.5 Transcribe est plus complet pour les réunions et les transcriptions structurées. GPT-Transcribe reste intéressant si votre priorité, c’est le coût et le sous-titrage live. Je vous montre où chacun gagne, où ça coince, et comment choisir sans vous faire piéger par les annonces.
Quel modèle transcrit le mieux ?
Gemini 3.5 Transcribe affiche les meilleurs chiffres annoncés, surtout sur le WER et la transcription finale, mais GPT-Transcribe progresse fortement par rapport aux anciens modèles OpenAI.
Le WER, c’est le taux d’erreur sur les mots. En simple, plus il est bas, moins la transcription contient d’erreurs. Si un modèle remplace des mots, en oublie, ou en ajoute, ça fait monter le WER. C’est un indicateur utile, parce qu’il donne une idée assez directe de la propreté du texte final.
Quelle mémoire IA choisir pour vos agents ?
Sur les chiffres annoncés, Gemini 3.5 Transcribe est très solide. Il annonce 4,0 % de WER en streaming, donc quand la transcription arrive pendant que l’audio est encore en cours. Et 2,6 % hors streaming, quand le modèle peut traiter l’audio complet avant de produire le résultat final. Sur FLEURS, il affiche aussi 5,50 % et 5,04 %, ce qui reste très bon.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
GPT-Transcribe, lui, montre surtout une grosse amélioration côté OpenAI. Le WER passe de 40,37 % à 19,27 % sur Common Voice dans 22 langues. Dit autrement, on est encore sur des chiffres moins impressionnants que ceux annoncés par Gemini, mais le saut est important. Et ça compte, surtout si vous avez déjà utilisé d’anciens modèles OpenAI sur des audios pas très propres.
| Critère | Gemini 3.5 Transcribe | GPT-Transcribe | Lecture terrain |
| WER annoncé | 4,0 % en streaming, 2,6 % hors streaming. | De 40,37 % à 19,27 % sur Common Voice dans 22 langues. | Gemini part devant sur les chiffres bruts. |
| Transcription finale | Très forte sur le hors streaming. | Progrès net par rapport aux anciens modèles OpenAI. | À tester sur vos vrais fichiers avant de trancher. |
| Usage réel | Prometteur si les chiffres se retrouvent sur vos audios. | Intéressant si votre stack utilise déjà OpenAI. | Les benchmarks ne remplacent pas un test métier. |
Le point important, c’est que les benchmarks ne racontent pas toute l’histoire. En prod, ce qui compte vraiment, c’est votre audio à vous. Des accents, du bruit, des micros moyens, des réunions qui coupent, des noms propres, du jargon métier. J’ai vu des modèles excellents sur le papier perdre beaucoup de valeur dès qu’on leur donne des réunions commerciales mal enregistrées. Donc oui, Gemini semble meilleur sur les chiffres annoncés. Mais le bon choix, c’est celui qui tient sur vos audios réels.
Quelles fonctions changent vraiment tout ?
Quelles erreurs Python IA faussent vos modèles ?
Les fonctions qui changent vraiment tout sont la diarisation, les horodatages au mot, le vocabulaire personnalisé et le streaming.
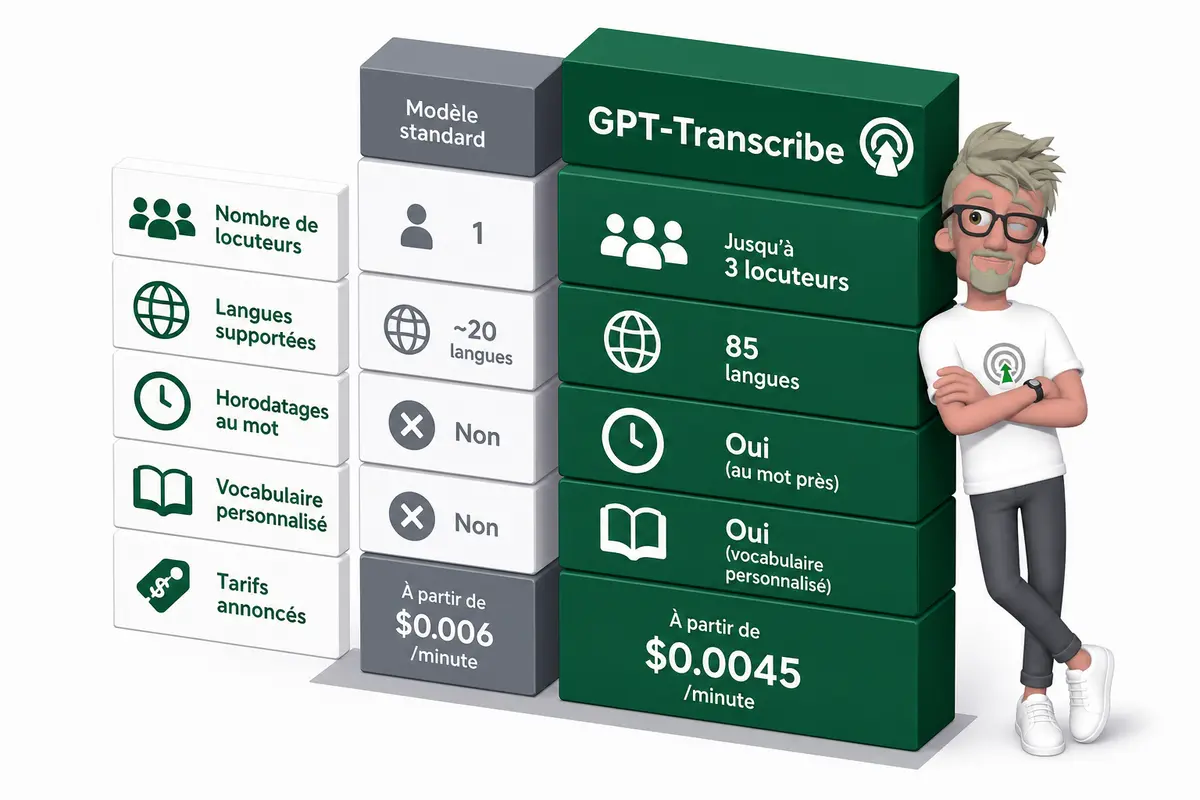
La diarisation, c’est la capacité à dire qui parle. Pas juste transcrire le texte, mais séparer “Intervenant 1”, “Intervenant 2”, “Intervenant 3”. Pour une réunion, un call center ou un compte rendu automatique, ça change tout. J’ai déjà vu des équipes passer plus de temps à corriger “qui a dit quoi” qu’à exploiter la transcription elle-même.
Gemini 3.5 Transcribe est plus confortable dès qu’on veut brancher la transcription dans un workflow data ou IA. Il gère jusqu’à trois locuteurs de manière fiable, fournit des horodatages au niveau du mot, prend en charge plus de 85 langues et permet d’ajouter du vocabulaire personnalisé. Le vocabulaire personnalisé, c’est utile quand vous avez des noms de produits, des acronymes internes, des termes métier ou des noms de clients que le modèle risque de massacrer.
Pourquoi choisir une architecture IA hybride ?
Les horodatages au mot sont aussi très pratiques. Vous pouvez retrouver le moment exact où une phrase a été dite, générer des sous-titres propres, découper l’audio, créer des extraits, ou vérifier automatiquement une zone sensible. Sans ça, on se retrouve vite à bricoler avec des segments approximatifs.
Côté GPT-Transcribe, il faut rester juste. Le modèle n’est pas mauvais. Le souci, c’est qu’il ne fournit pas nativement la diarisation ni les horodatages au niveau du mot. Donc si vous avez besoin de savoir qui parle, quand, et à quel moment précis dans l’audio, il faut prévoir une étape complémentaire. Ça peut être un outil externe, un modèle de diarisation, ou du post-traitement maison. Ça marche, mais ça ajoute de la complexité.
Sur le coût, GPT-Transcribe est annoncé 25 % moins cher que son prédécesseur, avec 0,0045 $ par minute pour les fichiers et 0,017 $ par minute de session en streaming. C’est intéressant. Mais je ne choisirais pas uniquement au prix minute. Le vrai coût, c’est le coût total : nettoyage, diarisation externe, contrôle qualité, corrections humaines, intégration dans vos outils.
| Besoin | Choix le plus logique |
| Diarisation native | Gemini 3.5 Transcribe |
| Sous-titres live ou traitement en streaming | À comparer selon votre usage, mais le streaming devient un critère central |
| Vocabulaire personnalisé | Gemini 3.5 Transcribe |
| Priorité au coût OpenAI annoncé | GPT-Transcribe |
Quel choix pour une réunion ?
DeepSeek Harness est-il la base des agents IA ?
Pour une réunion multi-intervenants, je partirais plutôt sur Gemini 3.5 Transcribe quand il faut obtenir un compte rendu exploitable rapidement. Je parle surtout des réunions où ça discute vraiment, avec plusieurs personnes, des prises de parole qui se chevauchent un peu, des noms de clients, des acronymes internes, et derrière un besoin très concret : sortir un résumé, des actions à faire, des décisions, voire alimenter une base consultable.
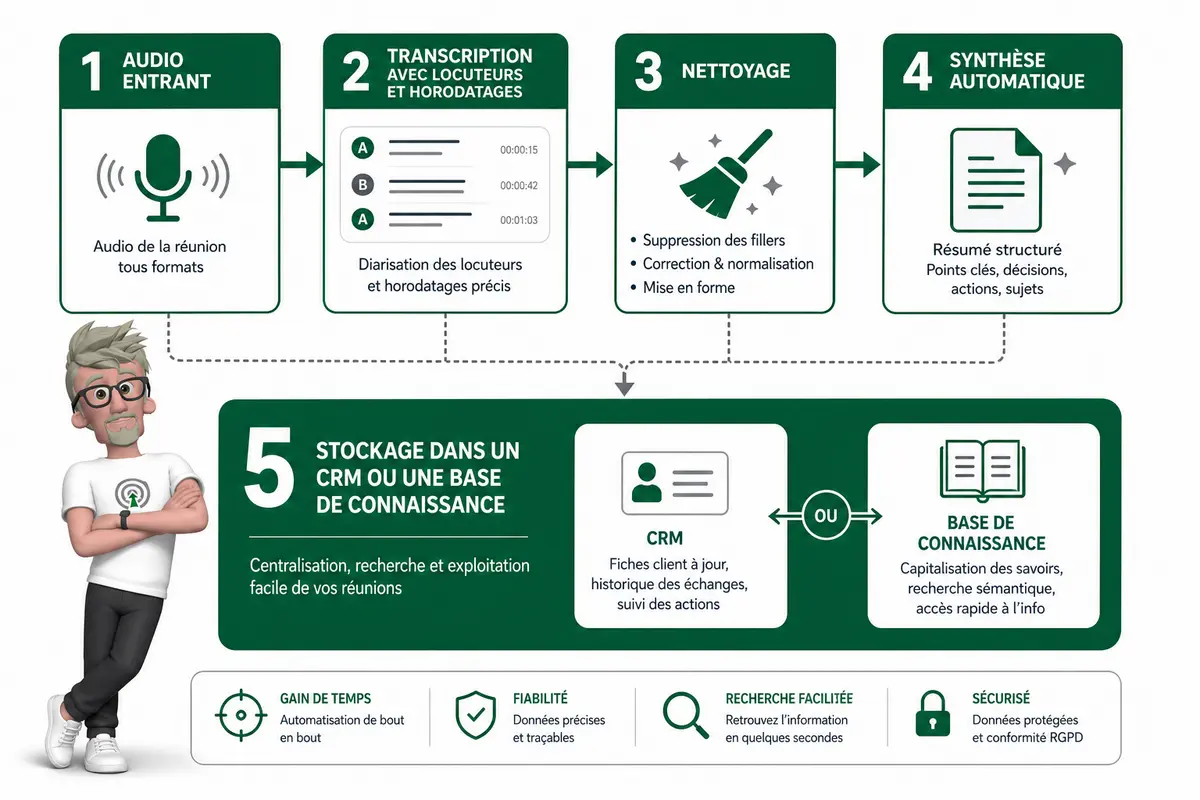
Dans ce contexte, la transcription brute ne suffit pas. J’ai besoin de savoir qui parle, quand, et avec quel niveau de fiabilité. La gestion jusqu’à trois locuteurs aide déjà beaucoup sur les réunions courtes ou les comités restreints. Les horodatages au niveau du mot sont utiles quand quelqu’un veut revenir au passage exact dans l’audio. Le vocabulaire personnalisé, lui, évite les contresens bêtes sur un nom de client, un produit ou un terme métier. C’est souvent là que les transcriptions génériques se plantent.
Côté développeur, je garderais un workflow simple, sans le verrouiller sur un endpoint inventé. Les appels API exacts doivent être alignés sur la documentation officielle utilisée par l’équipe au moment de l’intégration.
- Bloc 1. Envoyer le fichier audio au service de transcription, avec si possible le vocabulaire métier attendu.
- Bloc 2. Récupérer la transcription avec les locuteurs, les horodatages et les scores de confiance quand ils existent.
- Bloc 3. Nettoyer les segments, fusionner les phrases coupées, supprimer les hésitations inutiles.
- Bloc 4. Envoyer le texte structuré à un modèle de synthèse pour produire résumé, décisions et actions.
- Bloc 5. Stocker le résultat dans une base, un CRM, Notion, SharePoint ou un outil interne.
La sortie attendue peut ressembler à ça. Le champ speaker indique le locuteur détecté. Start_time et end_time donnent le début et la fin du segment. Text contient ce qui a été dit. Confidence donne le niveau de confiance si le service le fournit.
{
  "segments": [
    {
      "speaker": "Speaker 1",
      "start_time": "00:01:12.340",
      "end_time": "00:01:18.920",
      "text": "Il faut valider le planning avec le client Durand avant vendredi.",
      "confidence": 0.94
    }
  ]
}
Sur un projet client, le vrai gain n’était pas seulement d’avoir une transcription. C’était de pouvoir l’envoyer directement dans un process automatique, sans que quelqu’un repasse 30 minutes à remettre de l’ordre avant de créer les tâches et le compte rendu.
Quel choix pour du sous-titrage live ?
Pour du sous-titrage en direct, GPT-Transcribe peut être un bon choix si votre besoin principal est de transformer vite de l’audio en texte, avec un coût streaming annoncé clairement.
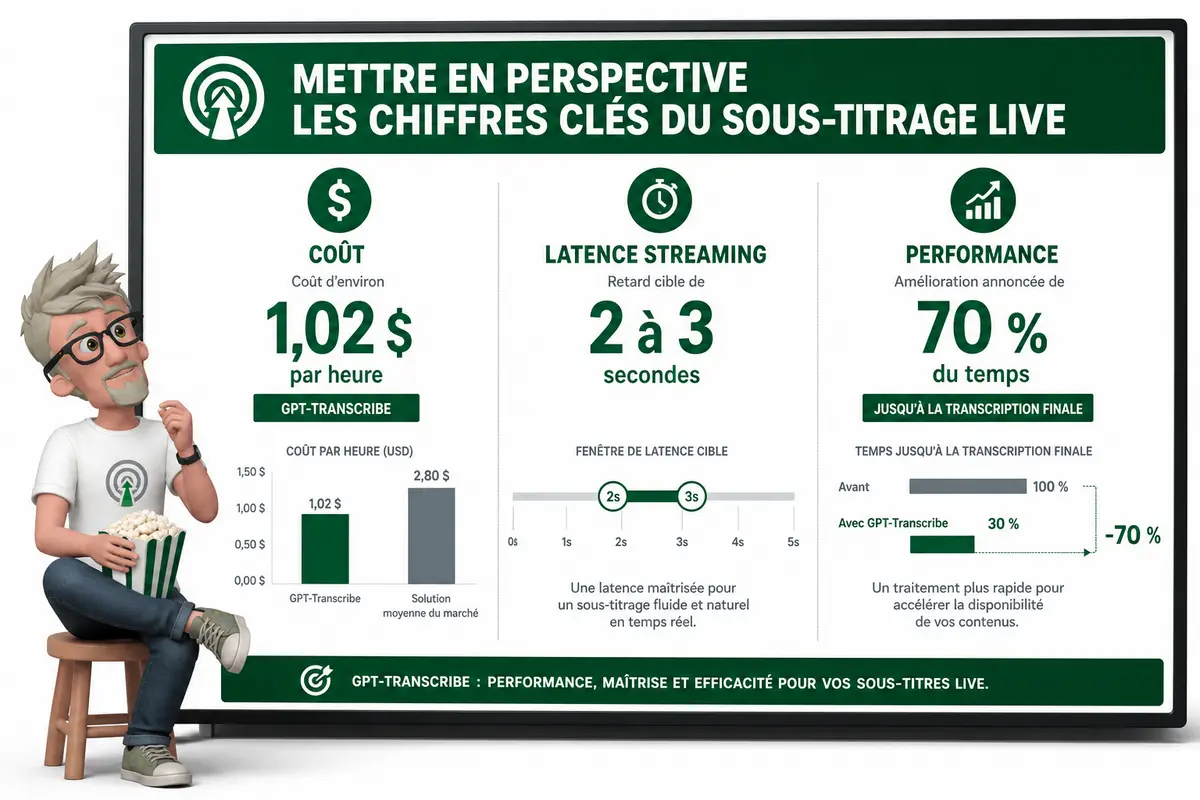
Je pense à des cas très concrets : live vidéo, webinar, événement, support client vocal, outil interne où quelqu’un parle et l’utilisateur doit lire presque tout de suite. Dans ce contexte, GPT-Transcribe annonce un tarif streaming de 0,017 $ par minute de session. C’est lisible. Pour une heure de live, on est donc autour de 1,02 $ côté transcription, hors votre infra, votre front, vos logs, et tout ce qui tourne autour.
Mais le prix minute ne suffit pas. J’ai déjà vu des systèmes “pas chers” devenir inutilisables parce que le texte arrivait par paquets, avec 4 secondes de retard, ou parce qu’une micro-coupure bloquait tout le flux. Pour du live, je regarderais surtout la stabilité, la latence, la gestion des coupures et le rendu final dans l’interface. Le modèle compte, mais l’expérience utilisateur compte autant.
Gemini annonce aussi une version streaming, avec une amélioration de 70 % du temps jusqu’à la transcription finale. C’est important, parce que plus le texte final stabilisé arrive vite, moins l’outil semble lent ou bancal. Le texte provisoire peut bouger, c’est normal. Mais si la version propre arrive trop tard, l’utilisateur perd confiance.
Côté architecture, je partirais simple, sans sur-ingénierie au début :
- Le micro capte l’audio entrant côté navigateur ou application.
- Le flux audio est envoyé au modèle streaming, par petits morceaux.
- Le backend reçoit des fragments texte provisoires.
- Le front affiche ces fragments progressivement, sans attendre la phrase parfaite.
- Si le modèle renvoie une version stabilisée, le front remplace proprement le texte précédent.
- Les erreurs sont journalisées : coupure réseau, retard, flux fermé, réponse vide.
Les tests à faire avant la mise en prod sont très terre-à-terre. C’est là qu’on voit si le produit tient vraiment.
| Test | Pourquoi c’est important | Signal d’alerte |
| Délai moyen d’affichage | L’utilisateur doit lire quasiment en temps réel. | Plus de 2 ou 3 secondes de retard régulier. |
| Bruit ambiant | Un webinar ou un support client n’est jamais parfait. | Mots inventés, phrases incohérentes, trop de blancs. |
| Reprise après coupure | Le réseau coupe, surtout en live. | Le sous-titrage ne reprend pas automatiquement. |
| Coût par heure de live | Le tarif minute doit rester viable à l’échelle. | Le coût réel dépasse largement le calcul annoncé. |
Comment choisir sans regret ?
Le bon choix se fait avec vos audios réels, pas avec une fiche produit. J’ai vu trop d’équipes choisir un modèle parce qu’une démo était propre, puis découvrir après coup que leurs vrais appels clients étaient pleins de bruit, d’accents, de silences bizarres et de jargon métier.
Je ferais simple. Je prends 20 à 50 extraits représentatifs, pas plus au départ, mais vraiment représentatifs. Des réunions internes, des appels commerciaux, des conversations support, des passages avec plusieurs locuteurs, des accents, du bruit de fond, des moments de silence, des termes métier, et plusieurs langues si votre business en dépend.
Ensuite, je compare les deux modèles sur des critères très concrets. Pas besoin d’inventer une métrique pseudo-scientifique si personne ne va l’utiliser. Je regarde le taux d’erreurs perçu, le temps de correction humaine, la facilité d’intégration, la présence des métadonnées utiles, et le coût total une fois mis en production.
| Critère | Question à se poser |
| Qualité brute | Est-ce que le texte est fiable sans trop de retouches humaines ? |
| Vocabulaire métier | Est-ce que les noms produits, acronymes et termes internes sont bien compris ? |
| Gestion des locuteurs | Est-ce que je peux savoir qui parle, et quand ? |
| Horodatages | Est-ce que les timestamps sont assez propres pour retrouver un passage rapidement ? |
| Coût | Est-ce que le prix reste acceptable avec le volume réel ? |
| Latence streaming | Est-ce que le modèle répond assez vite pour un usage en direct ? |
| Effort d’intégration | Est-ce que mon équipe peut le brancher sans bricoler pendant trois semaines ? |
À ce stade, mon avis est assez clair. Gemini semble mieux armé pour les transcriptions riches et structurées, surtout si vous avez besoin de métadonnées propres, de contexte et d’une sortie exploitable derrière. GPT-Transcribe peut être plus attractif si votre priorité, c’est le prix, le streaming, et une transcription texte simple qui suffit déjà à votre usage.
Le point à ne pas sous-estimer, c’est l’après. Si votre équipe veut alimenter un CRM, une base de connaissance, un moteur de recherche ou un workflow IA, choisissez le modèle qui sort les données les plus propres dès le départ. Sinon, vous payez la dette technique plus tard, en nettoyage, en scripts de rattrapage, et en corrections humaines.
Au fond, ce n’est pas une bataille de logo, c’est une question d’usage.
Alors, lequel je choisirais pour mon usage ?
Je choisirais Gemini 3.5 Transcribe pour les réunions, les comptes rendus structurés, les workflows IA et tout ce qui demande des locuteurs, des horodatages précis et du vocabulaire métier. Je regarderais GPT-Transcribe pour du sous-titrage live, des usages orientés coût, ou des transcriptions plus simples où le texte brut suffit.
Le point important, c’est de tester avec vos vrais audios. Pas avec une démo propre. Bruit, accents, coupures, jargon, plusieurs intervenants. C’est là qu’on voit le vrai modèle. Le bénéfice pour vous : choisir une transcription qui marche vraiment dans votre business, sans rajouter du bricolage derrière.
FAQ
- Gemini 3.5 Transcribe est-il meilleur que GPT-Transcribe ?
Gemini 3.5 Transcribe semble plus complet pour les usages structurés, surtout grâce à la diarisation, aux horodatages au mot, au vocabulaire personnalisé et aux WER annoncés plus bas. GPT-Transcribe reste intéressant si vous cherchez une transcription efficace avec un coût annoncé clair, notamment en streaming. - Quel modèle choisir pour transcrire une réunion ?
Pour une réunion avec plusieurs intervenants, je choisirais plutôt Gemini 3.5 Transcribe. La gestion fiable jusqu’à trois locuteurs, les horodatages au niveau du mot et le vocabulaire personnalisé facilitent beaucoup la création de comptes rendus, de résumés et d’actions à suivre. - GPT-Transcribe fournit-il la diarisation ?
GPT-Transcribe ne fournit pas nativement la diarisation ni les horodatages au niveau du mot. Si vous devez savoir qui parle et à quel moment exact, il faut prévoir une étape complémentaire ou choisir un modèle qui le propose directement. - Combien coûte GPT-Transcribe ?
Le tarif annoncé est de 0,0045 $ par minute pour les fichiers audio et 0,017 $ par minute de session en streaming. OpenAI annonce aussi un coût inférieur de 25 % à son prédécesseur. Le vrai calcul doit intégrer le post-traitement, la correction humaine et les fonctions manquantes selon votre usage. - Comment tester un modèle de transcription avant de l’adopter ?
Je conseille de tester les modèles sur vos vrais audios : réunions, appels, bruit, accents, jargon métier, plusieurs langues si besoin. Comparez la qualité du texte, le temps de correction, la gestion des locuteurs, les horodatages, la latence streaming et le coût total. C’est beaucoup plus fiable qu’un benchmark isolé.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Avec mon agence webAnalyste et l’organisme Formations Analytics, j’accompagne des équipes qui veulent connecter leurs données, automatiser leurs process et utiliser l’IA sans usine à gaz. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer un projet IA, transcription, data ou automatisation, contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.