


La bonne mémoire IA dépend du contexte à garder, de sa durée de vie et de la façon de le retrouver. Je vous montre comment lire les projets Mem0, Hindsight, memU, Cognee, Graphiti, OpenViking et OpenMemory sans vous perdre dans le bruit GitHub.
Pourquoi un agent IA oublie vite ?
Un agent IA oublie vite parce qu’une session ne conserve pas naturellement les faits utiles, les préférences, les relations et l’état d’une tâche d’une interaction à l’autre. C’est la différence entre un chatbot sympa et un agent vraiment utile. Le chatbot répond bien sur le moment. L’agent, lui, doit se souvenir de ce qui compte.
Le contexte immédiat, c’est ce que l’IA voit dans la conversation en cours. Les derniers messages, les consignes du prompt, quelques infos ajoutées au fil de l’échange. Ça marche tant qu’on reste dans la même session, avec peu de bruit. Dès que l’utilisateur revient demain, ou qu’il change de sujet, ou qu’on dépasse la taille de contexte, l’agent perd le fil.
Gemini 3.5 Transcribe ou GPT-Transcribe ?
La mémoire persistante, c’est autre chose. C’est une couche qui stocke, retrouve et réutilise du contexte dans le temps. Elle ne garde pas tout bêtement. Elle garde ce qui a une valeur future. J’ai vu ce problème chez un client qui voulait un agent commercial. Le bot savait très bien résumer un appel, mais il redemandait à chaque fois le secteur du client, le format de compte-rendu préféré, et la prochaine étape déjà validée. Ça casse vite la confiance.
Entre nous, on le sait bien, faire appel à un consultant en automatisation intelligente et en agent IA, c’est souvent le raccourci le plus malin. On en parle ?
Tout mettre dans le prompt n’est pas une stratégie. Au début, ça rassure. Puis on mélange les infos utiles, les détails périmés, les préférences temporaires et les vieux échanges qui n’ont plus d’intérêt. Le prompt devient une cave. On retrouve parfois quelque chose, mais on ne sait plus si c’est encore vrai.
Les souvenirs à conserver se rangent souvent dans quatre familles simples :
- Faits utiles : Le nom d’un client, son secteur, une contrainte connue, une décision déjà prise.
- Préférences utilisateur : Le format de sortie préféré, le niveau de détail, la langue, le style attendu.
- Relations entre informations : Ce client est lié à tel projet, ce contact valide le budget, cette équipe dépend de tel outil.
- État de tâche : L’étape en cours dans un workflow, ce qui a été fait, ce qui reste à valider.
Quelles erreurs Python IA faussent vos modèles ?
Mem0 sert bien cette logique de mémoire générale. Il permet de stocker et retrouver des souvenirs utilisateur ou agent entre les sessions. OpenViking joue plutôt sur le contexte persistant de l’agent, pour réutiliser son état entre interactions. Les deux répondent au même besoin de fond : éviter que l’agent reparte de zéro à chaque échange.
| Type | Rôle | Exemple |
| Contexte court terme | Garde ce qui est utile dans la conversation en cours. | Les derniers messages échangés. |
| Mémoire persistante | Conserve les souvenirs utiles entre les sessions. | Une préférence de format ou une décision déjà prise. |
| État de tâche | Suit l’avancement d’un workflow. | Une étape en attente de validation. |
Quelle mémoire pour garder l’expérience ?
Pour garder l’expérience d’un agent, il faut une mémoire capable de stocker les souvenirs importants, de les rappeler au bon moment et parfois de réfléchir sur ce qui s’est passé. Pas juste une base de données où on empile tout. Une vraie mémoire utile, c’est celle qui aide l’agent à mieux agir la prochaine fois.
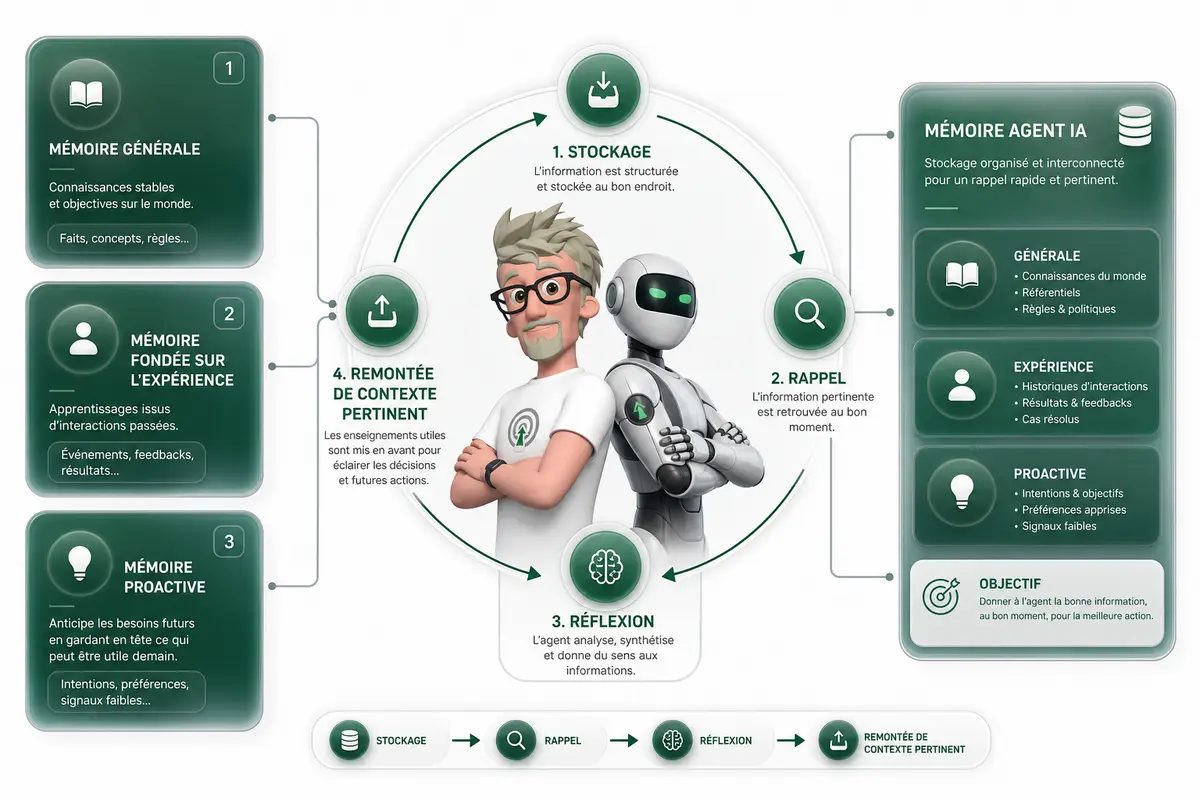
Hindsight va dans cette direction. Je le vois comme un système de mémoire à long terme centré sur le souvenir, la remémoration et la réflexion autour de l’expérience passée. L’intérêt, c’est que l’agent ne récupère pas seulement une information brute du genre “le client préfère tel format”. Il peut aussi s’appuyer sur un épisode précédent, sur ce qui a marché, ce qui a échoué, ce qui mérite d’être réutilisé.
Pourquoi choisir une architecture IA hybride ?
C’est important dès qu’on sort du simple chatbot FAQ. Un agent qui suit des tickets, qui aide à vendre, qui accompagne un utilisateur dans le temps, il doit apprendre de ses interactions. Pas apprendre au sens entraînement du modèle, plutôt apprendre au sens “je me souviens de ce contexte et je sais pourquoi il compte”.
MemU, lui, pousse une autre idée intéressante : une mémoire proactive. Une mémoire passive attend qu’on lui pose exactement la bonne question. Une mémoire proactive aide à faire remonter ce qui semble utile pour la tâche en cours. Elle organise l’expérience stockée comme une connaissance exploitable, pas comme une archive morte.
Dans la vraie vie, c’est souvent là que ça se joue. Chez les clients, le vrai sujet n’est pas de tout mémoriser, c’est de décider ce qui mérite de revenir dans la conversation. Trop de mémoire, et l’agent devient confus. Pas assez, et il répète les mêmes erreurs. Le bon niveau, c’est celui qui améliore la décision sans noyer le prompt.
| Mem0 | Couche générale de mémoire pour agents, utile pour stocker et retrouver des informations utilisateur ou contexte. | Je le regarderais en priorité si je veux ajouter rapidement une mémoire persistante à un agent. |
| Hindsight | Mémoire longue centrée sur l’expérience passée, avec une logique de souvenir, rappel et réflexion. | Je le regarderais si l’agent doit tirer parti de ce qu’il a déjà vécu, pas juste retrouver une donnée. |
| memU | Mémoire proactive orientée connaissance, qui aide à faire émerger ce qui est pertinent pour la tâche. | Je le regarderais si je veux une mémoire qui participe activement au raisonnement de l’agent. |
Quand choisir vecteurs, graphes ou temps ?
DeepSeek Harness est-il la base des agents IA ?
Les vecteurs servent à retrouver du contenu proche en sens. Les graphes servent à relier les informations entre elles. Le temps sert à éviter de traiter une vieille vérité comme une vérité actuelle. C’est vraiment la base du choix, et franchement, ça évite beaucoup d’architectures trop compliquées pour rien.
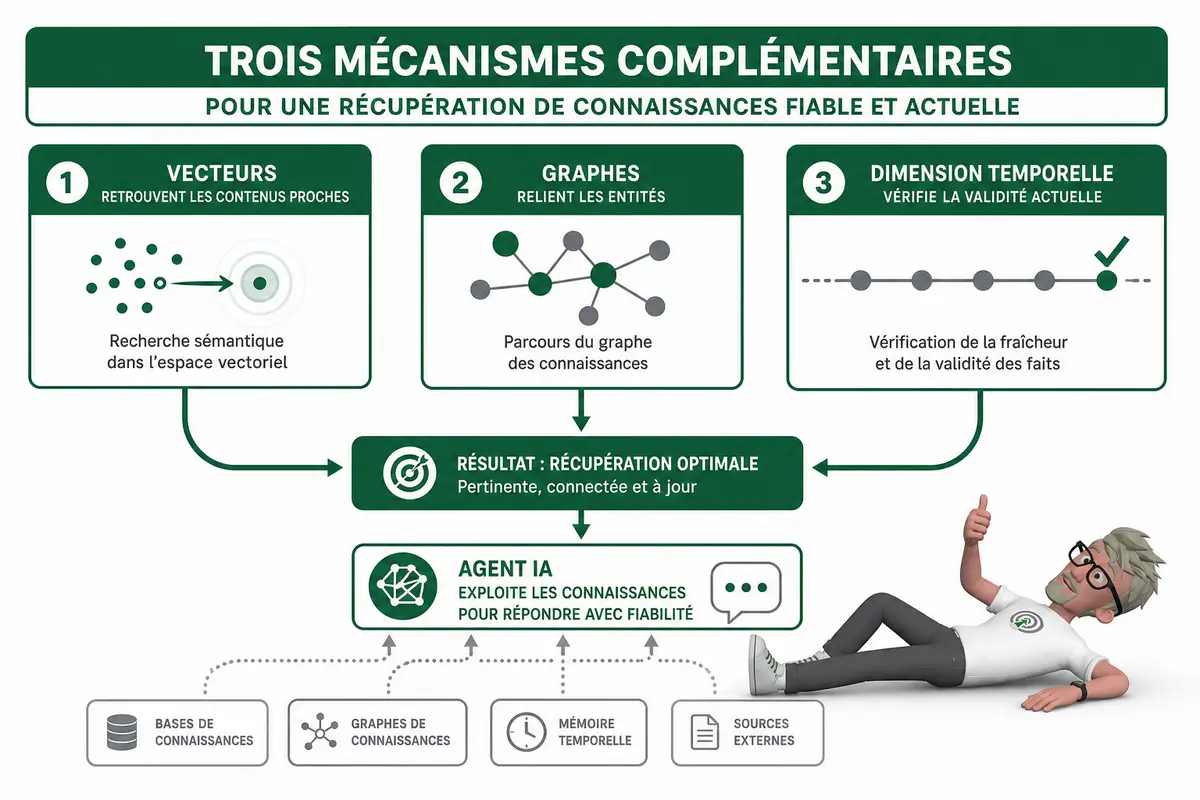
Quand j’utilise une recherche vectorielle, je cherche surtout à répondre à une question simple : “Qu’est-ce qui ressemble à ça dans ma mémoire ?”. C’est utile pour retrouver un passage dans un document, une ancienne conversation, une décision proche, même si les mots ne sont pas exactement les mêmes. Le vecteur, en gros, transforme un contenu en représentation numérique pour comparer le sens, pas juste les mots-clés.
Cognee est intéressant dans ce contexte, parce que le projet transforme des documents, du code et des conversations en mémoire connectée. Il combine recherche vectorielle et relations de graphe. Dit simplement, il ne se contente pas de stocker des morceaux de texte. Il essaie aussi de garder les liens entre les éléments. Qui parle de quoi. Quel fichier dépend de quelle fonction. Quelle discussion mentionne quelle décision. J’ai vu ce besoin arriver très vite chez des clients dès qu’on dépasse les petites préférences utilisateur du type “Réponds en français” ou “Préfère les réponses courtes”.
Graphiti va plus loin sur un autre sujet clé : le temps. C’est un graphe de connaissances temporel, donc il modélise l’évolution des faits et des relations. Et ça change tout. Un contact peut changer de rôle. Une tâche peut passer de “à faire” à “terminé”. Une règle business peut devenir obsolète après une nouvelle décision. Si l’agent ne sait pas ça, il peut répondre proprement avec une information fausse. Le pire genre d’erreur.
Je ne vois pas Cognee et Graphiti comme deux options à opposer. Dans une architecture sérieuse, on peut avoir besoin des trois couches. Les vecteurs pour retrouver. Le graphe pour comprendre les relations. La temporalité pour savoir si l’information est encore valable.
| Approche | Ce qu’elle apporte | Risque si elle manque |
| Vecteurs | Retrouver du contenu proche en sens, même avec des mots différents. | L’agent passe à côté d’informations utiles cachées dans les documents ou échanges. |
| Graphes | Comprendre les liens entre personnes, documents, décisions, code et concepts. | L’agent récupère des morceaux isolés sans comprendre le contexte. |
| Temps | Savoir si un fait, une relation ou une règle est encore valable aujourd’hui. | L’agent applique une ancienne vérité comme si elle était toujours actuelle. |
Comment garder une mémoire portable ?
Une mémoire portable permet de déplacer ou réutiliser le contexte d’un agent entre plusieurs environnements, au lieu de repartir de zéro à chaque outil. Pour un agent de codage, c’est très concret. Vous commencez une session dans un outil, l’agent comprend votre architecture, vos conventions, vos contraintes métier, puis vous changez d’environnement. Sans mémoire portable, il faut tout répéter. Avec, vous emmenez le contexte avec vous.
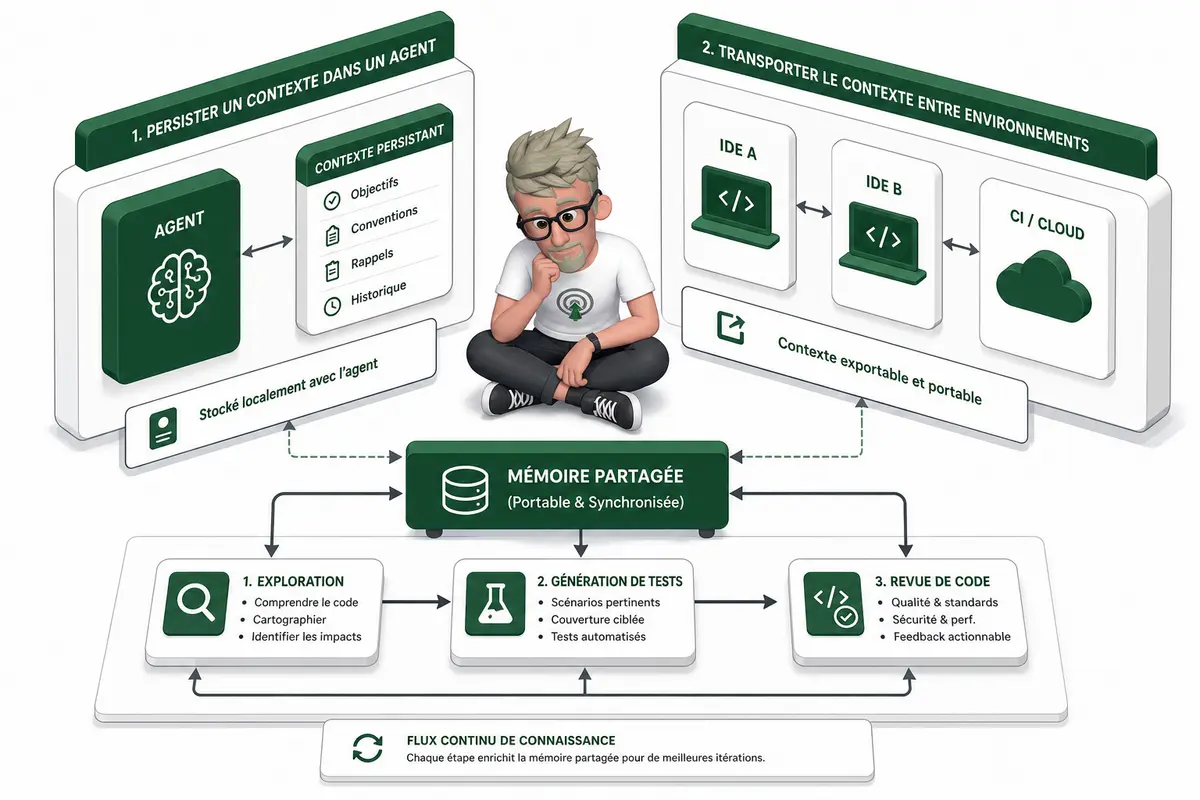
OpenMemory va dans ce sens pour les sessions de codage. L’idée, c’est d’avoir une mémoire qu’on peut importer et exporter entre différents environnements d’agent. Pas juste un historique de chat. Plutôt un contexte utile, nettoyé, réutilisable.
Dans le développement, ça évite pas mal de friction. J’ai vu ça chez un client avec plusieurs agents utilisés selon les tâches. Un pour explorer le code, un autre pour générer des tests, un autre pour relire. Le problème n’était pas l’IA. Le problème, c’était la perte de contexte entre chaque passage.
- Les contraintes du projet restent disponibles.
- Les décisions prises ne disparaissent pas au prochain outil.
- Les conventions de code suivent l’agent.
- Les fichiers déjà explorés ne sont pas redécouverts trois fois.
- L’état des tâches reste clair, même après une pause.
OpenViking est proche dans l’esprit, avec un objectif de contexte persistant pour réutiliser l’état de l’agent entre interactions. La différence est simple. Persister, c’est ne pas perdre l’état. Porter, c’est pouvoir l’emmener ailleurs. C’est comme un carnet de chantier qu’on garde à jour, mais qu’on peut aussi passer à une autre équipe sans refaire toute la visite du bâtiment.
| Persistance | Je garde l’état entre deux interactions. |
| Portabilité | Je réutilise cet état dans un autre environnement. |
Côté développeur, je raisonnerais avec un objet mémoire simple. Ce n’est pas une API réelle d’OpenMemory ou d’OpenViking, juste un modèle conceptuel neutre pour poser les bonnes cases.
// Objet mémoire conceptuel, indépendant de tout outil réel
memoire_agent = {
  contexte: "Architecture du projet, objectif fonctionnel, contraintes connues",

  decisions: [
    "Utiliser une couche service séparée",
    "Ne pas modifier le schéma de base sans validation"
  ],

  fichiers_concernes: [
    "src/api/orders.js",
    "src/services/pricing.js",
    "tests/pricing.test.js"
  ],

  etat_tache: {
    statut: "En cours",
    prochain_point: "Ajouter les tests sur les cas limites",
    points_bloquants: ["Règle métier de remise à confirmer"]
  },

  derniere_mise_a_jour: "2026-09-30"
}
Le bon réflexe, c’est de ne pas tout mémoriser. Je garde ce qui aide l’agent à reprendre le travail sans bruit. Une mémoire portable utile, c’est une mémoire qu’un autre agent peut relire vite et exploiter sans deviner.
Comment assembler ces projets sans se tromper ?
Je ne choisis jamais une mémoire IA parce qu’un projet a l’air cool sur GitHub. Je pars du problème mémoire à résoudre. Est-ce que l’agent doit se souvenir d’un utilisateur entre deux sessions ? Est-ce qu’il doit apprendre de ses expériences passées ? Est-ce qu’il doit connecter des documents, du code et des conversations ? Est-ce qu’il doit suivre l’évolution d’un fait dans le temps ? Est-ce qu’il doit transporter son contexte d’un environnement à un autre ? Ce ne sont pas les mêmes besoins, donc ce ne sont pas les mêmes outils.
La bonne approche, c’est de découper la mémoire en fonctions simples. Un agent sérieux n’a pas “une mémoire”. Il a souvent plusieurs couches qui travaillent ensemble.
- Mem0 me paraît adapté quand je veux une couche générale de souvenirs entre sessions, avec des préférences utilisateur, des habitudes, des informations utiles à réinjecter plus tard.
- Hindsight devient intéressant quand je veux travailler sur l’expérience passée, la réflexion, le retour sur ce qui a marché ou pas.
- memU est utile quand je veux une mémoire proactive, mieux organisée en connaissance exploitable, pas juste une pile de souvenirs.
- Cognee sert quand je dois relier documents, code, conversations et connaissances internes dans une structure exploitable par l’agent.
- Graphiti est à regarder quand les faits changent, avec des relations qui évoluent dans le temps. Typiquement, “Paul travaille chez X” peut être vrai aujourd’hui, faux demain.
- OpenViking aide quand je veux garder un contexte persistant, surtout sur des workflows longs.
- OpenMemory est pratique pour déplacer le contexte de codage entre plusieurs environnements, IDE ou assistants.
Ces projets ne s’excluent pas forcément. Une mémoire durable peut combiner du stockage, de la récupération, des relations, de la temporalité et de la portabilité. Le vrai sujet en production, ce n’est pas d’avoir “beaucoup de mémoire”. C’est d’avoir de bons souvenirs, frais, retrouvés au bon moment, sans polluer l’agent avec du contexte inutile. J’ai vu des agents devenir moins bons juste parce qu’on leur donnait trop d’historique mal filtré. La mémoire, mal gérée, c’est du bruit avec un joli nom.
| Besoin | Projet à regarder | Raison |
| Souvenir utilisateur entre sessions | Mem0 | Stocker et retrouver des préférences, habitudes et infos utiles. |
| Apprentissage par expérience passée | Hindsight | Travailler la réflexion, les retours d’expérience et l’amélioration. |
| Mémoire proactive structurée | memU | Organiser les souvenirs en connaissance activable. |
| Connexion documents, code et conversations | Cognee | Relier plusieurs sources dans une mémoire exploitable. |
| Faits et relations qui changent dans le temps | Graphiti | Gérer la temporalité et l’évolution des relations. |
| Contexte persistant sur workflows longs | OpenViking | Conserver un contexte stable au fil des sessions. |
| Portabilité du contexte de codage | OpenMemory | Déplacer le contexte entre outils et environnements. |
Avant de brancher un outil, je définis toujours ce que l’agent doit se rappeler, ce qu’il doit oublier, et ce qu’il doit vérifier avant de réutiliser.
La vraie question est ce que votre agent doit retenir
La mémoire IA n’est pas un gadget pour rendre un agent plus impressionnant. C’est ce qui lui permet de garder les bons faits, les préférences, les relations et l’état d’une tâche quand la session est finie. Mem0, Hindsight, memU, Cognee, Graphiti, OpenViking et OpenMemory montrent chacun une pièce du sujet : souvenir, réflexion, connaissance, graphe, temps, persistance et portabilité. Mon conseil reste simple : partez du besoin mémoire, pas du repo GitHub le plus séduisant. Vous gagnerez des agents plus cohérents, plus utiles, et surtout capables de réutiliser le bon contexte au bon moment.
FAQ
- Qu’est-ce qu’une mémoire IA pour agent ?
Une mémoire IA permet à un agent de conserver et de réutiliser du contexte entre plusieurs interactions. Elle peut garder des faits utiles, des préférences, des relations entre informations ou l’état d’une tâche. Sans cette couche, l’agent dépend surtout du contexte immédiat de la session. - Pourquoi un agent IA a besoin d’une mémoire persistante ?
Parce qu’un agent utile ne doit pas redemander les mêmes informations ni oublier les décisions déjà prises. La mémoire persistante aide à garder une continuité entre les sessions, surtout quand l’agent suit un projet, un utilisateur ou un workflow dans la durée. - Quelle différence entre mémoire vectorielle et mémoire graphique ?
La mémoire vectorielle aide à retrouver des contenus proches en sens. La mémoire graphique aide à comprendre les relations entre les éléments. Les deux approches peuvent se compléter quand un agent doit retrouver une information puis comprendre comment elle se relie au reste. - À quoi sert une mémoire temporelle comme Graphiti ?
Une mémoire temporelle sert à suivre l’évolution des faits et des relations dans le temps. C’est important quand une information peut changer : un statut de tâche, une relation entre personnes, une règle business ou une décision projet. - Quel projet regarder en premier pour créer une mémoire IA ?
Je partirais du besoin. Mem0 si vous cherchez une couche générale de mémoire, Hindsight pour l’expérience long terme, memU pour une mémoire proactive, Cognee pour relier documents et conversations, Graphiti pour la dimension temporelle, OpenViking pour la persistance de contexte, OpenMemory pour la portabilité en codage.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des entreprises sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA, le SEO et le GEO. J’ai travaillé pour des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez structurer vos données, vos automatisations ou vos agents IA avec une vraie logique business, je peux vous aider. Contactez-moi.

⭐ Data Analyst, Analytics Engineer et expert dans l’automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking propre RGPD, entrepôt de données (GTM server, BigQuery…), modèles (dbt/Dataform), dashboards décisionnels (Looker, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, Make, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.